02-工具调用
02-工具调用
06-Function Calling与Tool Use
前四篇里,我们把 Agent 是什么、由什么组成、怎么从零实现讲清楚了,也讨论了什么时候应该用 Agent。
对于大部分读者来说,可能都没有开发过Agent产品,甚至只用过Claude Code、Codex这类编程Agent,其他Agent产品了解很少。
这对于后面学习Agent开发的相关技术,非常不利。如果连这些技术的应用场景、要解决什么问题,都不清楚,那么,谈何深入理解技术。
因此,在正式开始讲解工具调用、分层记忆、上下文工程、Runtime、架构模式等等之前,我们先来看下,一个典型的Agent产品长什么样子。
本节课我们聚焦一个具体场景:设计一个差旅助手 Agent。通过这个产品,把 Agent 的典型交互形态和典型功能需求讲清楚。
这个例子会贯穿整个课程,后面每讲一项技术,我们都会回到这个案例里,看它到底解决了差旅助手的哪一个需求。
一、差旅助手要解决什么问题
差旅助手面向的是需要频繁出差的员工。这个场景的痛点很具体。
一个员工要出差,通常需要做这些事:查公司的差旅标准(什么职级能坐什么舱位、酒店住宿上限是多少)、安排行程、搜索符合标准的航班和酒店、比价、预订、保存行程单、回来后报销。这些步骤分散在多个系统里,员工需要来回切换,反复填写相同的信息。
差旅助手的目标,是让员工用对话的方式完成从“我要去深圳出差”到“行程已预订”的全过程。员工只需要描述需求,剩下的搜索、比价、政策校验、预订执行,都由 Agent 来完成。
对于差旅助手这样一个产品,摆在设计者面前的第一个架构选择是:它应该作为一个原生 Agent 来构建,还是嵌入到企业已有的系统里?
要回答这个问题,先得把“原生”和“嵌入”这两个概念的含义讲清楚。
嵌入已有系统的 Agent,可以理解成“给现有产品加一个 AI 模块”。企业已经有一套 OA 系统,员工在上面提交出差申请、查看审批进度、填写报销单。现在要加差旅助手,做法是在 OA 系统里挂一个对话框入口,用户在对话框里说需求,Agent 调用 OA 系统已有的接口去完成操作。Agent 是作为一个功能增强层存在的,底下的数据结构、权限体系、业务流程都没有变。
原生 Agent 则反过来,差旅助手不是某个功能模块,它本身就是一个完整的对话式产品。用户打开它就能完成从需求描述到行程预订的全过程,Agent 直接对接差旅政策库、航班搜索接口、酒店搜索接口、预订系统、审批流,自己管理对话状态和任务执行。
那么,差旅助手应该选哪条路线?
判断的标准可以归结为一个问题:Agent 在你的产品中是“功能”还是“核心”。
如果企业的核心诉求是在现有 OA 系统里增加一个便捷的出差申请入口,员工可以通过对话快速填写申请单、查询审批进度,那么嵌入已有系统的路线更合适。开发成本低,上线快,不需要重建一套权限和流程体系。
但如果企业的核心诉求是让 Agent 真正替代员工完成差旅安排的全过程:搜索、比价、政策校验、预订、变更、报销,那么这个 Agent 需要深度对接差旅政策库、航司 API、酒店 API、审批引擎、财务系统。
这些系统分散在不同部门,接口标准不统一,权限模型各异。在这种复杂度下,嵌入已有系统的路线会很快碰到宿主系统接口能力的天花板,而原生 Agent 路线虽然前期投入更大,但后续的扩展空间也更大。
当然,选择原生路线不意味着所有东西都要从零造。差旅助手仍然需要对接企业已有的差旅政策库、调用航司和酒店的 API、接入企业的审批流。原生指的是 Agent 本身的运行架构是独立完整的,而不是说它不依赖任何外部系统。这些外部系统通过工具调用的方式接入,后面讲工具调用的时候会详细展开。
不管是原生Agent还是嵌入已有系统的Agent,只是产品形态的不同,底层用到的技术,比如工具调用、分层记忆、上下文工程等等,都是一样的。
二、差旅助手的产品交互形式
在讨论差旅助手的交互形态之前,我们先看一个已经在实践中被验证过的 Agent 产品:Claude Code。
Claude Code 本质上是一个编码 Agent (垂直领域的Agent),用户通过对话框告诉它要改什么代码、修什么 bug,它在本地环境中执行文件读写、运行命令、搜索代码等操作。
虽然它的使用场景和差旅助手完全不同,但它的对话框内的交互设计,对任何其他 Agent 产品都有参考价值。
这里要注意的是,虽然都是对话框,但是,垂直Agent的对话框,跟ChatGPT、DeepSeek这类聊天助手的对话框是不同的。
垂直Agent的对话框只是用户的输入入口,它所承载的功能远不止有文字聊天这么简单。
借鉴Claude Code,用户和差旅助手的交互入口,我们也选择对话框。
员工不需要学习新界面,打开就能用自然语言描述需求。而且差旅需求本身就很适合用自然语言表达。“下周三去深圳,待三天,帮我看看合适的航班和酒店”,这句话用表单填写反而更麻烦。
但纯文字对话不够用。差旅场景涉及大量结构化信息和关键决策点,如果全部靠文字来交流,效率很低,还容易出错。
所以,对话框内需要支持几种非文字的交互组件,你可以对比Claude Code。
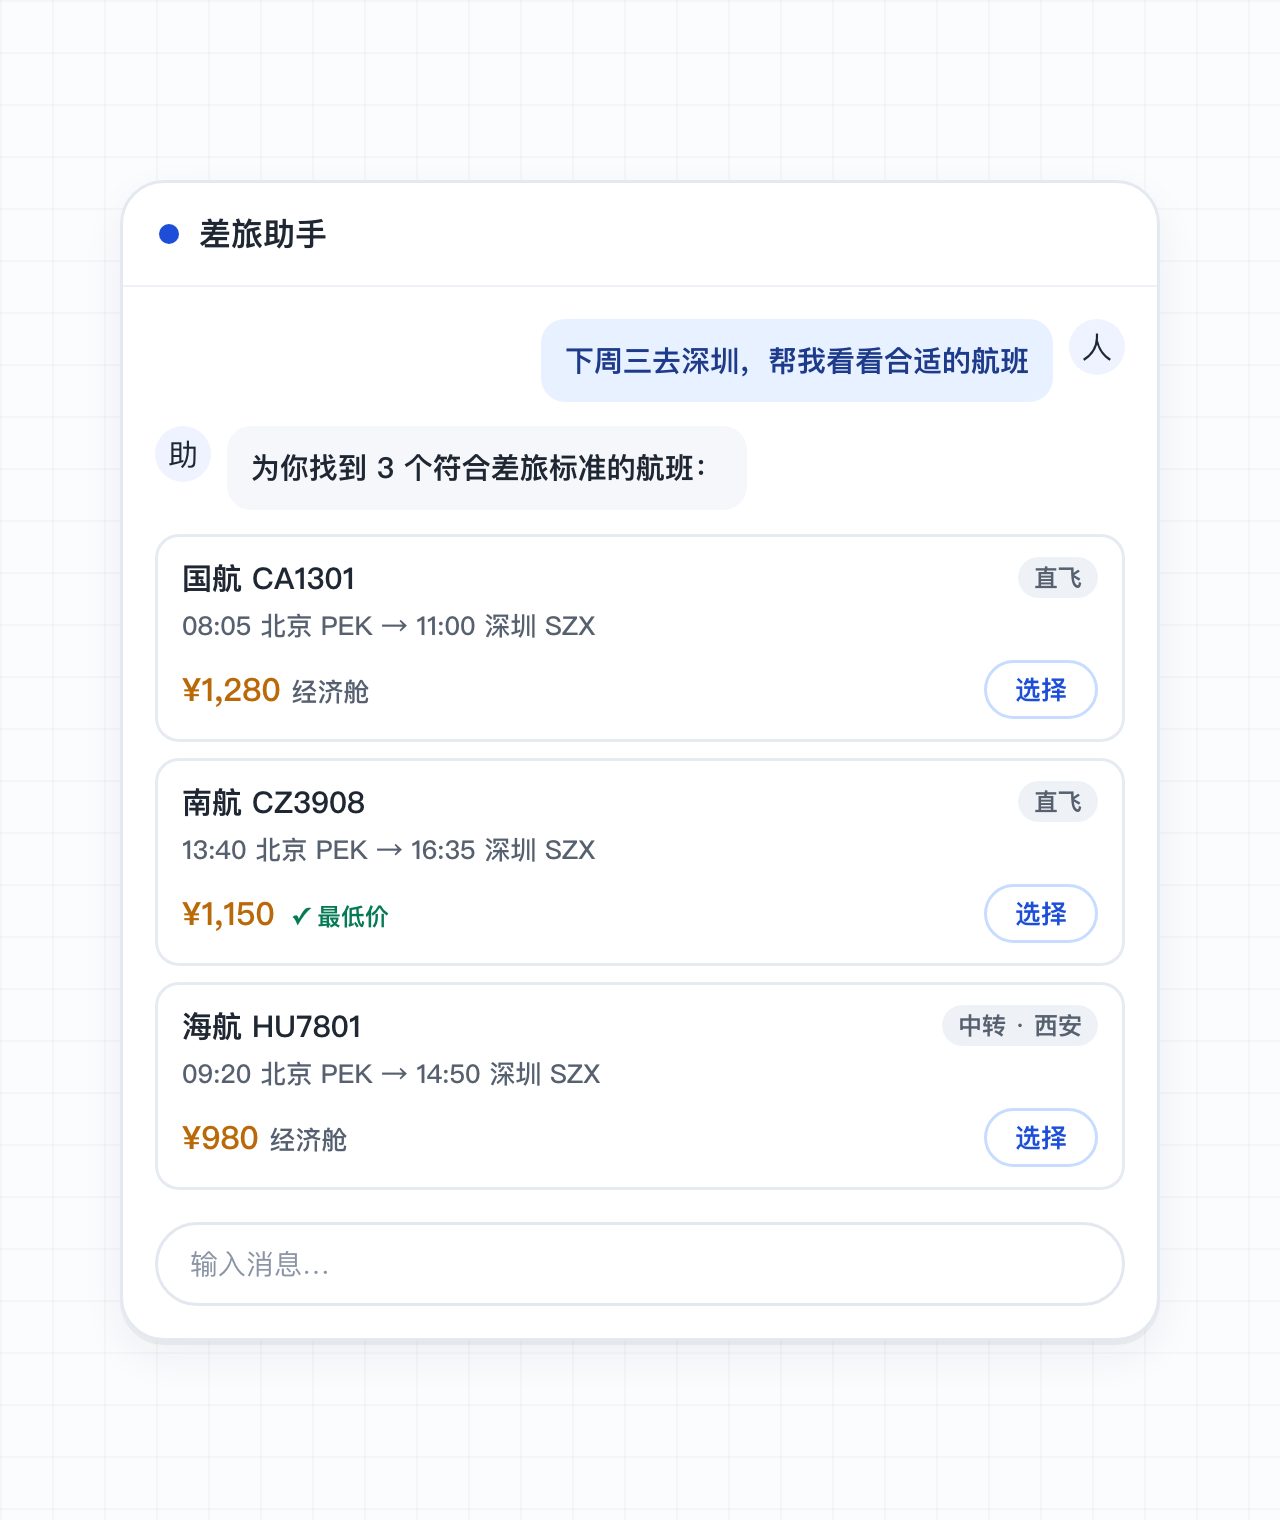
交互卡片。 当 Agent 搜索到多个航班选项后,它不应该用文字罗列,而是弹出一张航班列表卡片,每个选项显示时间、价格、航司、是否直飞,用户直接点选。酒店选项同理。这种卡片让用户做选择时一目了然,不需要在文字里来回翻找。
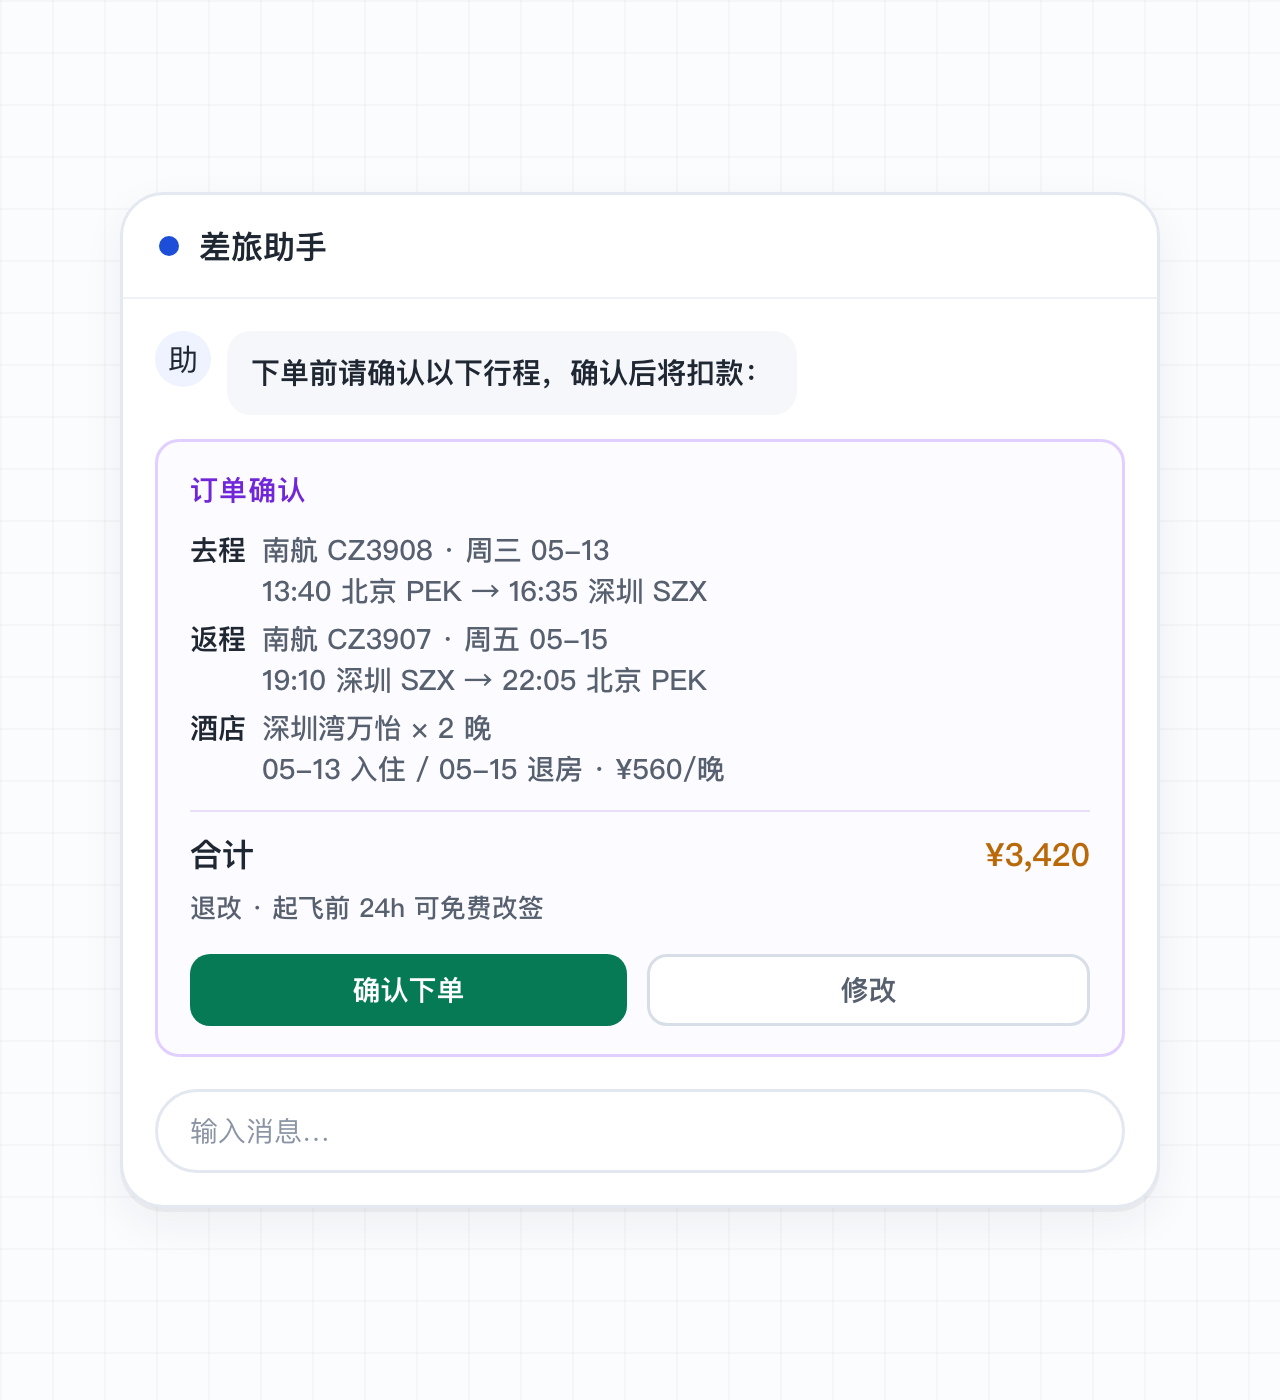
权限确认。 查航班、查政策这些只读操作,助手可以自己做。但真正下单订票、改签、退票,这些花钱而且不可逆的操作,必须停下来让用户确认。拿下单举例,在正式下单之前,Agent 必须弹出一张确认卡片,完整展示行程摘要:航班信息、酒店信息、总价、退改政策,用户点击确认后才执行下单。
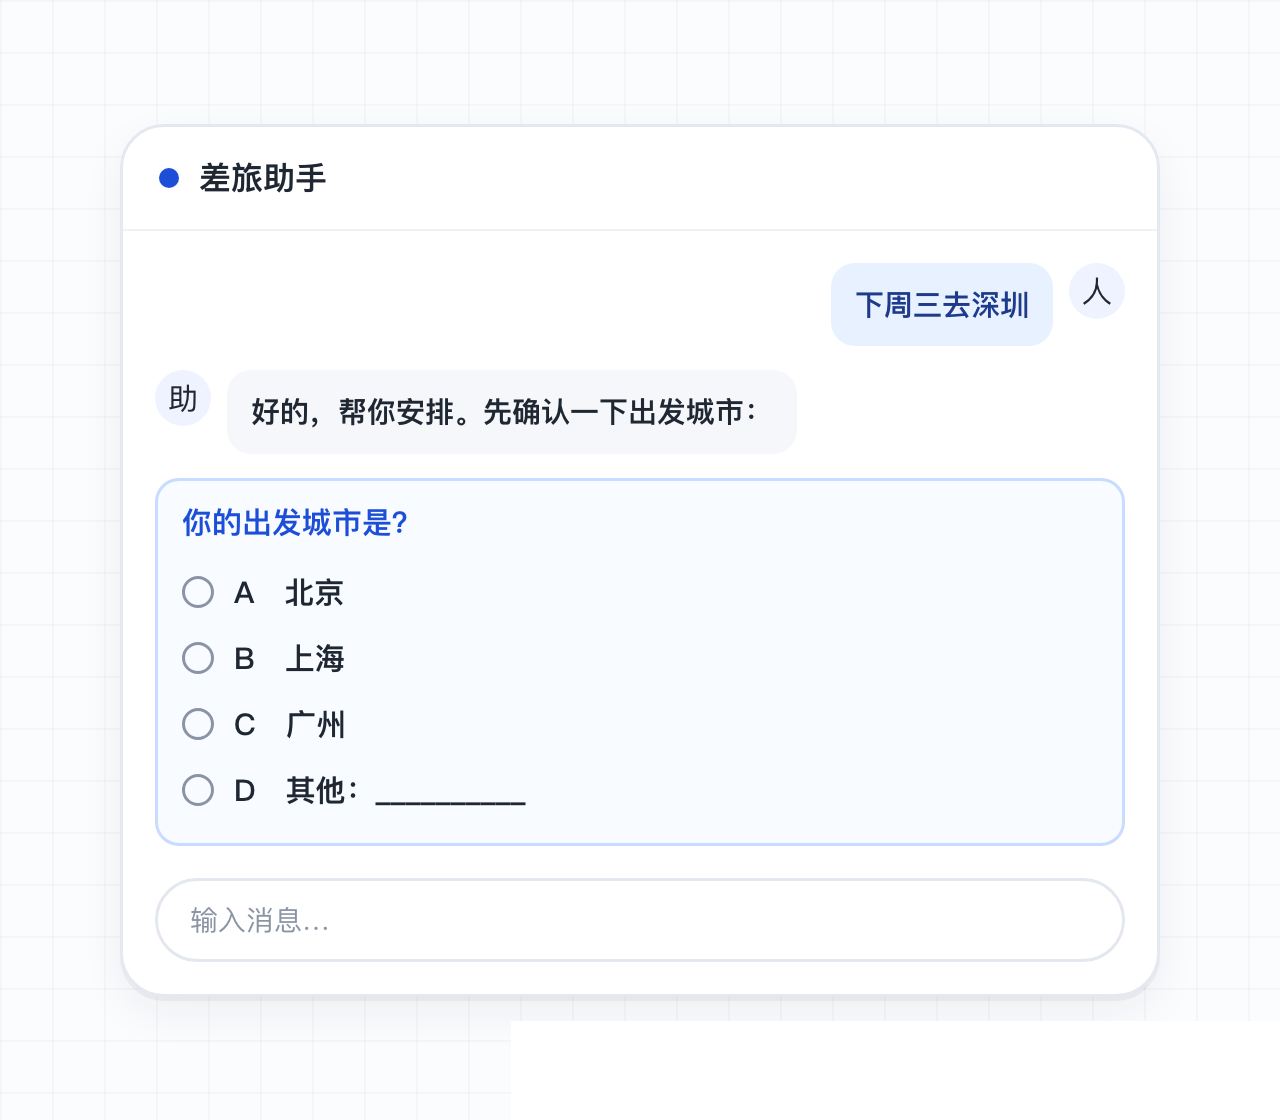
需求澄清。 用户说“下周三去深圳”,这句话缺少出发城市、具体日期、偏好舱位等信息。Agent 不应该靠猜,而应该用选择题卡片的方式追问。比如:“你的出发城市是哪里?A 北京 B 上海 C 广州 D 其他___”,用户点选或者填写即可。这种结构化澄清比反复文字对话高效得多。
进度展示。 搜索航班和酒店需要时间。Agent 应该流式展示当前在做什么,比如 “正在搜索北京到深圳的航班……”,让用户知道系统在工作,而不是面对一个静止的界面。
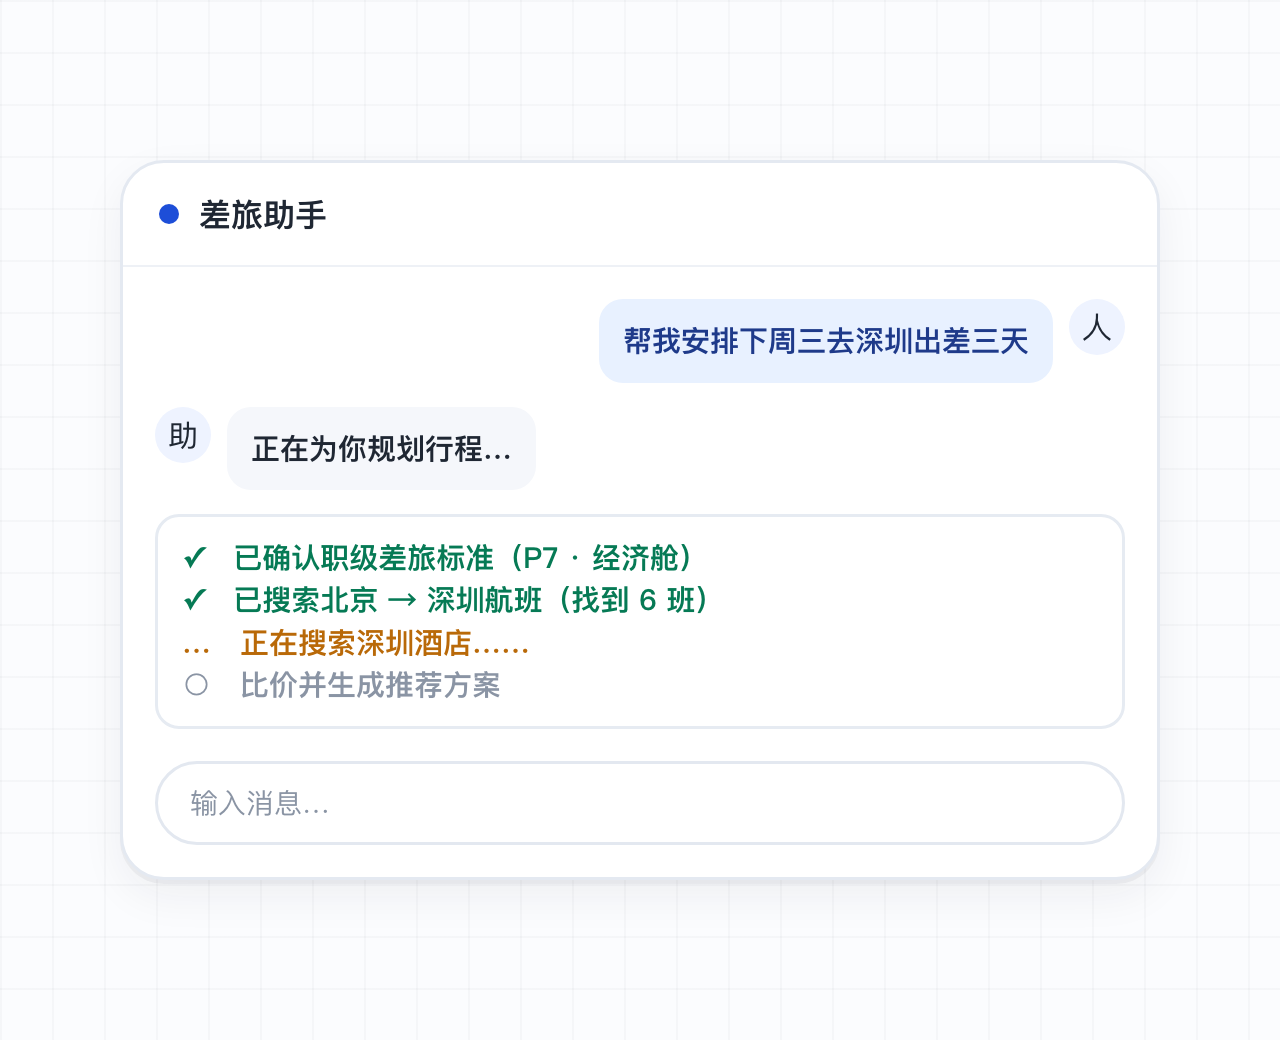
中断和回滚。 用户在任何时候都应该能取消当前操作。如果 Agent 正在搜索,用户可以说“算了,先不订了”,或者直接点击停止按钮,Agent 应该立即停止并回到初始状态。
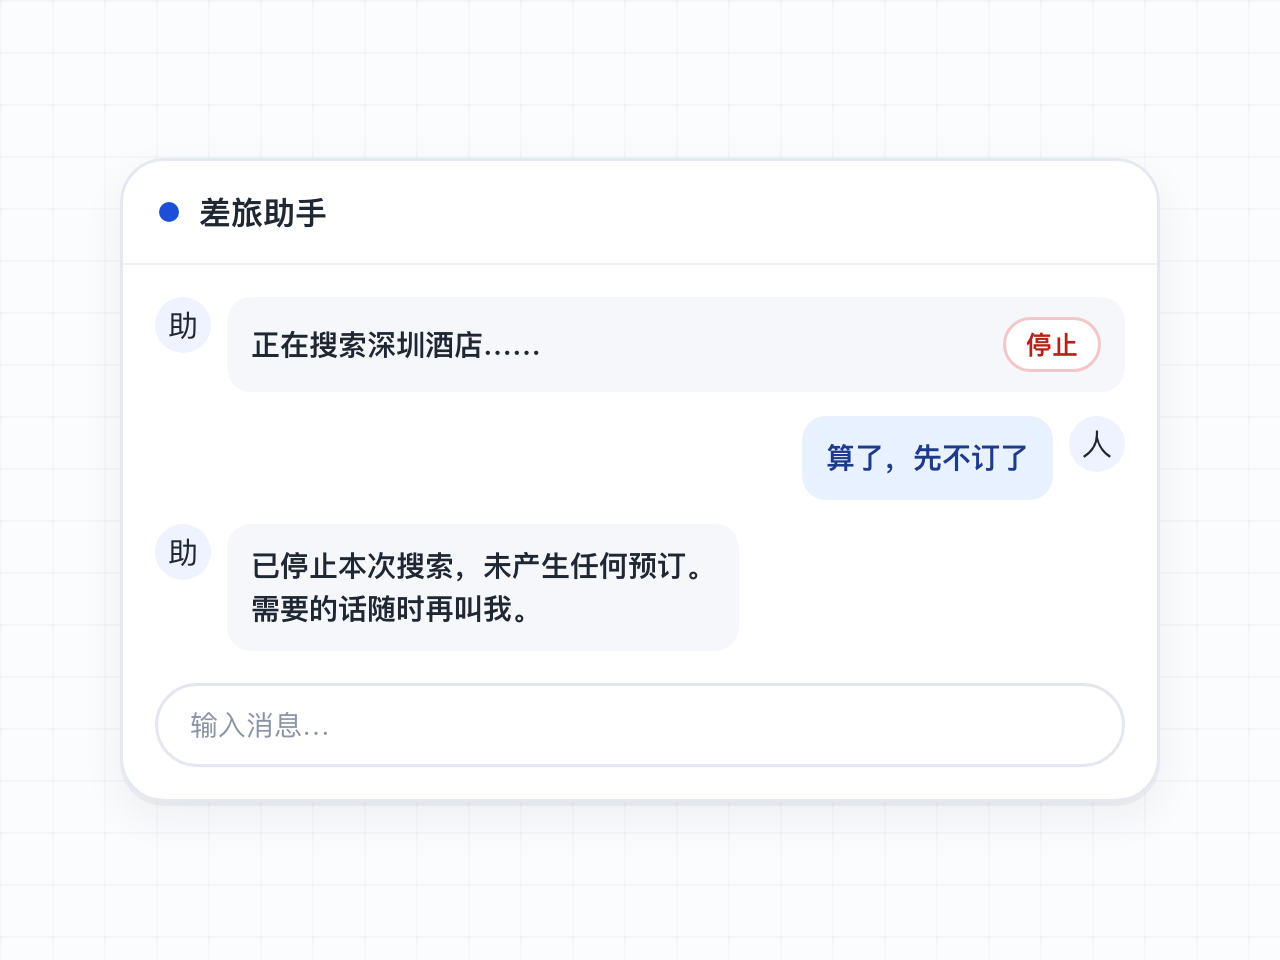
这些交互设计的共同目标可以概括为一句话:让 Agent 的自主性变得可观察、可干预、可信任。
三、差旅助手应该具备哪些能力
交互形态确定之后,接下来要梳理功能需求。
下面这份清单,覆盖了差旅助手从理解需求到完成预订的完整流程。
每一条功能背后,都对应着后面要讲的技术问题。
下面功能罗列中,我们会稍微提到一些后面才讲到的技术名词,这里你能看懂就看,看不懂就略过,等后面学到了,再回过头来再读一遍。
1. 理解用户意图
虽然我们的Agent的功能是差旅助手,但是,对于一个开放的对话框,你无法想象到用户会说出什么话、提出什么问题、布置什么任务。
【闲聊 / 寒暄】
  “在吗?”
  “今天天气真好,适合出差哈哈”
  “你是什么模型做的呀?”

【咨询政策】
  “我是 P7,出差能坐商务舱吗?”
  “深圳出差住宿一晚最多能报多少?”
  “高铁和飞机都能选的话,公司有什么限制?”

【简单查询】
  “明天北京到上海有哪些早班航班?”
  “我上周那张去广州的机票订单号是多少?”
  “查一下我这个月已经出差几次了。”

【复杂任务】
  “帮我安排下周三去深圳出差三天,订往返机票和酒店,要靠窗、离客户公司近一点。”
  “把原定周五回北京的航班改签到周六下午,顺便延住一晚。”
  “这次深圳出差的机票、酒店、打车发票都整理好,帮我提交报销。”
如果靠一套逻辑处理所有的需求,那么,这套逻辑的复杂程度将无法想象。因此,为了解耦,我们要先做意图识别,然后,将需求路由到不同的子Agent来处理。
每个子Agent负责一件事情,这样上下文不会过多而稀释模型注意力、工具列表也不会太多导致模型选错工具、Runtime 也不会过于复杂(这些都在后面会讲到,这里不懂没关系),任务执行的准确率、完成率就会提高很多。
2. 收集和确认需求
判断出意图之后,Agent 需要收集完成这个任务所需的参数。
订机票需要出发地、目的地、日期、舱位偏好;订酒店需要城市、入住日期、退房日期、酒店品牌偏好、价格上限。
用户第一次说的话通常不完整。Agent 需要记住已经收集到的信息,识别出还缺哪些参数,然后主动追问。这个过程中,短期记忆负责记住当前对话中已经确认的信息,避免重复询问。需求澄清机制负责在信息不足时向用户提问,而不是靠猜测。
3. 查询企业差旅政策
企业员工出差,必须符合公司的差旅标准。比如:P6 职级可以坐经济舱,P7 可以坐超级经济舱,住宿标准是每晚不超过 600 元。这些政策通常写在公司的差旅制度文档里,格式可能是 PDF、Word 或网页。
Agent 需要根据用户的职级和行程信息,从这些文档中检索出适用的条款。这就是 RAG(检索增强生成) 要解决的问题。
4. 搜索航班和酒店
差旅助手需要调用外部 API 来搜索航班和酒店。这就是工具调用。
Agent 需要知道有哪些工具可用、每个工具需要什么参数、返回结果怎么解析。
工具调用不是简单地发一个 HTTP 请求。Agent 需要处理 API 超时、返回空结果、参数校验失败等各种异常情况。
5. 记住用户偏好
一个员工经常出差,他的偏好是稳定的:喜欢靠窗座位、偏好某家航空公司的航班、习惯住某个品牌的酒店、通常从哪个机场出发。
如果每次都要重新询问这些信息,体验会很差。
短期记忆负责当前对话,长期记忆负责跨对话的用户画像。两者如何分层、如何存储、如何检索,是后面「分层记忆」模块要讲的重点。
6. 制定行程方案
用户说“帮我安排下周去深圳出差三天”,这个请求包含多个子任务:订往返机票、订三晚酒店、可能还需要接送机。
Agent 需要把这些子任务拆解成一个可执行的计划,然后逐步完成。
这就是 Plan-And-Execute 架构的典型场景。Agent 先制定一个完整的计划,然后按步骤执行。在执行过程中,如果某个步骤失败了,比如某个航班没座位了,它需要重新规划。
除此之外,Reflection 机制让 Agent 能够检查自己的执行结果,发现不合理的地方并修正。这些都是「Agent架构模式」模块要讲的内容。
7. 执行预订
搜索和预订是两回事。搜索是只读操作,预订是有副作用的操作,涉及支付和订单创建。
Agent 在执行预订之前,必须让用户确认。确认之后,调用预订接口,处理可能的失败,座位被占、价格变动、支付失败。
权限确认机制要确保每笔预订都经过用户明确授权。如果预订失败,Agent 需要根据错误类型决定是重试、换方案还是转人工。
这些都是「Runtime」模块要讲的内容。
8. 管理多轮对话的上下文
差旅助手的对话可能很长。用户可能先问政策,再搜航班,然后对比酒店,最后才决定预订。这中间穿插着澄清、确认、取消等操作。Agent 需要在整个过程中保持对上下文的准确理解。
上下文窗口是有限的。当对话历史超过模型能处理的长度时,Agent 需要决定哪些信息保留、哪些信息摘要、哪些信息丢弃。这就是上下文工程要解决的问题。它直接影响 Agent 在长对话中的表现。
9. 复杂任务的协作
一个“帮我安排下周去深圳出差”的请求,可能同时涉及机票、酒店、接送机、差旅审批。如果用一个 Agent 来处理所有事情,它的 Prompt 会变得很长,注意力会被稀释,准确率会下降。
Multi-Agent 架构把复杂任务拆给多个专门的 Agent:一个负责意图识别和路由,一个负责航班搜索,一个负责酒店搜索,一个负责政策校验,一个负责预订执行。每个 Agent 只关注自己那部分上下文,准确率更高,也更容易维护。
四、功能需求对应后面要讲的技术
把上面的功能清单整理一下,可以看到差旅助手这个产品涉及的技术点非常密集。
- 理解用户想干什么 → 意图识别
- 从差旅政策文档中找到适用条款 → RAG
- 搜索航班、酒店、执行预订 → 工具调用
- 记住当前对话和用户偏好 → 分层记忆(短期记忆、长期记忆)
- 管理长对话,不丢失关键信息 → 上下文工程
- 工具调用超时、失败、任务取消、权限确认 → Runtime
- 多步骤任务拆解和执行 → Plan-And-Execute
- 检查执行结果,发现错误并修正 → Reflection
- 搜索失败后调整策略重试 → ReAct
- 复杂任务拆给多个专门 Agent → Multi-Agent
- ......
这些技术不是孤立的概念,它们是为了解决Agent产品中的具体问题而存在的。后面几篇,我们会逐个展开,讲清楚每个技术解决什么问题、怎么实现、有哪些工程细节和踩坑教训。
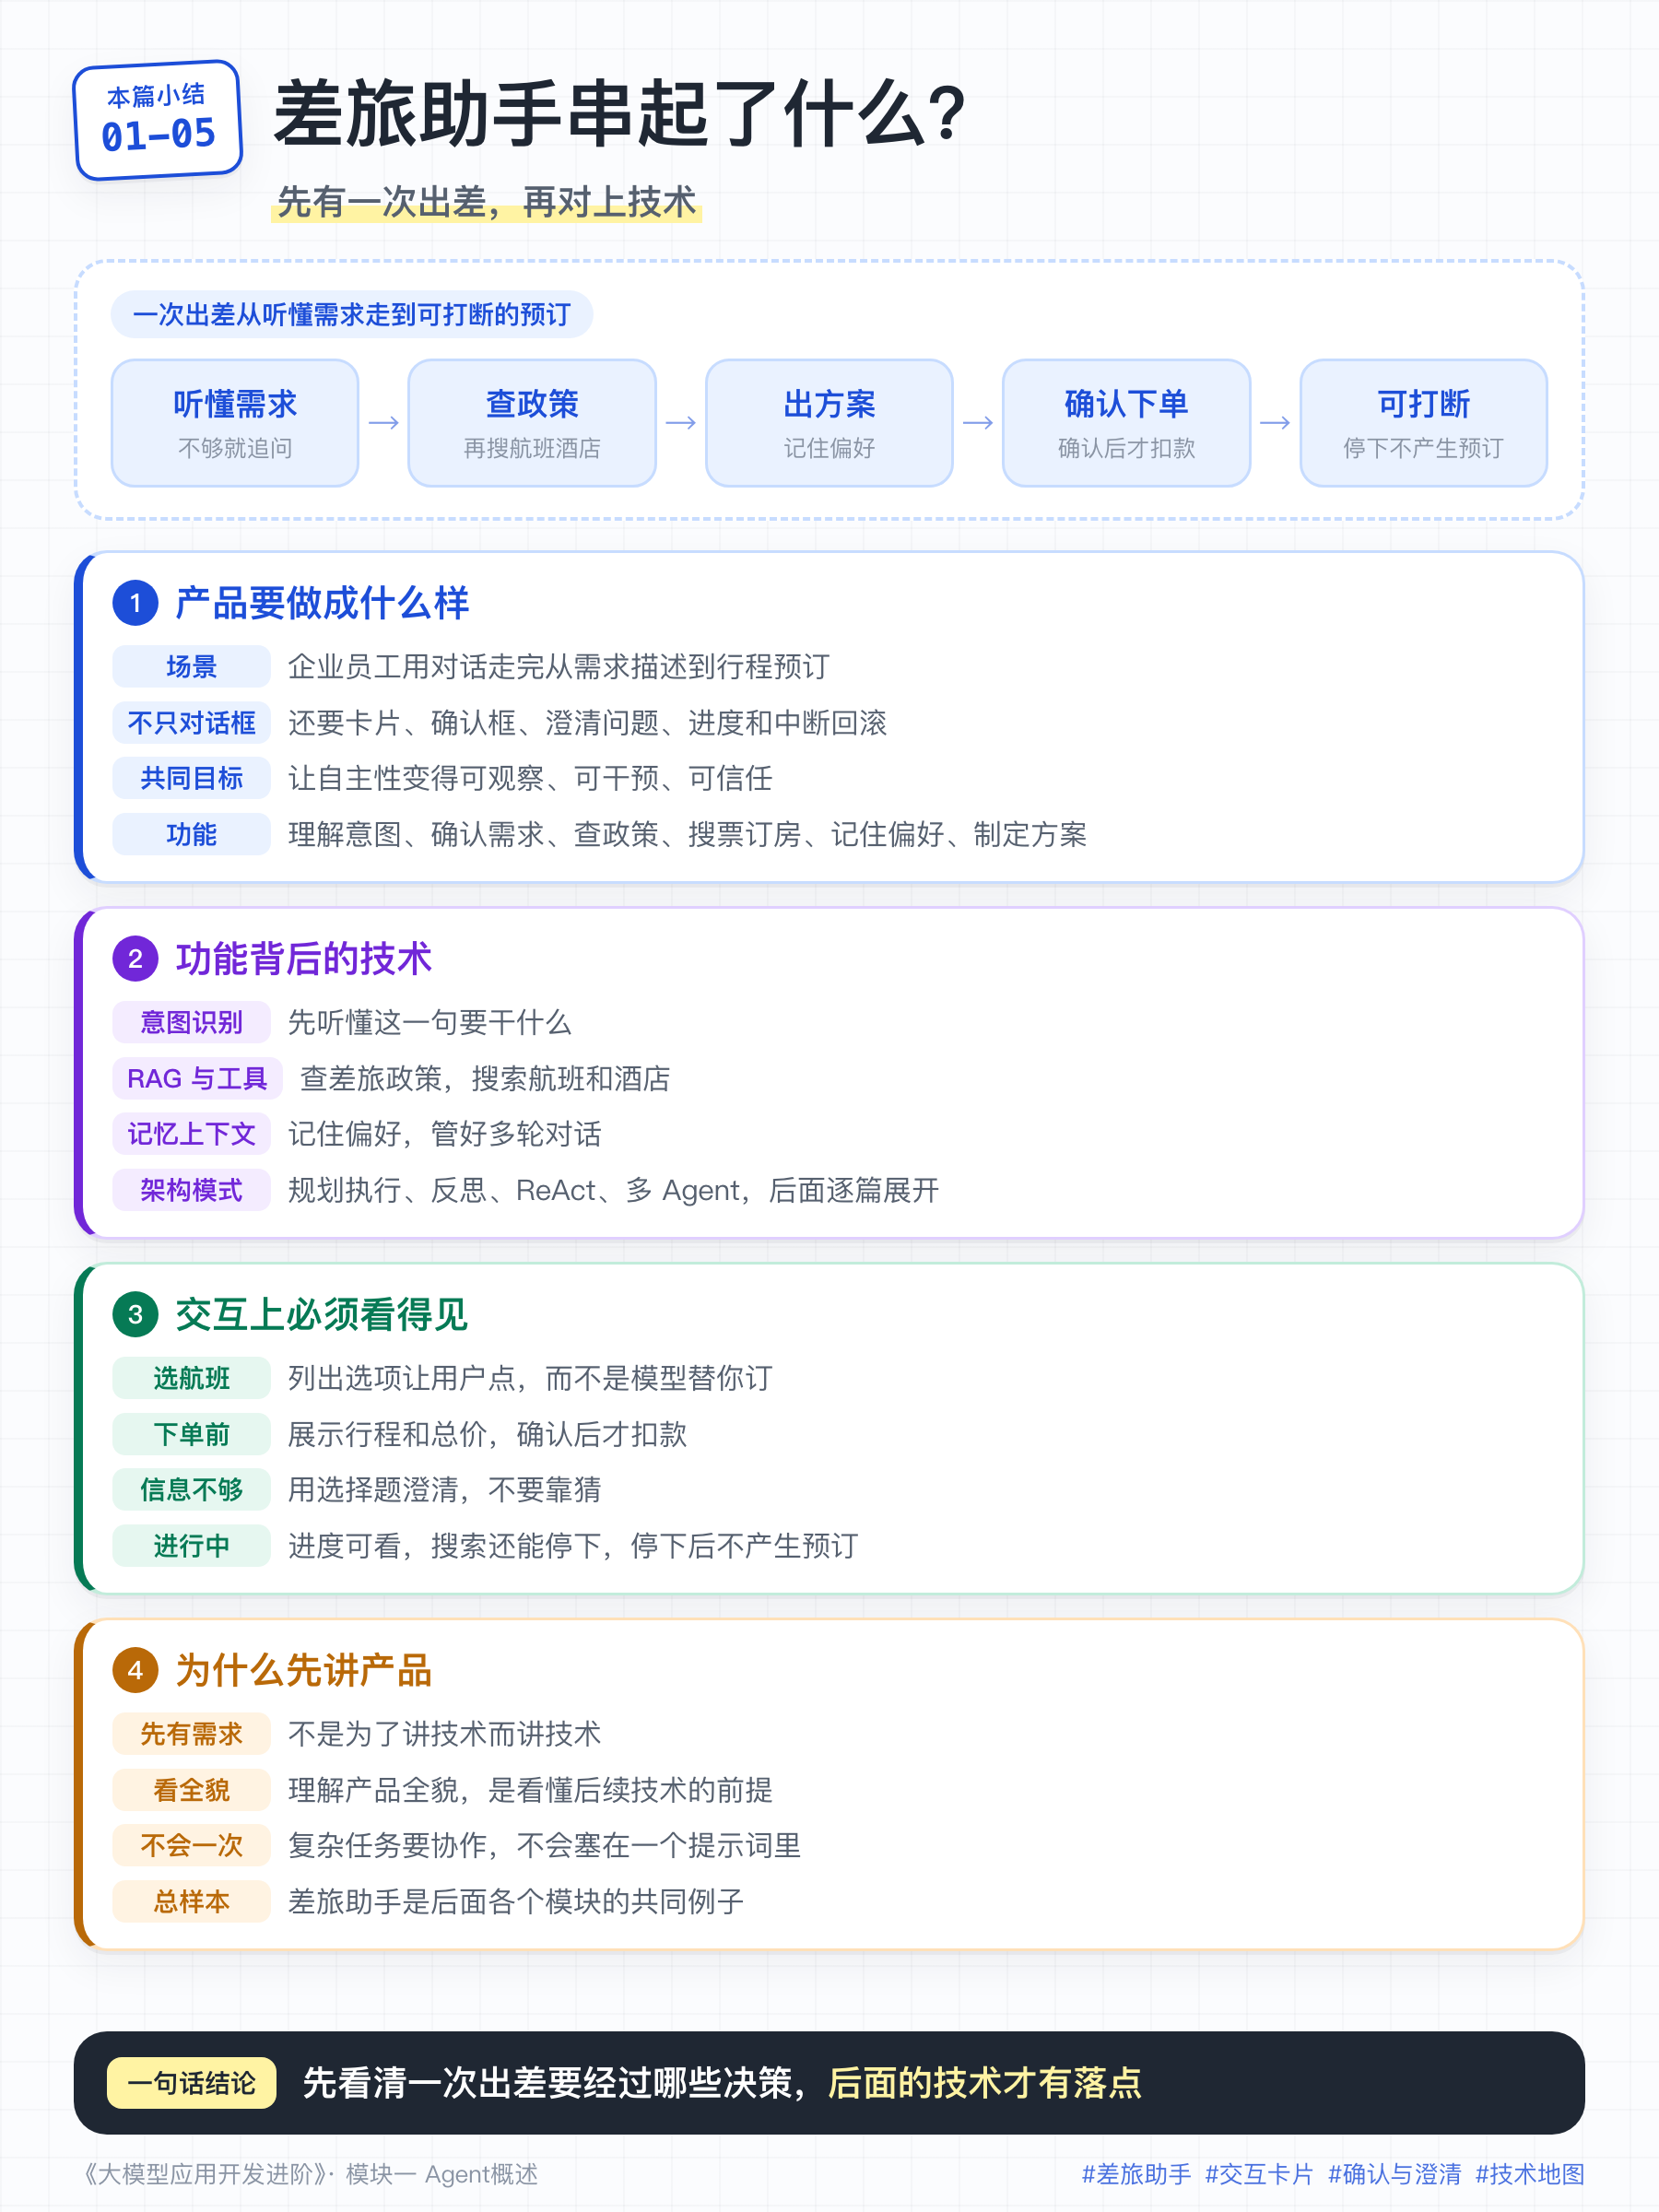
本篇小结
07-MCP—连接Agent与外部能力
上一篇讲的工具,都是你自己写的 Python 函数:定义一段 Schema,注册进执行器,模型就能调用。一个项目里这么做,完全够用。
可是公司里通常不会只有一个 Agent。客服助手要查天气,出行助手要查天气,运营报表也要用当天气温做对照。每个项目都按上一篇的办法,从零写一遍 get_weather、再注册一遍,天气接口一换,所有项目都得跟着改。有没有更好的办法,让查天气只实现一次,各个 Agent 直接接进来用?
有。把 get_weather 从各个 Agent 里抽出来,做成一份独立的运行的接口,Agent 项目只负责连接和调用,不必重复实现。
其实,实现一个接口服务,很简单,我相信做业务开发的你,应该天天都在做着类似的事情。关键的问题在于,我们要设计一套针对工具调用的数据格式,提供方怎么声明「我有哪些工具、参数是什么」,使用方怎么发现这些工具、怎么把调用请求送过去等等。
这就是今天要讲的 MCP(Model Context Protocol,模型上下文协议) 要解决的问题。
一、MCP
MCP 由 Anthropic 在 2024 年 11 月提出并开源。MCP 本质是一套基于 JSON-RPC 的应用层协议。工具的提供方按协议实现一个服务器(Server),把自己的工具暴露出来;Agent 产品按协议实现一个客户端(Client),就能连上服务器使用工具。
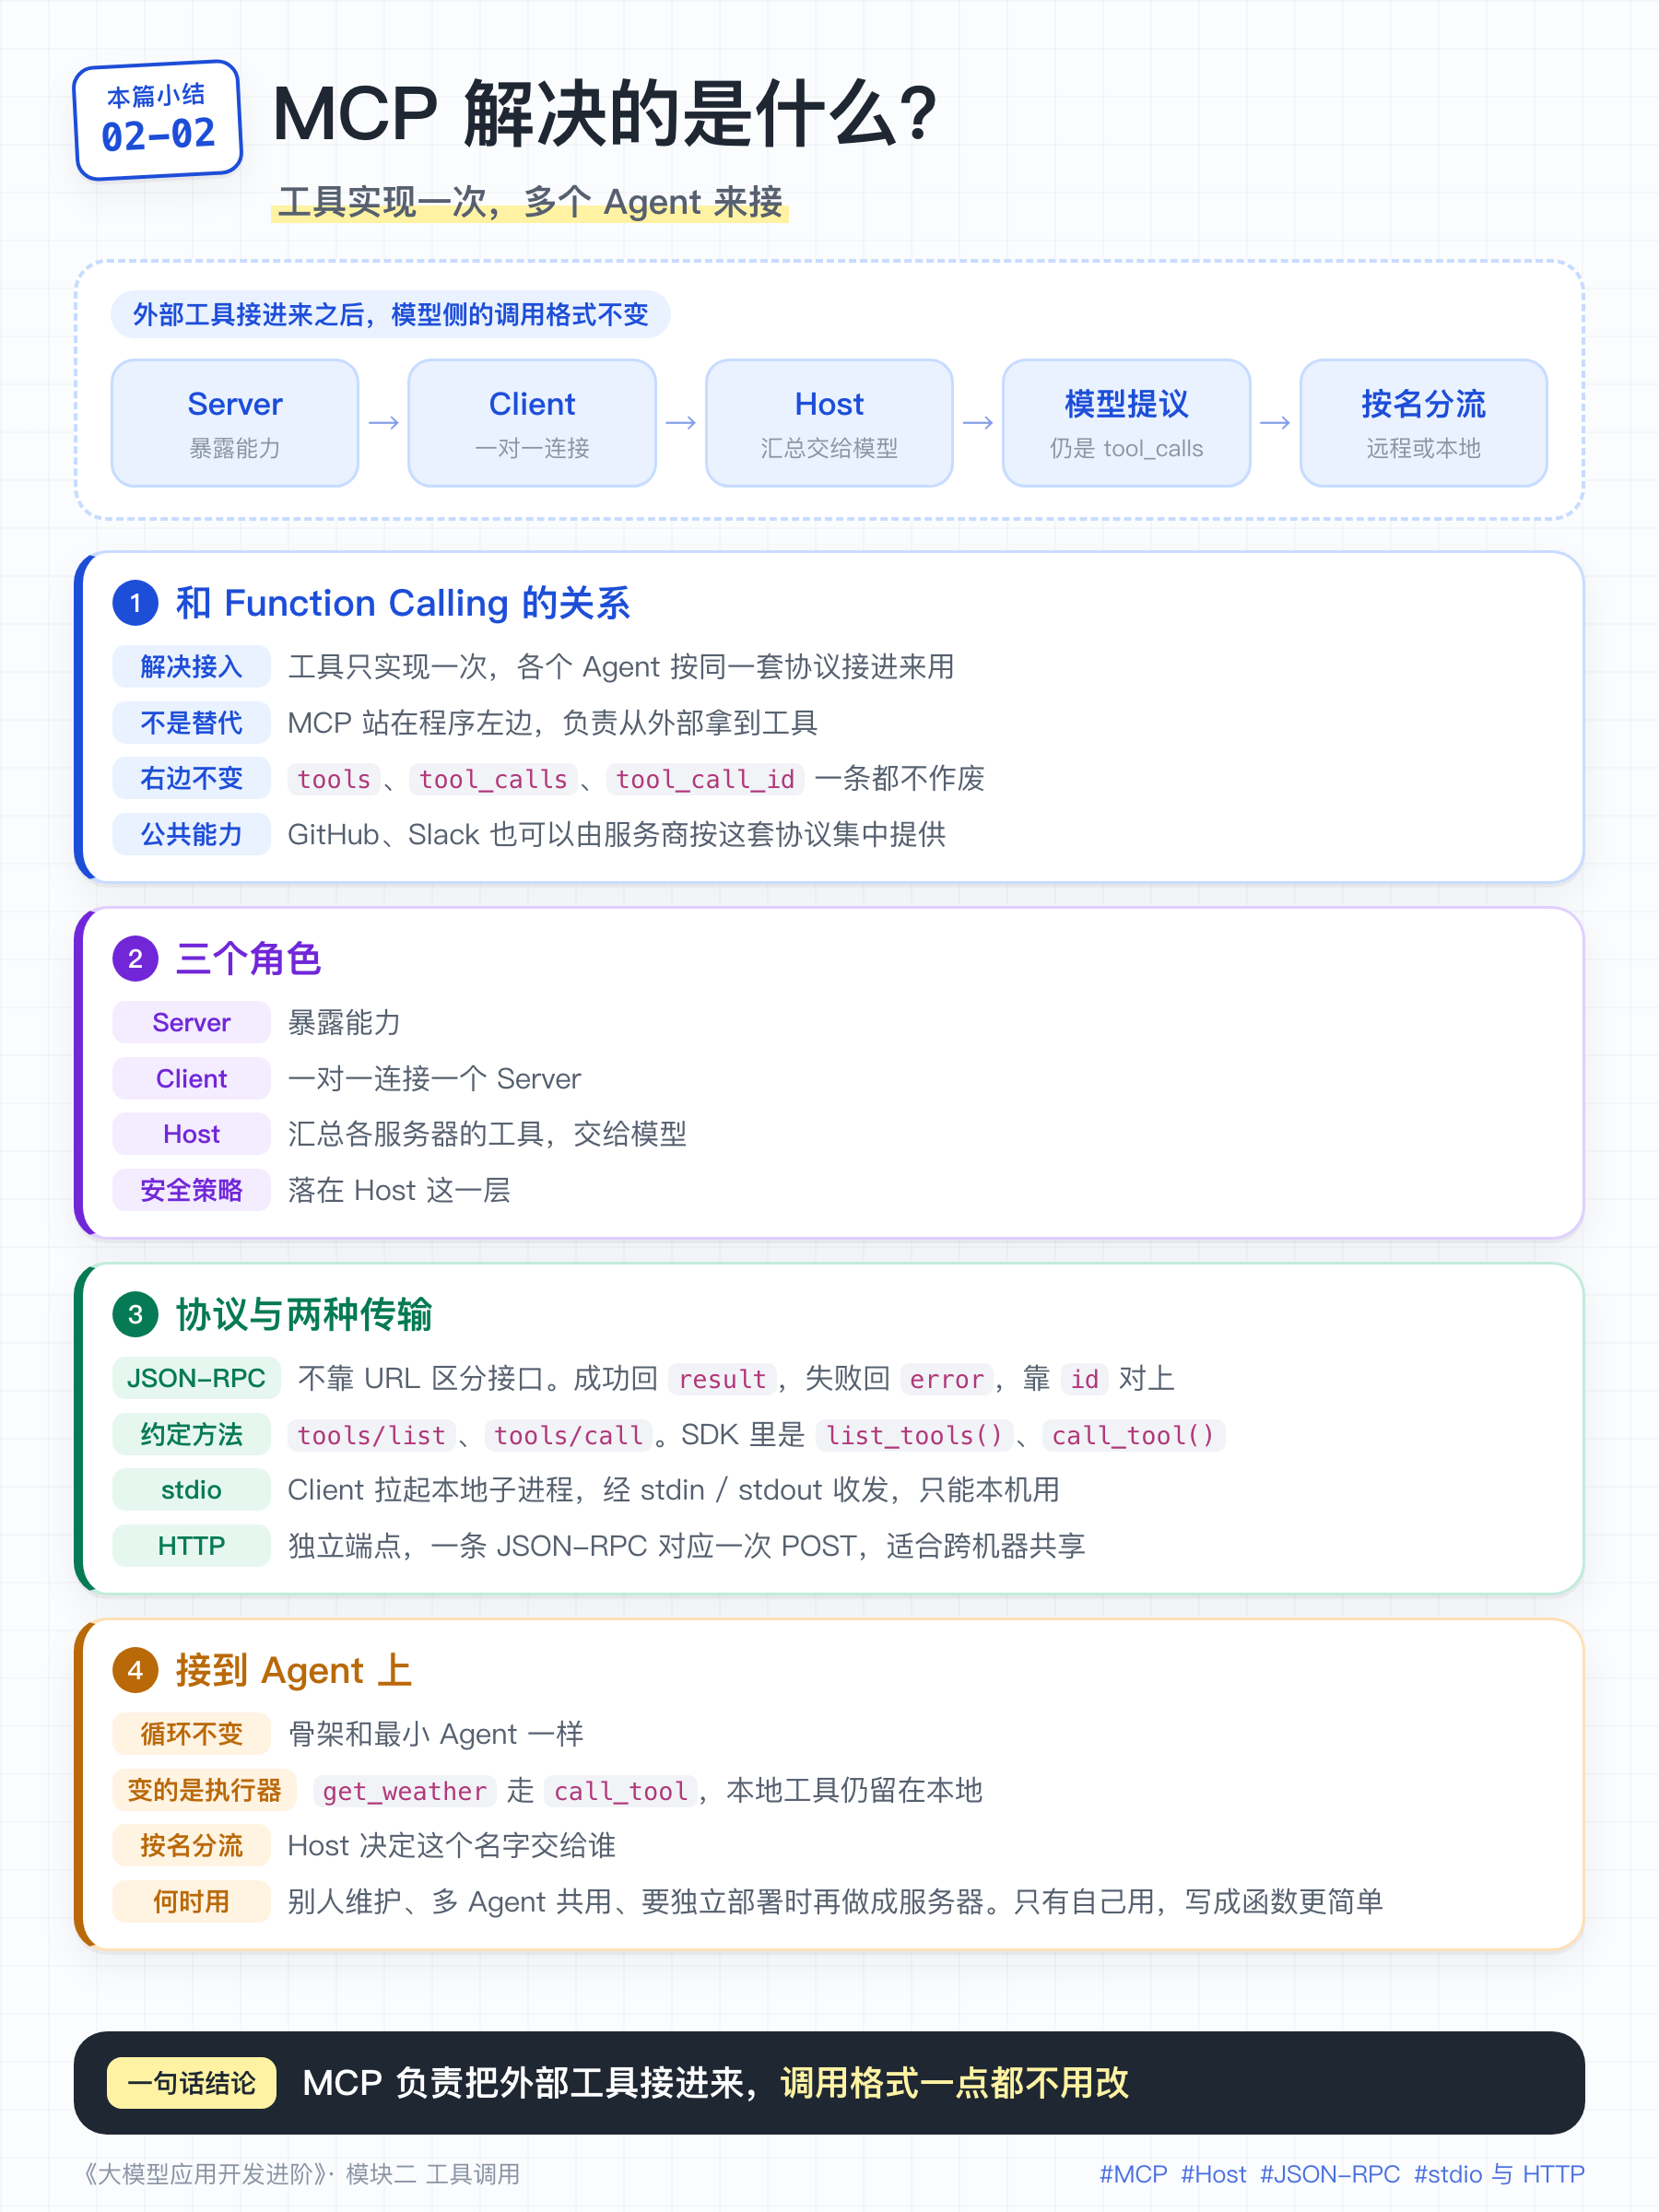
这里需要强调一下:MCP 不是 Function Calling 的替代品,两者根本不在一个层面上。
Function Calling 解决的是「模型怎么表达它要调用一个工具」,这是模型和你的程序之间的事。MCP 解决的是「你的程序从哪里拿到这些工具」,这是你的程序和外部系统之间的事。接了 MCP 之后,模型看到的东西一点没变,还是上一篇那份 tools 列表:
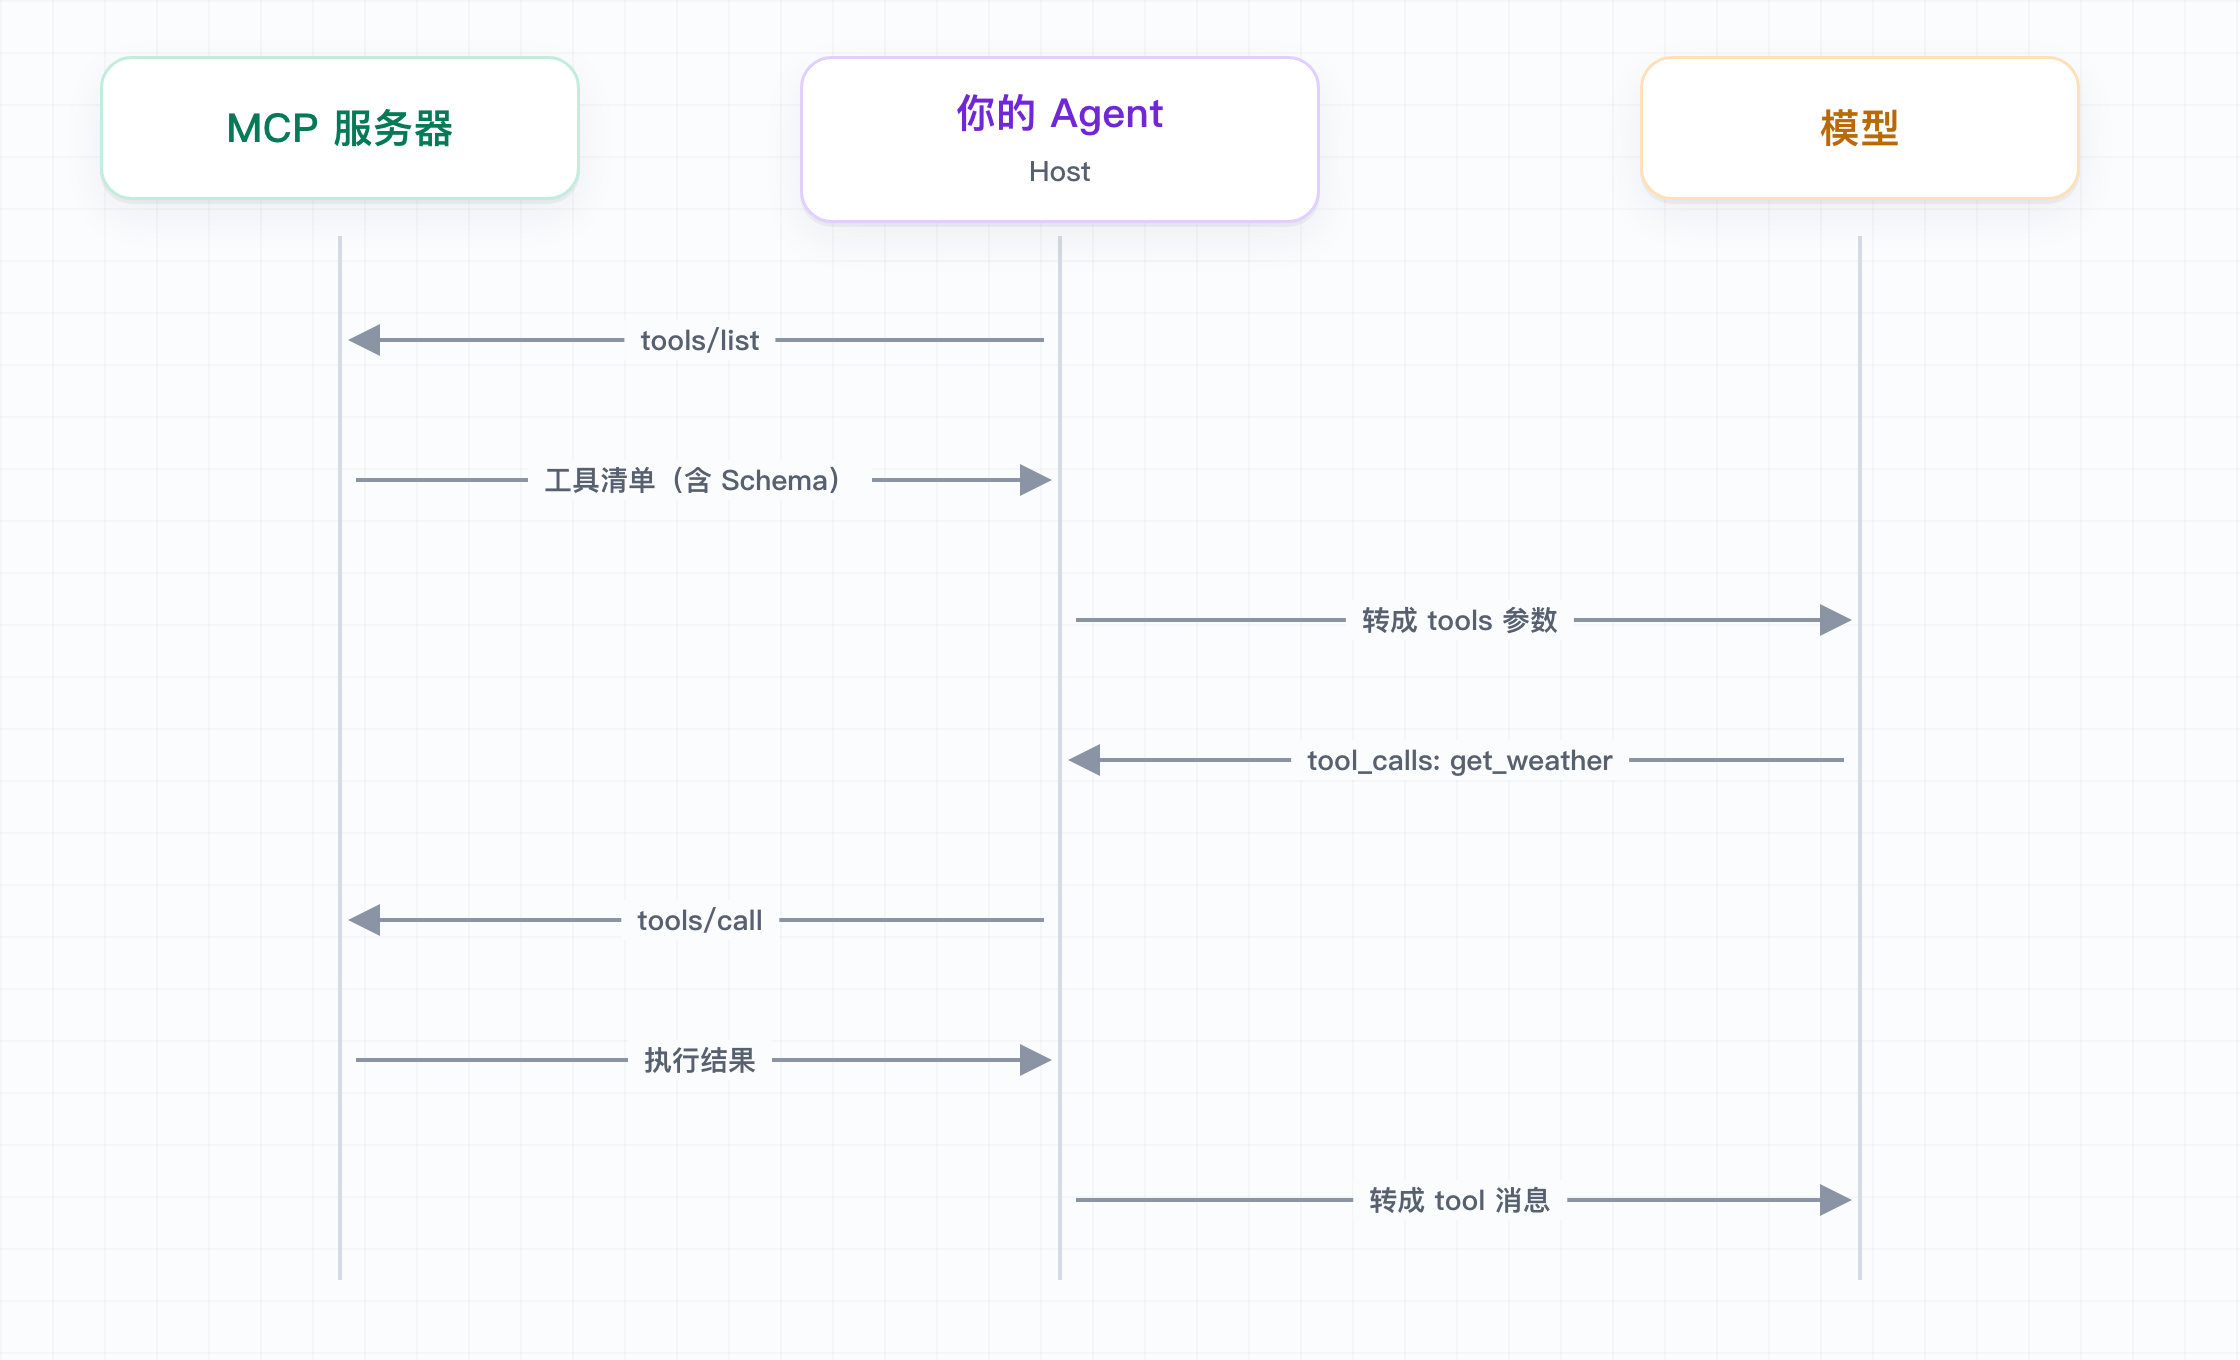
上一篇讲的工具描述、返回契约、tool_call_id,接了 MCP 之后仍然不变,只是工具清单的来源从本地注册表换成了远端服务器。
def mcp_tools_to_openai(tools):
    """把 MCP 的工具清单,转成上一篇发给模型的 tools 参数。"""
    return [
        {
            "type": "function",
            "function": {
                "name": tool.name,
                "description": tool.description,
                "parameters": tool.input_schema,  # 就是那段 JSON Schema
            },
        }
        for tool in tools
    ]
前面也提到,MCP 本质就是一套应用层的协议,你完全可以跟OAuth这类协议类比理解,只不过,MCP是解决工具调用问题的,OAuth是解决鉴权问题的。
MCP 在业界统一了一份工具调用的格式规范,这样做的好处是:
你可以按照MCP格式,去调用其他公共的工具服务,这个服务并不一定是你们公司自己写的。比如,读写 GitHub 的 Issue、查 Notion 的文档、往 Slack 发消息,这类能力不是某一家公司私有的,几乎所有做相关 Agent 的团队都会用到。这些公共服务更适合由服务商集中提供一份,而不是每家公司、每个产品各自对接一遍官方 API。服务商按什么格式把能力交出来,各家 Agent 又按什么格式接进去,这就是 MCP。
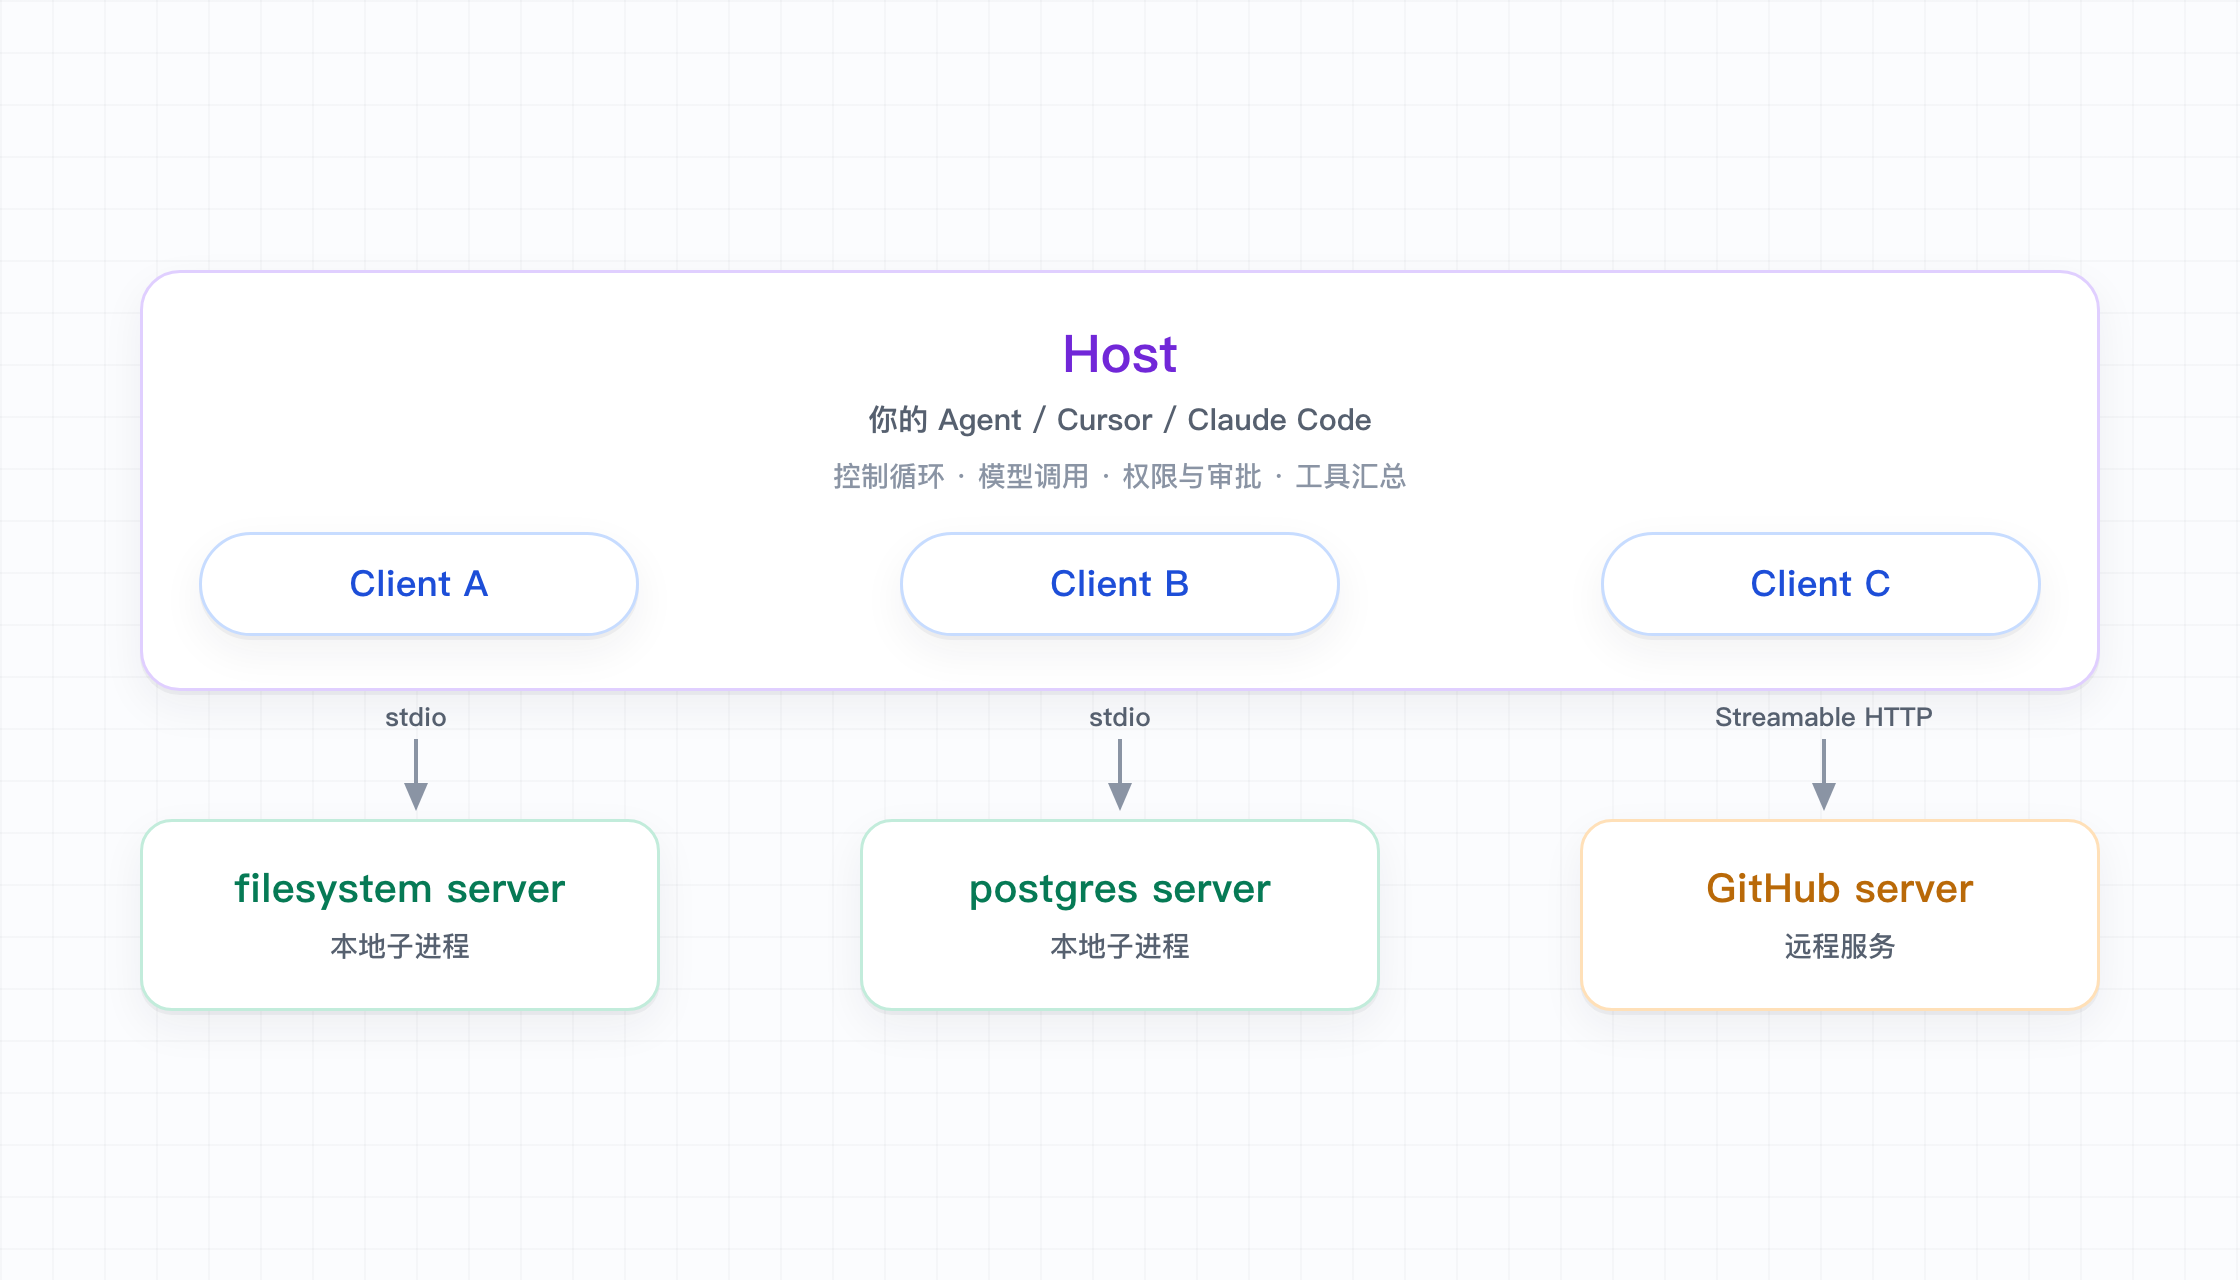
二、Host、Client 与 Server
MCP 里有三个角色。
**Server(服务器)**是暴露能力的那一方,是一个独立的进程。比如 filesystem server 提供读写文件的能力,postgres server 提供查数据库的能力。它只管声明「我有哪些工具」并响应调用,完全不关心谁在用它、用的是什么模型。
Client(客户端)是协议的另一端,负责和某一个服务器保持连接。这里的关键是一个客户端只连一个服务器,你接三个服务器就会有三个客户端实例。这种一对一的设计是有意的,它让每个连接的权限和生命周期可以单独管理,某个服务器崩了不会影响其他的。
**Host(宿主)**是真正跑 Agent 的那个应用,比如 Cursor、Claude Code,或者你自己写的 Agent 程序。它内部持有多个 Client 客户端。Host 负责把各个服务器的工具汇总起来交给模型,也负责决定哪些工具可以用、哪些调用需要人工确认。安全策略是落在 Host 这一层的,工具 Server 服务器自己不做这件事。
三、数据格式和传输方式
MCP的数据传输格式叫 JSON-RPC。
你平时写业务接口,多半是 HTTP + JSON:客户端 POST 到 /weather,HTTP响应body 里带 {"city": "北京"},要调哪个接口写在路径上。这就是 RPC(Remote Procedure Call,远程过程调用)。
JSON-RPC 是 RPC 的一种具体写法:不靠 URL 路径区分接口,而是把「调哪个、传什么」都写进一份固定形状的 JSON。查北京天气,客户端发出去的是这样一条消息:
{
  "jsonrpc": "2.0",
  "id": 1,
  "method": "tools/call",
  "params": {
    "name": "get_weather",
    "arguments": {"city": "北京"}
  }
}
服务器成功时回一份带 result 的 JSON,失败时回一份带 error 的 JSON,id 和请求一一对应:
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "content": [
      {"type": "text", "text": "{\"city\": \"北京\", \"weather\": \"晴\", \"temp_celsius\": 12}"}
    ],
    "structuredContent": {"city": "北京", "weather": "晴", "temp_celsius": 12}
  }
}
搞懂了数据格式之后,我们再来看Cilent和Server之间的数据传输方式:stido和streamable HTTP。
Stido
Stdio 的工作方式很直接:Client 把 MCP Server 当作一个子进程启动,然后把 JSON-RPC 消息写进子进程的标准输入(stdin),再从标准输出(stdout)读取MCP Server的回复。
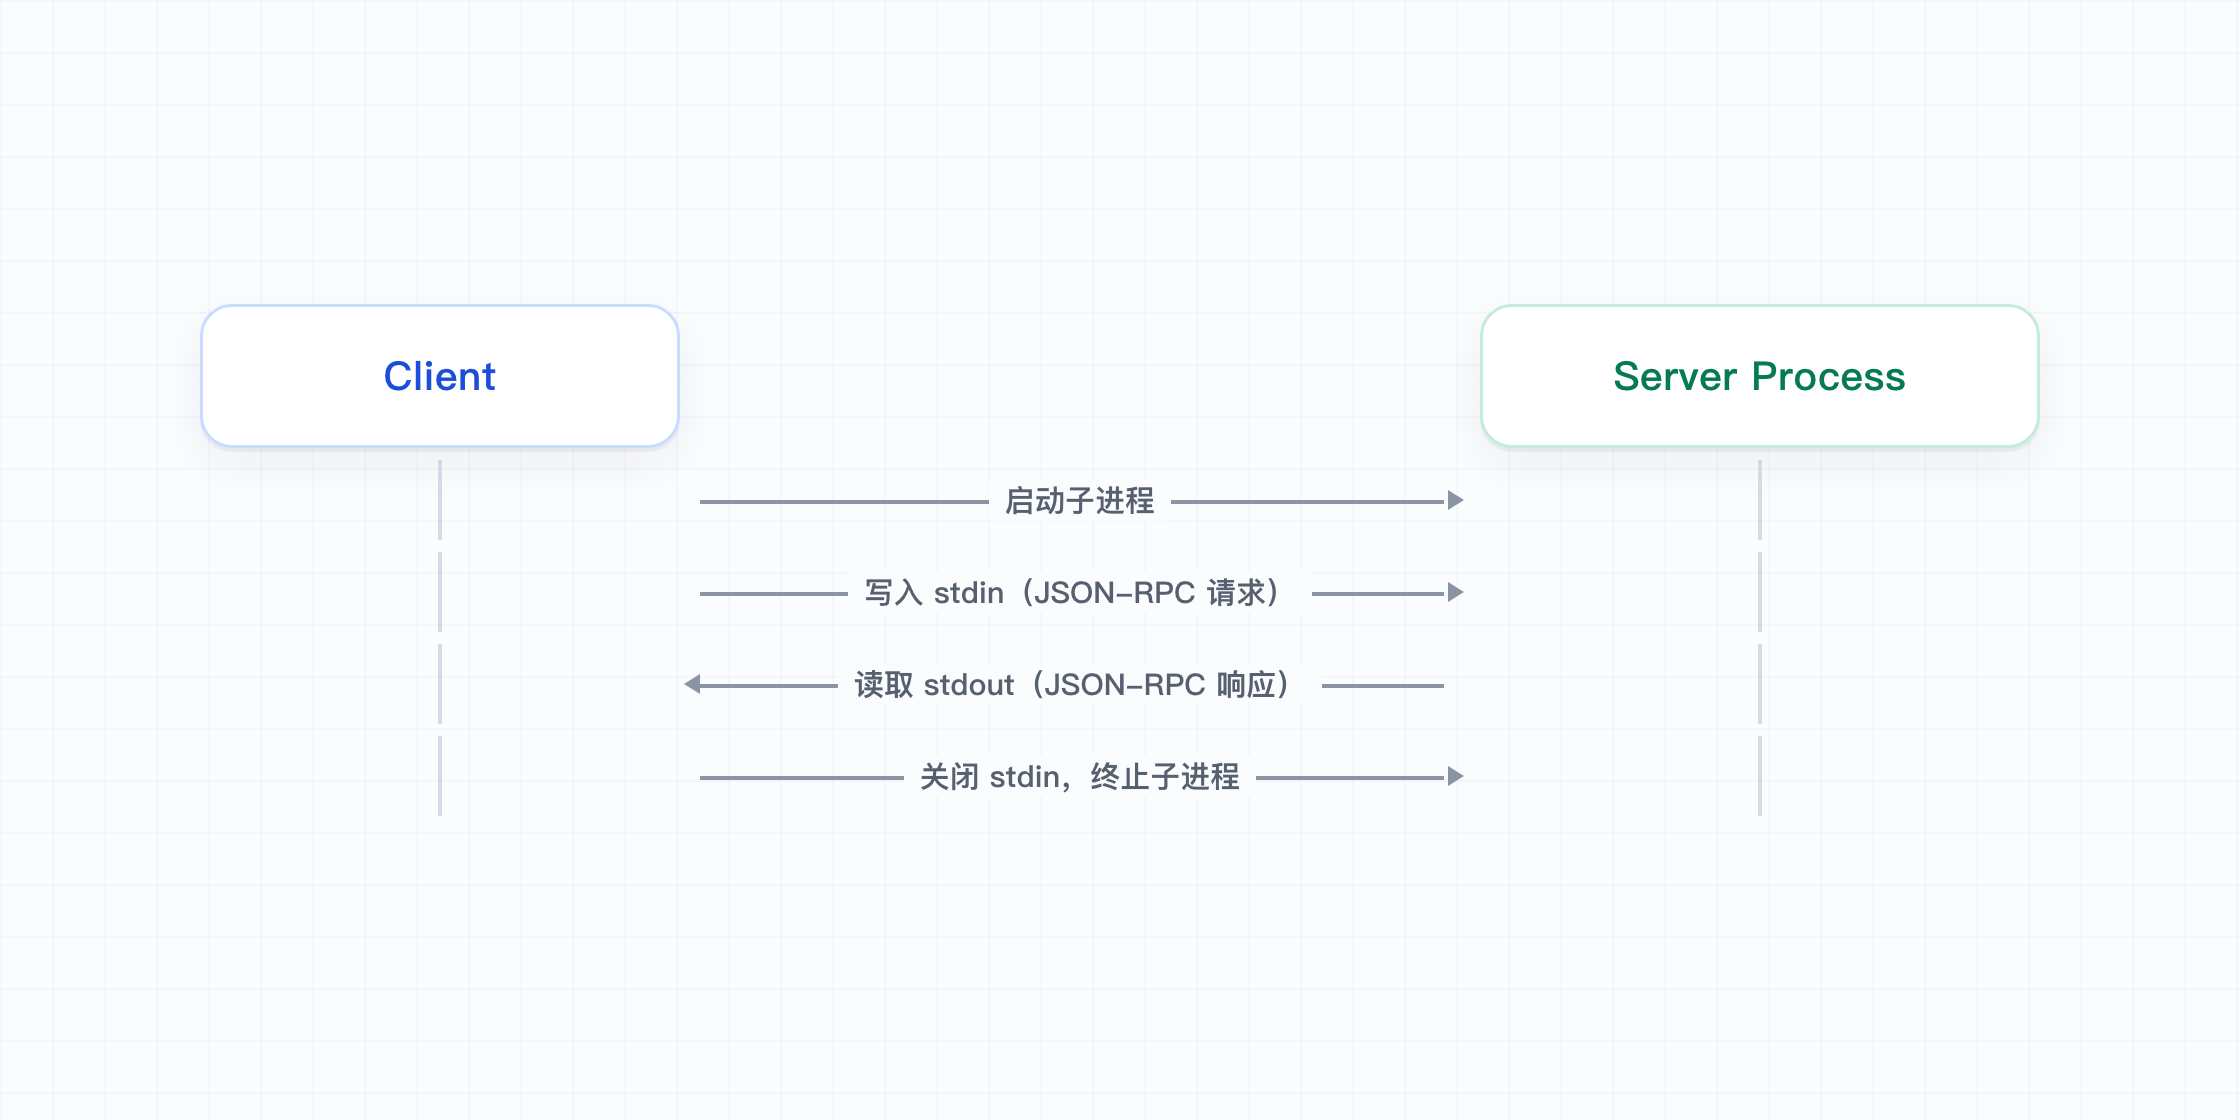
MCP Server 的生命周期完全由Client 控制。会话开始时客户端创建子进程,会话结束时客户端关闭 stdin,服务器检测到 stdin 关闭后自行退出。
stdio 的优点是延迟低、没有网络开销、进程隔离带来的安全性也天然较好,但它只能在本地使用。适合需要低延迟访问本机能力的场景,比如读本地文件、查本地数据库。
Streamable HTTP
服务器作为一个独立进程运行,可以同时处理多个客户端连接,客户端和服务器可以不在同一台机器上。服务器暴露一个 HTTP 端点(比如 https://codecrush.com/mcp)。客户端发送的每一条 JSON-RPC 消息,都是一次独立的 HTTP POST 请求。
服务器收到请求后,有两种回复方式。对于简单的请求,直接返回一个 application/json 的 JSON-RPC 响应。如果这次调用需要流式推送多条消息(比如执行过程中需要逐步返回进度),服务器会返回 text/event-stream,也就是建立一个 SSE 流,在流里持续推送响应。
需要跨机器、跨团队共享的能力(查 GitHub、连 Notion、调公司内部的共享服务)用 Streamable HTTP,服务器独立部署,多个 Agent 同时连接。
四、实现一个最小 MCP
MCP的原理搞清楚了,现在,我们动手写一个能跑的最小实现。我们不用框架,只用官方 Python SDK。
这里说的官方 Python SDK,指的是 Anthropic 随 MCP 协议一起开源、由 Model Context Protocol 组织维护的 mcp 库(pip install mcp,用 uv 则 uv add mcp,仓库在 github.com/modelcontextprotocol/python-sdk)。它是 MCP 协议的官方参考实现,Server 端(写工具、暴露能力)和 Client 端(连接、发现、调用)两套 API 都在里面。
先写服务器。一个工具就是一个普通函数,加上 @mcp.tool() 即可:
# weather_server.py
from mcp.server import MCPServer

mcp = MCPServer(
    "weather",
    instructions="查询城市天气。一次只查一个城市,不要编造未提供的城市。",
)

@mcp.tool()
def get_weather(city: str, unit: str = "celsius") -> dict:
    """查询指定城市今天的天气和气温。一次只查一个城市。"""
    catalog = {
        "北京": {"weather": "晴", "temp_celsius": 12},
        "上海": {"weather": "多云", "temp_celsius": 19},
    }
    data = catalog.get(city)
    if data is None:
        return {"error": f"查询失败:查不到 {city} 的天气。请改用中国城市名称,比如 北京。"}
    temp = data["temp_celsius"]
    if unit == "fahrenheit":
        temp = round(temp * 9 / 5 + 32)
        return {"city": city, "weather": data["weather"], "temp_fahrenheit": temp}
    return {"city": city, "weather": data["weather"], "temp_celsius": temp}

if __name__ == "__main__":
    mcp.run()  # 默认 stdio;对外提供服务则改成 mcp.run("streamable-http")
再写客户端,使用stdio传输方式。
# weather_client.py
import anyio
from mcp import Client, StdioServerParameters

async def main():
    async with Client(StdioServerParameters(
        command="python",
        args=["weather_server.py"],
    )) as client:
        listed = await client.list_tools()
        for tool in listed.tools:
            print(tool.name)
            print(tool.description)
            print(tool.input_schema)

        result = await client.call_tool("get_weather", {"city": "北京"})
        print(result.structured_content)
        print(result.is_error)

if __name__ == "__main__":
    anyio.run(main)
跑起来会看到类似这样的输出:
get_weather
查询指定城市今天的天气和气温。一次只查一个城市。
{'type': 'object', 'properties': {'city': {'type': 'string'}, 'unit': {'type': 'string', 'default': 'celsius'}}, 'required': ['city']}
{'city': '北京', 'weather': '晴', 'temp_celsius': 12}
False
协议跑通之后,换传输只改 Client(...) 那一行,服务器函数不用动。远程部署则先在服务器那边改成 mcp.run("streamable-http"),客户端写成 Client("http://localhost:8000/mcp")。
async with Client("http://localhost:8000/mcp") as client: ...五、将MCP接入Agent
我们把天气MCP服务器接到最小 Agent 上。calculator 仍按上一篇的方式留在本地,用来说明:MCP 工具和本地函数可以同时交给模型,Host 按名字分流。
# agent_with_mcp.py
import os
import json
import anyio
from openai import OpenAI
from mcp import Client
from mcp.types import TextContent
from weather_server import mcp  # 前面写好的天气服务器

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
MODEL = "gpt-5.6"  # 生产环境应锁定到带日期的快照 ID

SYSTEM_PROMPT = """你是一个查询助手,可以调用工具来查天气、做计算。

工作规则:
1. 需要外部信息时,调用相应的工具,不要自己编造数据。
2. 一步做不完的任务,就分成多步,拿到结果再决定下一步。
3. 当你已经拿到足够的信息、能够回答用户的问题时,直接用自然语言给出最终答案。
"""


def get_calculator_tool():
    return {
        "type": "function",
        "function": {
            "name": "calculator",
            "description": "计算一个数学表达式,用于加减乘除等运算。",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {
                        "type": "string",
                        "description": "要计算的表达式,比如 19 - 12",
                    }
                },
                "required": ["expression"],
            },
        },
    }


def calculator(expression: str) -> str:
    try:
        result = eval(expression)  # 演示用,生产环境要用安全的表达式求值
        return json.dumps({"expression": expression, "result": result}, ensure_ascii=False)
    except Exception as e:
        return f"计算失败:表达式 {expression} 无法求值({e})。请改成纯数字的四则运算,比如 19 - 12。"


def mcp_tools_to_openai(tools):
    return [
        {
            "type": "function",
            "function": {
                "name": tool.name,
                "description": tool.description,
                "parameters": tool.input_schema,
            },
        }
        for tool in tools
    ]


def result_to_text(result) -> str:
    if result.structured_content is not None:
        return json.dumps(result.structured_content, ensure_ascii=False)
    texts = [
        block.text
        for block in result.content
        if isinstance(block, TextContent)
    ]
    return "\n".join(texts) or "工具没有返回文本结果"


def call_model(messages, tools):
    response = client.chat.completions.create(
        model=MODEL,
        messages=messages,
        tools=tools,
        tool_choice="auto",
        parallel_tool_calls=True,
    )
    return response.choices[0].message


async def execute(mcp_client, name: str, raw_arguments: str) -> str:
    try:
        args = json.loads(raw_arguments or "{}")
    except json.JSONDecodeError:
        return "调用失败:参数不是合法的 JSON。请重新生成参数后再调用一次。"

    if name == "calculator":
        return calculator(**args)

    result = await mcp_client.call_tool(name, args)
    if result.is_error:
        return f"工具调用失败:{result_to_text(result)}"
    return result_to_text(result)


async def run_agent(question: str, max_steps=10):
    async with Client(StdioServerParameters(
    		command="python",
    		args=["weather_server.py"],
    )) as mcp_client:
        listed = await mcp_client.list_tools()
        tools = mcp_tools_to_openai(listed.tools) + [get_calculator_tool()]
        messages = [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": question},
        ]

        for step in range(max_steps):
            print(f"\n===== 第 {step + 1} 轮 =====")
            message = call_model(messages, tools)
            messages.append(message)

            if not message.tool_calls:
                print("模型给出最终答案,结束循环")
                return message.content

            for tool_call in message.tool_calls:
                name = tool_call.function.name
                print(f"模型决定调用工具:{name},参数:{tool_call.function.arguments}")
                result = await execute(mcp_client, name, tool_call.function.arguments)
                print(f"工具返回:{result}")
                messages.append({
                    "role": "tool",
                    "tool_call_id": tool_call.id,
                    "content": result,
                })

        return "达到最大步数,任务未能完成"


if __name__ == "__main__":
    answer = anyio.run(run_agent, "北京和上海今天的温差是多少度?")
    print(f"\n最终答案:{answer}")
和上个模块的最小 Agent 比,循环骨架没有变。打印出来的日志记录如下所示:
===== 第 1 轮 =====
模型决定调用工具:get_weather,参数:{"city": "北京", "unit": "celsius"}
工具返回:{"city": "北京", "weather": "晴", "temp_celsius": 12}

===== 第 2 轮 =====
模型决定调用工具:get_weather,参数:{"city": "上海", "unit": "celsius"}
工具返回:{"city": "上海", "weather": "多云", "temp_celsius": 19}

===== 第 3 轮 =====
模型决定调用工具:calculator,参数:{"expression": "19 - 12"}
工具返回:{"expression": "19 - 12", "result": 7}

===== 第 4 轮 =====
模型给出最终答案,结束循环

最终答案:北京今天 12 度,上海今天 19 度,两地温差是 7 度。
MCP 现在很热,但它并不是所有场景的默认选择。判断的标准很简单:看这个工具会不会被复用。
如果一个工具只有你这一个 Agent 会用、代码就在你的项目里、由你自己维护,那直接按上一篇的办法写成函数注册进去,是更好的选择。少一个进程、少一层协议、少一次序列化,调试的时候堆栈是连着的,出问题一眼就能看到。为了「用上 MCP」而把自家的三个函数包成一个服务器,只会增加负担。这一篇把 calculator 留在本地,就是这个原因:它没有被复用的需求。
MCP 真正用得上的场景是这几种:
- 工具由别人维护,你只想接进来用,比如 GitHub、Notion、数据库这些现成的服务器。
- 同一批工具要给多个 Agent 使用,包成服务器就只需要维护一份。
- 工具需要跨语言或跨进程,比如 Agent 是 Java 写的,而工具依赖一批 Python 库。
- 工具需要独立的部署和权限边界,比如它要访问生产数据库,你希望它跑在单独的容器里。
反过来说,如果这四条都不成立,直接写函数就好。
本篇小结
08-CLI—让Agent操作本地环境
前两篇讲的工具都遵循同一个模式:一个工具做一件事,要多做几件事就多挂几个工具。按这个思路推下去,一个能干活的编程 Agent 得挂多少工具?读文件、写文件、搜代码、装依赖、跑测试、提交代码、查看分支、看端口占用、重启服务,几十个都不够。
但实际去看 Claude Code、Codex 这类产品,它们的工具列表短得出人意料,十来个就够了。其中最关键的一个,是执行 Shell 命令的工具。
这一篇就来讲这个特殊的工具:它为什么这么有效、实现时有哪些非常容易踩的坑,以及怎么在给出这么大权限的同时把风险控制住。
一、CLI 通用环境接口
一个 run_shell(command) 工具,等于把这台机器上所有命令行程序都变成了 Agent 可用的能力:git、curl、grep、python、npm、docker。你不需要为每一样单独写工具描述和参数 Schema。
它之所以这么有效,有三个具体原因。
第一,命令行程序天生可组合。 管道、重定向、&&、退出码,这套约定让一条命令能顶一段程序。想知道项目里哪个文件改动最频繁,一条命令就够了:
git log --pretty=format: --name-only | sort | uniq -c | sort -rn | head -10如果要把这个能力做成一个专门的工具,你得先想清楚参数怎么设计、返回什么结构,而且换个统计口径就得改代码。交给 Shell,模型自己就组合出来了。
第二,模型对命令行极其熟悉。 训练语料里 Shell 命令、README、技术问答的数量非常庞大,模型对 git、curl、grep 的用法掌握得很好,远好于它对你自研工具 API 的掌握程度。你自己封装一个 git_commit(files, message, amend) 工具,参数命名和语义都得靠 description 现教,而直接让它写 git commit -m "...",它一次就能写对。
第三,文本进文本出,和模型天然适配。 命令行程序的输入输出都是文本,不需要额外的序列化和格式转换。
当然,开放命令行也要付出代价的:能力不可枚举,风险也就不可枚举。
前两篇的工具都是「一个工具做一件事」。能力是一张有限表:读文件、搜代码、建 Issue,列表里有什么,Agent 就只能做什么。风险也跟着是一张有限表:文件工具最多写错文件,搜索工具最多把上下文撑满。你能事先说清楚工具的边界。
run_shell(command) 表面上只多了一个工具,实际上把这台机器上所有命令行程序,以及它们的任意组合,都交给了模型:git、curl、python、docker、管道、重定向、python -c。能力不再是「工具列表里那十几项」,而是「这台机器此刻能做什么」。你无法给出一份完整的命令清单。
Shell 的风险穷举不完。模型可能只是想删 ./build,却写成 rm -rf ./build /,多一个空格就把根目录也删除了;它也可能只是执行了 env,却把环境变量里的密钥打印出来。就算你先列一张「只许跑的命令」的白名单,名单里的 python -c 照样能绕过白名单做任何事。
前两篇讲工具设计时,重心在把功能描述清楚,而对于CLI ,在哪个环境跑、以什么身份跑、能碰哪些资源、出了事怎么停、怎么审计、怎么回滚等,这些约束才是涉及到重心。
二、给 Agent 接入 CLI 命令
那到底哪类 Agent 会使用 CLI?
最典型的是编程 Agent。Claude Code、Codex、Cursor 这类产品面对的是一个真实代码仓库:读文件、改代码、搜引用、装依赖、跑测试、看 diff、提交、开 PR。这些动作单独看都能封装成工具,但组合方式几乎无穷,Shell 是成本最低的接入方式。
除此之外,还有运维/SRE类Agent。查日志、看端口、重启服务、操作容器、操作 K8s、查数据库,这些操作本身就以命令行为主。
现在我们就给那个最小Agent接上CLI 命令。
前面几篇一直用同一个例子:回答「北京和上海今天的温差是多少度」。工具是 get_weather 和 calculator。
现在用户多问了一句:「把结果写到本机的 report.txt 里。」按前两篇的思路,就得再封装一个 write_report 这种工具;按这篇的思路,往工具表里加一个 run_shell 就够了。模型自己会写出把文字落到文件里的命令。
先把 run_shell 写成一个普通函数,再按上一篇的方式注册进去。这里先做到能跑、能把输出回传给模型;命令注入和危险操作的防护,下一小节再加。
import os
import signal
import subprocess

MAX_OUTPUT_CHARS = 6000


def truncate(text: str, limit: int = MAX_OUTPUT_CHARS) -> str:
    if len(text) <= limit:
        return text
    omitted = len(text) - limit
    return f"{text[: limit // 2]}\n\n...(中间省略 {omitted} 个字符)...\n\n{text[-limit // 2:]}"


def run_shell(command: str, cwd: str = ".") -> str:
    """在指定目录执行一条 Shell 命令。不要用 cd 切换目录,请用 cwd 参数。"""
    try:
        proc = subprocess.Popen(
            command,
            shell=True,
            cwd=cwd,
            stdin=subprocess.DEVNULL,
            stdout=subprocess.PIPE,
            stderr=subprocess.PIPE,
            text=True,
            errors="replace",
            start_new_session=True,
        )
        stdout, stderr = proc.communicate(timeout=120)
        code, timed_out = proc.returncode, False
    except subprocess.TimeoutExpired:
        os.killpg(os.getpgid(proc.pid), signal.SIGKILL)
        stdout, stderr = proc.communicate()
        code, timed_out = -1, True
    except OSError as e:
        return f"命令启动失败:{e}"

    parts = [f"退出码:{code}" + ("(执行超时被强制终止)" if timed_out else "")]
    if stdout.strip():
        parts.append(f"--- 标准输出 ---\n{truncate(stdout)}")
    if stderr.strip():
        parts.append(f"--- 标准错误 ---\n{truncate(stderr)}")
    if not stdout.strip() and not stderr.strip():
        parts.append("(命令没有任何输出)")
return "\n".join(parts)工具描述如下。description 里要写清「不要用 cd」,否则模型会按自己的习惯先切目录,而每次调用是一个新进程,cd 不会带到下一条命令:
RUN_SHELL_SCHEMA = {
    "type": "function",
    "function": {
        "name": "run_shell",
        "description": (
            "在本地执行一条 Shell 命令,用于写文件、查看日期、"
            "列出目录等没有专门工具的操作。不要用 cd 切换目录,要切目录请用 cwd 参数。"
        ),
        "parameters": {
            "type": "object",
            "properties": {
                "command": {"type": "string", "description": "要执行的整条命令"},
                "cwd": {"type": "string", "description": "工作目录,默认当前目录"},
            },
            "required": ["command"],
        },
    },
}
get_weather 和 calculator 的实现与上一篇相同,这里不重复。
TOOL_FUNCTIONS = {
    "get_weather": get_weather,
    "calculator": calculator,
    "run_shell": run_shell,
}

def execute(name: str, raw_arguments: str) -> str:
    func = TOOL_FUNCTIONS.get(name)
    if func is None:
        return f"调用失败:不存在名为 {name} 的工具。可用工具:{', '.join(TOOL_FUNCTIONS)}。"
    try:
        args = json.loads(raw_arguments or "{}")
    except json.JSONDecodeError:
        return "调用失败:参数不是合法的 JSON。请重新生成参数后再调用一次。"
    try:
        return func(**args)
    except TypeError as e:
        return f"调用失败:参数不匹配({e})。请按工具 Schema 重新生成参数。"
    except Exception as e:
        return f"调用失败:{type(e).__name__}: {e}。请检查参数后重试,或改用其他工具。"
系统指令里补一句,让模型知道操作本地环境可以使用run_shell。
SYSTEM_PROMPT = """你是一个查询助手,可以调用工具来查天气、做计算,也可以执行 Shell 命令操作本地环境。

工作规则:
1. 需要外部信息时,调用相应的工具,不要自己编造数据。
2. 写文件、查看本机日期这类没有专门工具的操作,使用 run_shell。
3. 一步做不完的任务,就分成多步,拿到结果再决定下一步。
4. 当你已经拿到足够的信息、能够回答用户的问题时,直接用自然语言给出最终答案。
"""

messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": "北京和上海今天的温差是多少度?把结果写到 ./report.txt。"},
]
跑起来的日志会多一轮命令调用,前面查天气、算差值的步骤和以前一样:
===== 第 1 轮 =====
模型决定调用工具:get_weather,参数:{"city": "北京"}
工具返回:{"city": "北京", "weather": "晴", "temp_celsius": 12}

===== 第 2 轮 =====
模型决定调用工具:get_weather,参数:{"city": "上海"}
工具返回:{"city": "上海", "weather": "多云", "temp_celsius": 19}

===== 第 3 轮 =====
模型决定调用工具:calculator,参数:{"expression": "19 - 12"}
工具返回:{"expression": "19 - 12", "result": 7}

===== 第 4 轮 =====
模型决定调用工具:run_shell,参数:{"command": "printf '%s\\n' '北京 12 度,上海 19 度,温差 7 度' > report.txt"}
工具返回:退出码:0
(命令没有任何输出)

===== 第 5 轮 =====
模型给出最终答案,结束循环

最终答案:北京今天 12 度,上海今天 19 度,温差 7 度。结果已写入 ./report.txt。
三、沙箱 Sandbox 和 人工审批
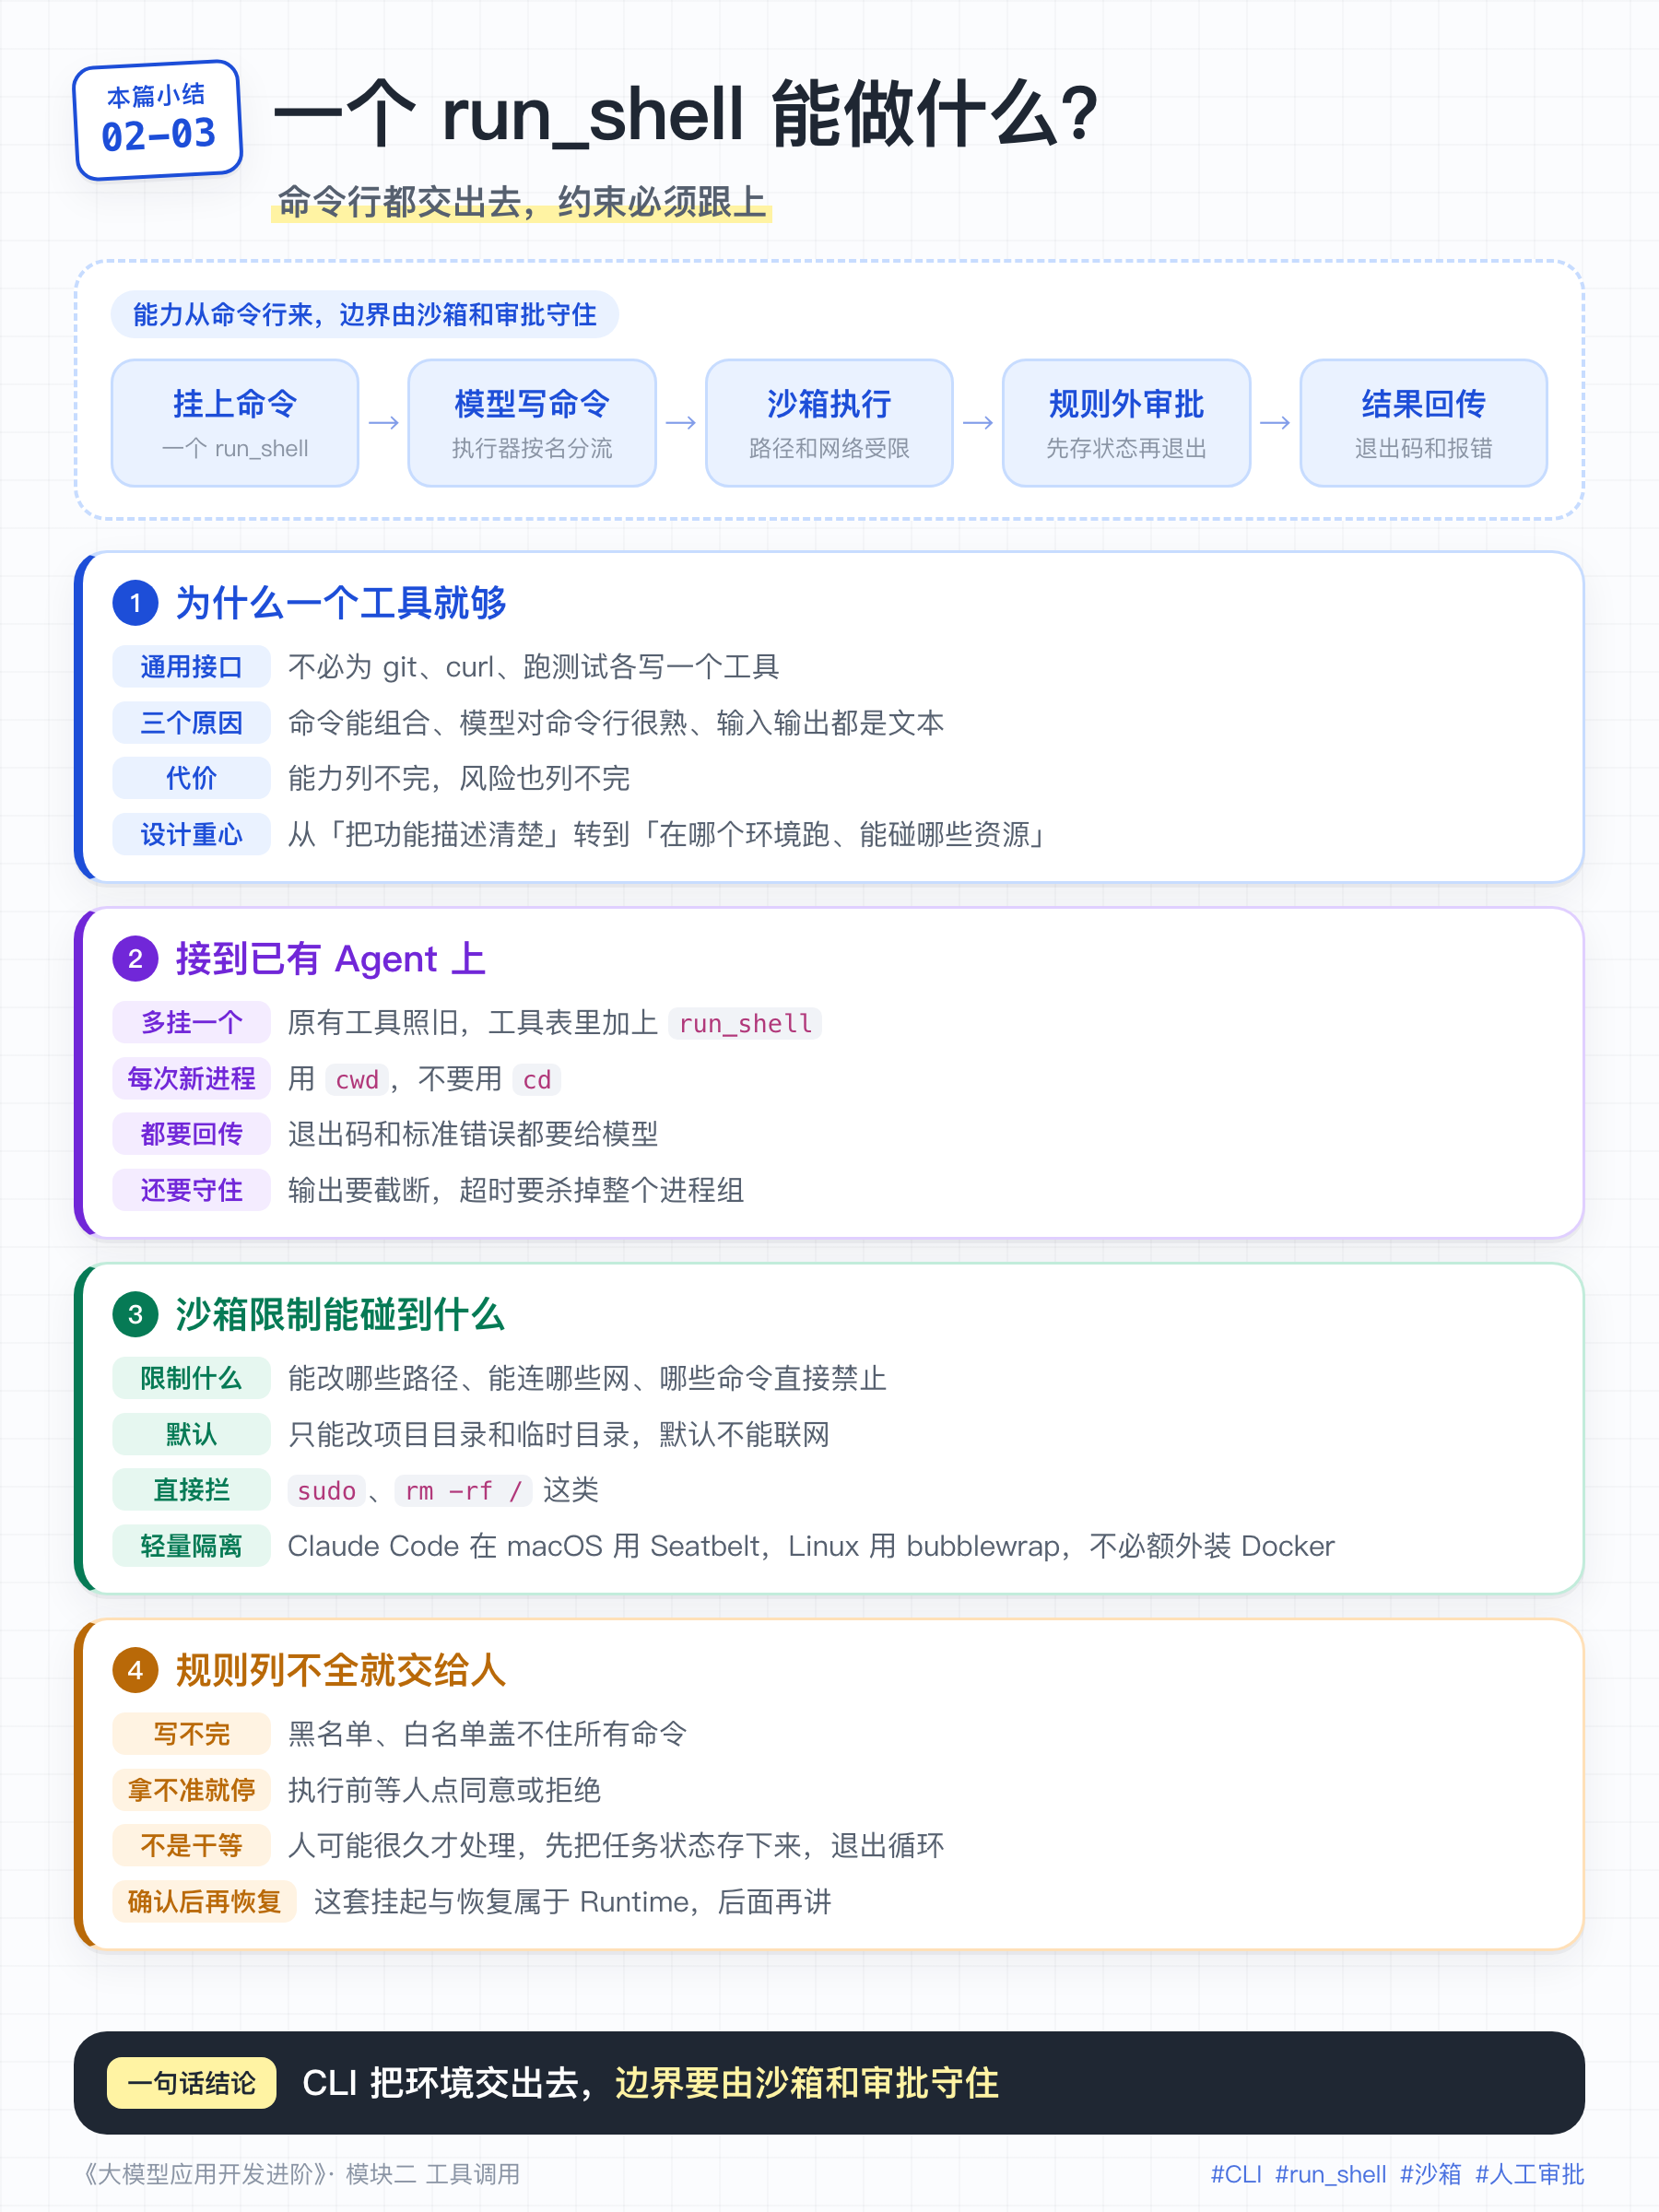
前面也提到,一旦模型可以执行命令,安全性就是一个很大的问题,因为它可以让计算机执行任何事情,比如,删文件、看环境变量、把密钥发到外网,都可能发生。要让它“能干活但闯不了大祸”,主要靠两件事:沙箱和人工审批。
沙箱(Sandbox)就是给 Agent 一个受限环境。
Docker就是常用的一类沙箱。而 Claude Code 和 Codex 这类编程 Agent 的沙箱,追求的目标是轻量、开箱即用,不需要用户额外安装 Docker,所以它们直接使用了操作系统内置的安全机制。
Claude Code 使用操作系统自带的安全原语,按平台分:
- macOS:使用苹果内置的 Seatbelt 框架(
sandbox-exec),开箱即用,无需安装额外软件。 - Linux / WSL2:使用 bubblewrap(
bwrap)进行隔离,需要用户提前安装bubblewrap和socat两个包。
Codex 同样使用操作系统级别的沙箱,这里就不展开罗列了,你了解即可。
操作系统沙箱的工作方式,是在操作系统层面限制 Bash命令能访问的文件路径和网络域名,而不是启动一个完整的容器或虚拟机。
具体来讲,Claude Code 和 Codex 主要限制三件事:
- 能改哪里。 默认只能改项目目录和临时目录,不能写系统目录、
~/.ssh。Codex 的只读模式连项目都不能改。工作区可写模式下,.git也只读,防止偷偷改版本记录。 - 能连哪里。 默认不能联网,访问新网站要用户同意。这样就算被骗执行
curl,密钥也传不出去。 - 能跑什么。 危险命令直接禁止,敏感命令先问用户允许。比如
sudo、rm -rf /禁止;rm -rf、git push --force询问用户。
命令黑名单、白名单,没办法把所有的命令罗列全,因此,对于一些规则外的操作、是否危险不确定的操作、或者依赖人来判断是否可以执行的操作,Claude Code、Codex等会执行前先把命令停住,交给用户审批。
审批看起来只是「弹窗等一下」,实现起来却没这么简单:人可能几分钟、几小时后才处理,控制循环不能一直卡在那里干等。所以真正的做法是把任务的状态存下来、先退出循环,等人确认后再从存档恢复着往下跑。这套挂起与恢复依赖 Agent 的状态能被持久化保存,属于Runtime的范畴,后面会详细讲解。
本篇小结
09-Skills—封装可复用的专业能力
网上经常有个人把Skills跟MCP来对比,其实两者关系不大,但是,开发Agent,你多半也用不到Skills。它们一般是Claude Code、Codex等Agent提供的一个开放功能,允许用户制定自己的工作规范。
但是,为了保证提供给读者的内容比较系统全面,我们这里稍微介绍下Skills。
一、Skills 要解决的问题
前面已经把工具交给了 Agent。有了工具,模型就能查数据库、写 Excel、生成图表。但工具只解决「能做」,不规定「这件事在我们这里应该怎么做」。
没有这份规定时,模型只能自己判断:营收取哪个字段、列按什么顺序、金额用什么单位。它可能交得出一份报表,但结果可能不能完全满足你的需求。
公司里有一类事情,步骤和规则是固定的,出月报、写周报、按规范回复客户都是。这类事情如果只给模型一个目标和一套工具,它每次都会按自己的理解组织步骤,结果就不稳定。更稳的做法,是把固定流程写成一份操作手册,交给模型按手册执行。
可以对照带一个新人做事。你只给他查数的权限、Excel,以及「出一份月报」这个目标,他多半能把事情做完,但表头顺序、含税还是不含税、用元还是万元,都会按自己的理解来。如果再给他一份操作手册:营收用不含税字段、固定五列、单位统一万元,他就知道该怎么做,也知道哪些做法是错的。
这份交给模型的操作手册,就是 Skill。
Anthropic 在 2025 年 10 月把 Skills 作为 Claude 的功能推出,并在 2025 年 12 月进一步发布为开放规范。现在 Claude Code、Cursor、Codex 等产品都已支持。通常大家说的 Skills,就是往技能目录里放一份 SKILL.md(以及可选的脚本、模板、资源),让模型按手册做事。
不过,自己写业务 Agent 时,团队不一定会直接实现这套规范。固定流程写进 System Prompt、用 RAG 检索、或者做成工作流,仍然更常见,大多数项目不会用 SKILL.md 这一套来做。
是否需要实现 Skills,取决于你在做什么:如果你在做类似 Claude Code 的产品,要给用户一个自己加手册的扩展口,它就很合适。
所以,本节课的内容,跟Agent开发关系不大,你大概率也用不到,写它的目的,主要这东西挺火,必须拿来讲讲。
二、一个 Skill 长什么样
我们看一份完整的 Skill 长什么样子。
Skills 的定义极其简单:一个 Skill 就是一个文件夹,里面至少有一个 SKILL.md 文件。
monthly-financial-report/
├── SKILL.md              # 必需:元数据 + 操作说明
├── references/           # 可选:详细的参考资料
│   ├── 科目对照表.md
│   └── 报表模板说明.md
├── scripts/              # 可选:可执行脚本
│   └── build_report.py
└── assets/               # 可选:模板、字体、图片
    └── report_template.xlsx
SKILL.md 由两部分组成:一段 YAML 元数据,后面跟 Markdown 正文。
---
name: monthly-financial-report
description: 生成公司月度经营报表。当用户要求出月报、月度经营分析、月度财务报表,
  或者要求统计某个月的营收、成本、毛利、同比环比时使用。包含取数规则、表格结构
  和 Excel 输出格式的完整规范。
---

# 月度经营报表

## 数据来源

用 `db__query` 工具查 `fact_revenue` 和 `fact_cost` 两张表。营收一律取
`amount_excl_tax` 字段(不含税),不要用 `amount`,后者是含税金额。

## 报表结构

固定五列,顺序不能变:科目、本月、上月、环比、去年同月同比。
金额单位统一为万元,保留两位小数。科目顺序见 references/科目对照表.md。

## 生成步骤

1. 查出本月、上月、去年同月三组数据。
2. 运行 `python scripts/build_report.py --month YYYY-MM --data data.json`,
   它会按模板计算同比环比并写出 Excel。不要自己算这些比率。
3. 把生成的文件路径告诉用户,并用三到五句话总结变化最大的科目。

## 注意

- 数据缺失时不要填 0,写「-」并在总结里说明缺哪个月的数据。
- 毛利率异常(低于 15% 或高于 60%)时要在总结里提示需要人工复核。
元数据里 name 和 description 是必填的,其余可选。
name 不超过 64 个字符,只能用小写字母、数字和连字符;description 不超过 1024 个字符。
可选字段包括 license、compatibility(声明环境依赖,比如需要哪些系统包、要不要联网)、metadata,以及还在试验阶段的 allowed-tools(预先声明这个技能允许用哪些工具)。
正文部分没有格式限制,能让模型按说明正确执行即可。
三、渐进式披露:Skills 的核心机制
上面那个文件结构并不特殊,Skills 真正的特殊的地方在于其加载方式。它用的是渐进式披露(Progressive Disclosure)。
一个 Skill 分三层,每一层只在需要时才进入上下文。
第一层:元数据,启动时全部加载。
Agent 启动时,把每个已安装技能的 name 和 description 读出来,拼进系统提示词。一个技能的元数据大约一百个 Token,二十个技能加起来两千 Token 左右,常驻上下文。模型此时只知道「有这么一个技能,它是做什么的、什么时候该用」,不知道具体怎么做。
第二层:SKILL.md 正文,判断相关时才读。
模型判断当前任务与某个技能相匹配,就用文件读取工具把这个 SKILL.md 完整读进来,这时候模型才知道详细步骤。
第三层:附带的文件,用到才读。
正文里引用的 references/科目对照表.md,只有真正需要查科目顺序时才读。
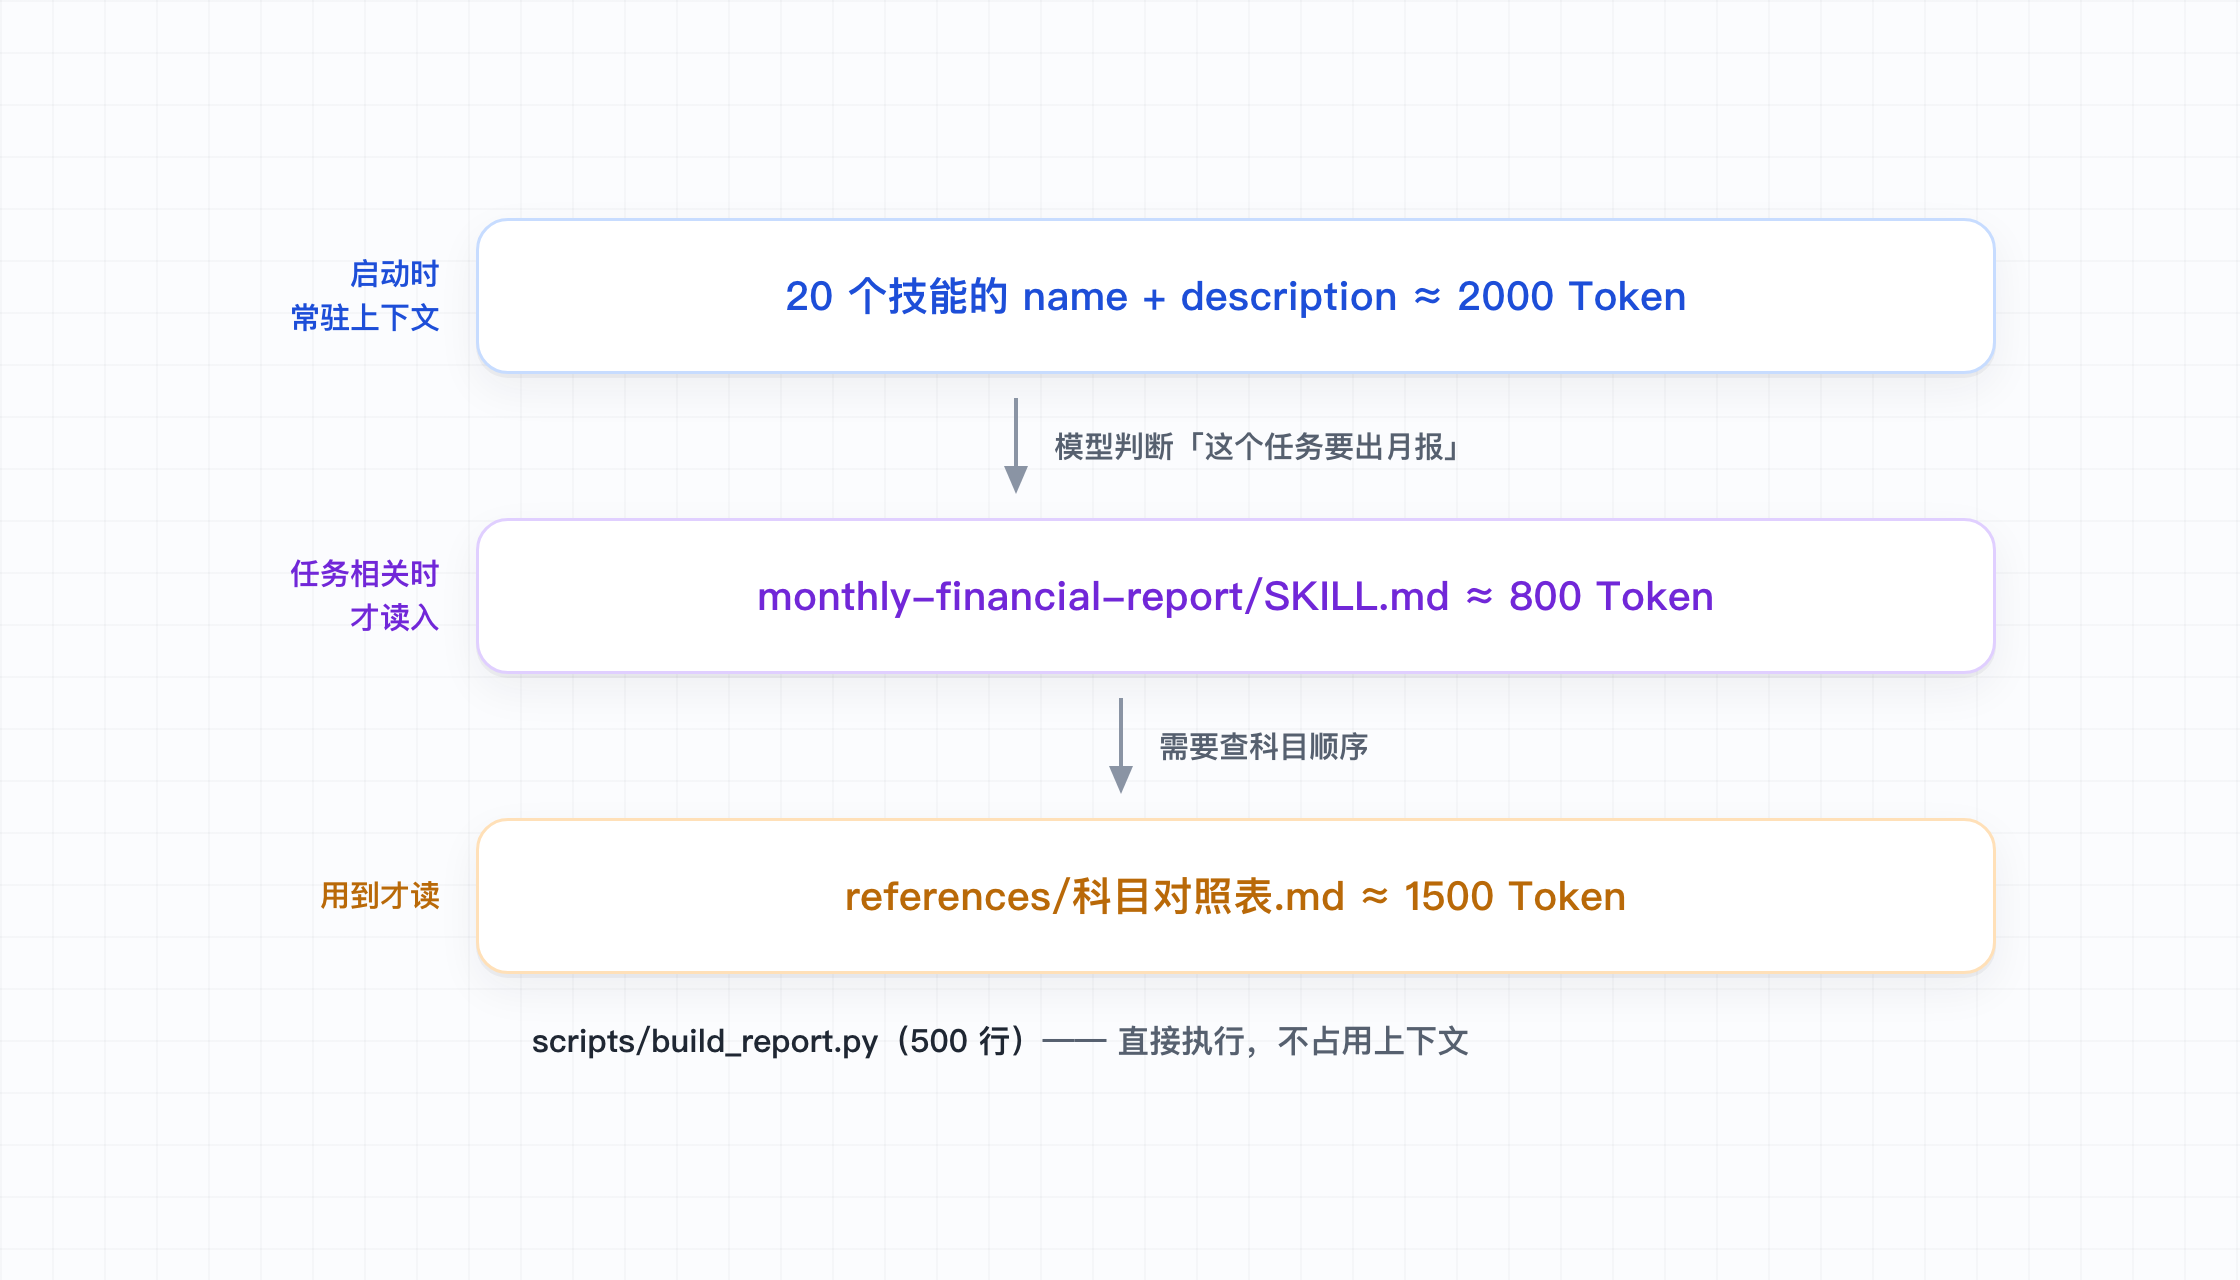
脚本可以只执行、不读取。模型完全不需要看 build_report.py 的代码,它只要知道「运行 python scripts/build_report.py --month 2026-08」即可。一个五百行的脚本,占用的上下文是零。
这一点同时解决了两个问题。省上下文只是其一,更重要的是它不再把确定性的计算交给模型处理。
模块一第 1 篇讲过那条原则:凡是能用确定性代码保证的事情,就不要交给模型去决策。同比环比怎么算、金额怎么换算成万元、Excel 的单元格格式怎么设,这些每次都一样,让模型每次重新推理一遍,既慢又可能算错。写成脚本,结果就能保持一致。
渐进式披露还带来一个必须重视的问题:description 是模型判断要不要加载这个技能的唯一依据。 第一层里除了名字就只有它,写不好,技能就不会被触发,你会以为技能没生效,实际上是模型根本不知道该用它。
反例:
  description: 报表相关的规范和流程说明。

问题:太抽象。用户说「帮我出一下 8 月的经营情况」,模型看到「报表相关」,
      未必能对应上,很可能自行生成,而不加载技能。

正例:
  description: 生成公司月度经营报表。当用户要求出月报、月度经营分析、
    月度财务报表,或者要求统计某个月的营收、成本、毛利、同比环比时使用。
    包含取数规则、表格结构和 Excel 输出格式的完整规范。

优点是:既说了做什么,也把用户可能的各种说法列了出来,模型能够对应上。
写 description 的要点是把用户实际会说的词写进去,而不是用你内部的术语概括。
另外,规范建议文件引用只保持一层深。也就是 SKILL.md 直接引用 references/ 下的文件,不要让那个文件再引用第三个文件。链条一长,模型很容易在中间某一跳就停止读取,或者顺着链条读进来一批不相关的内容。
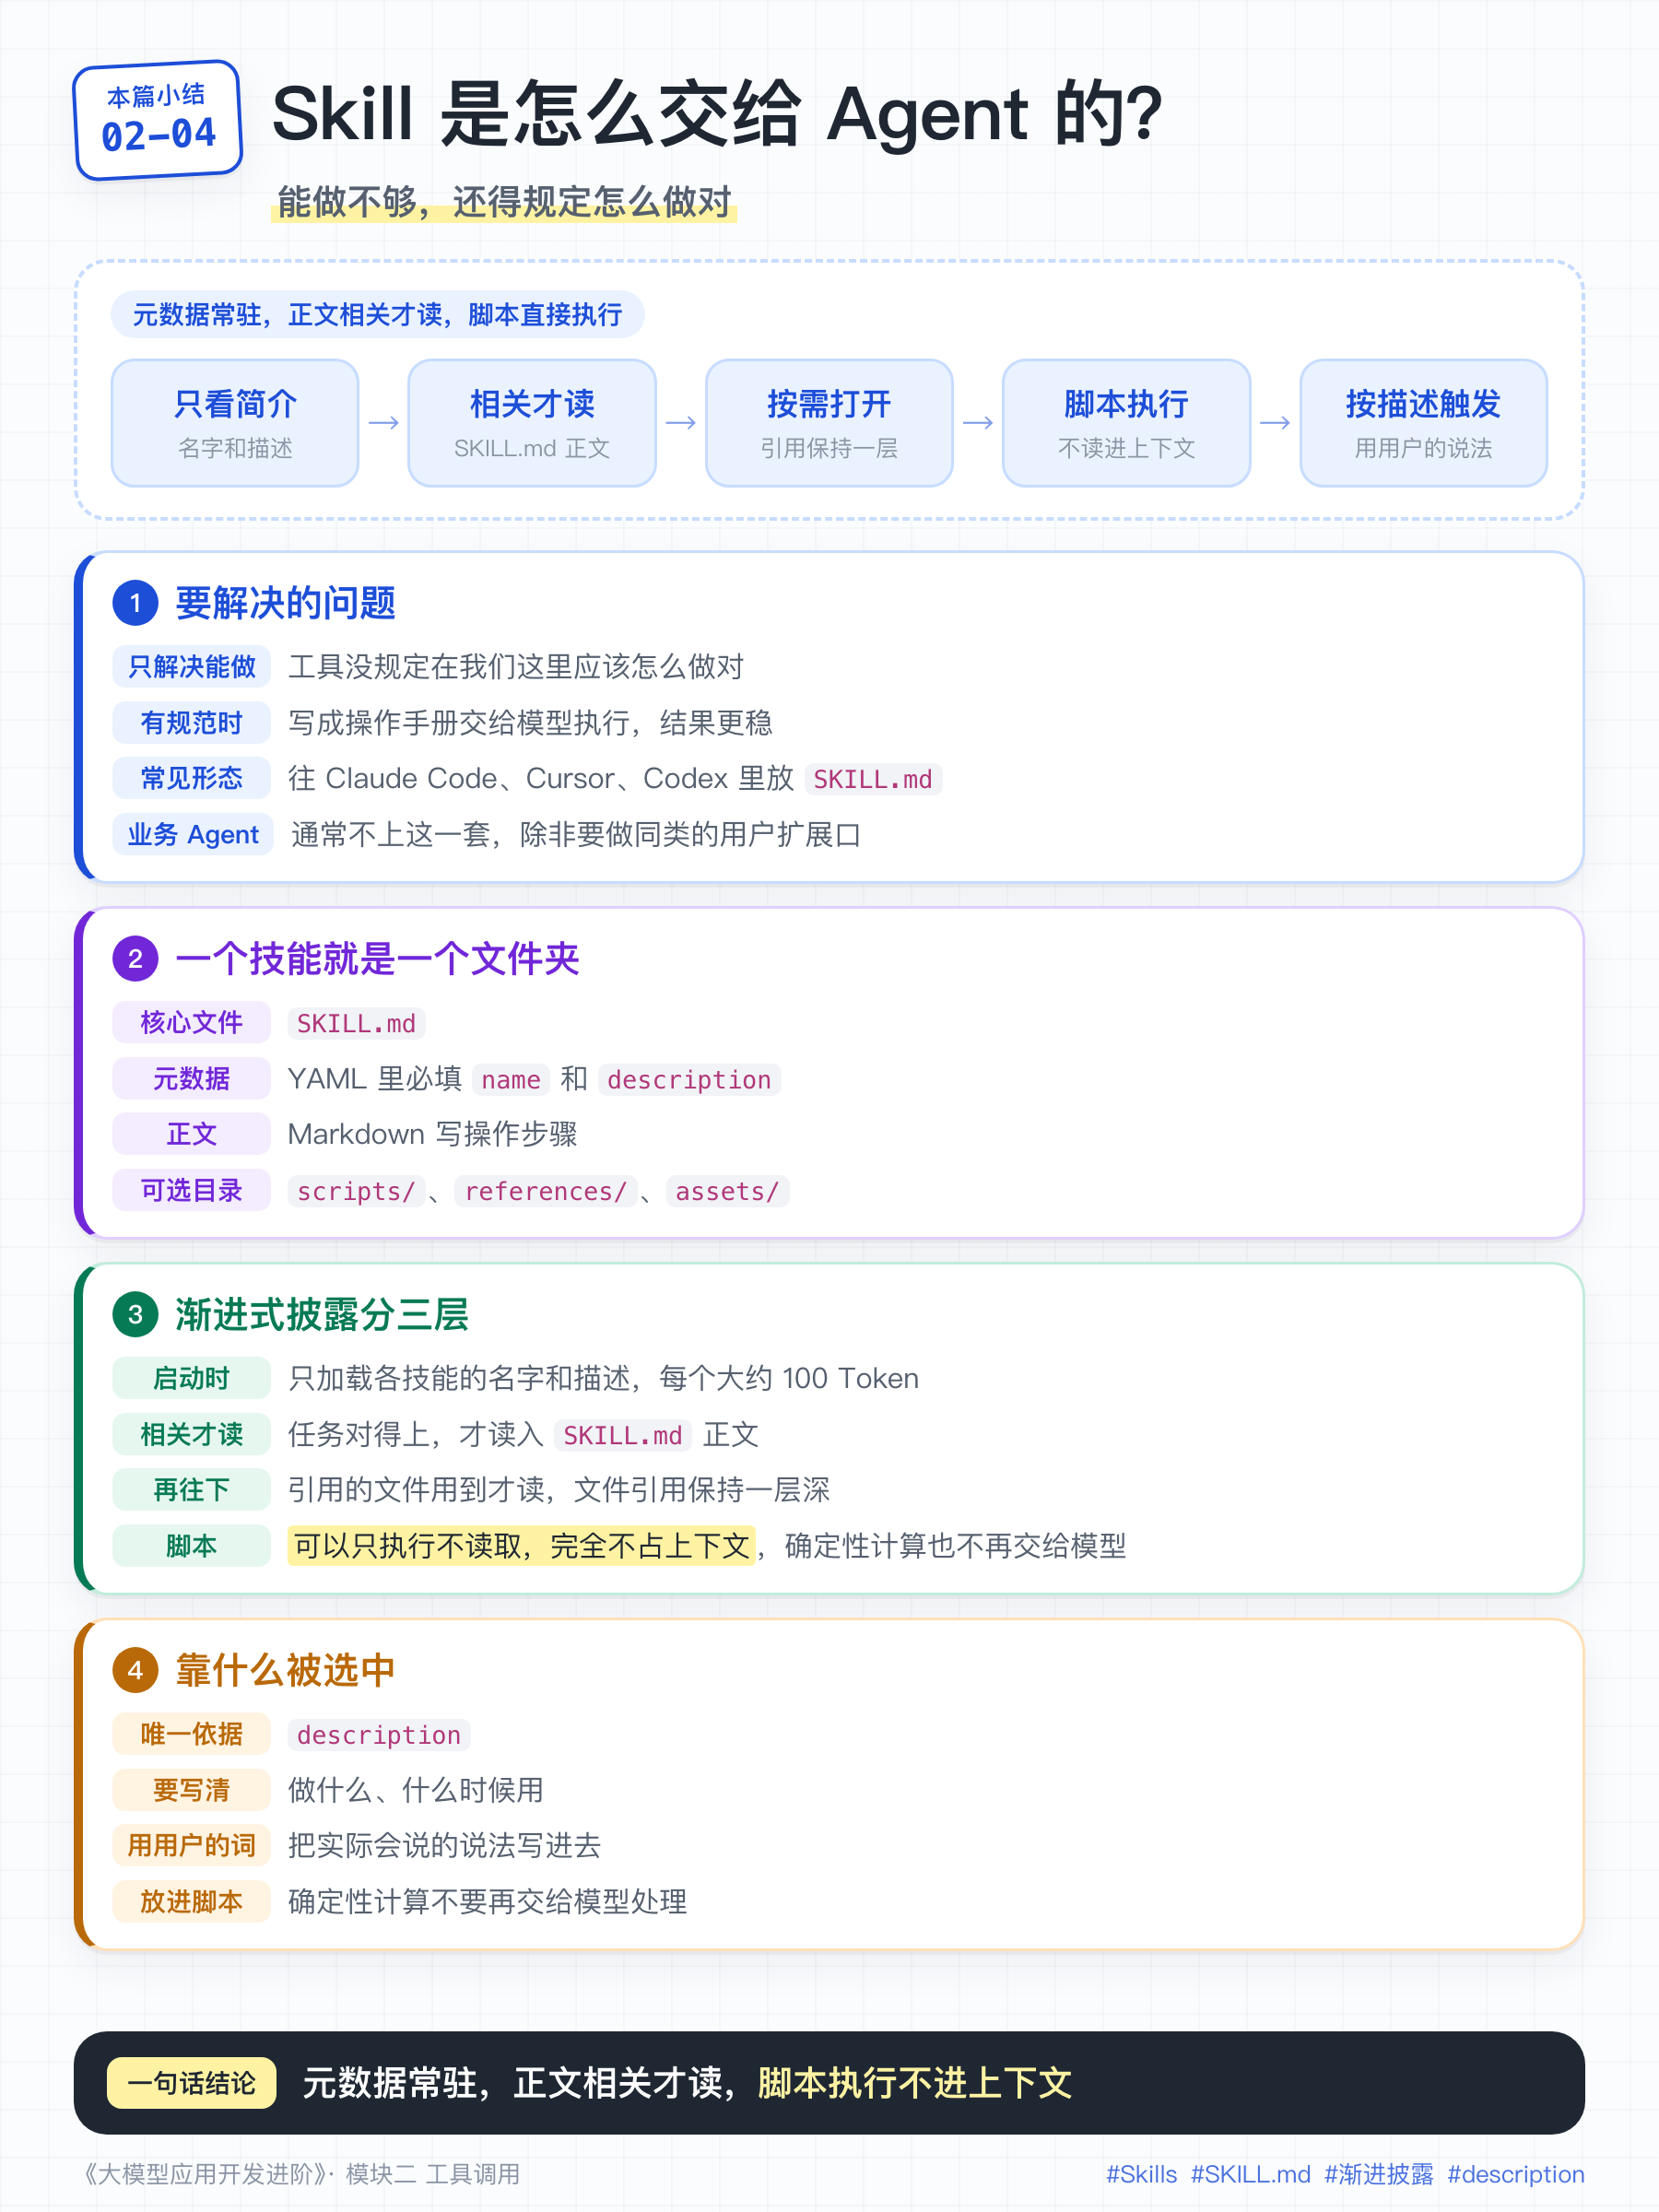
本篇小结