03-分层记忆
03-分层记忆
10-为什么Agent需要记忆系统
你每天用 Claude Code、Codex 写代码,多半已经习惯了一种「它好像记得之前我说的话」的感觉。
同一次会话里,你先说「这个项目的列表接口统一用 cursor 分页,不要用 offset 分页」。过了十几轮,读完文件、改完代码、测试挂了又修好,你再说「对账明细接口也加上同样的分页」。它通常不会再问你「同样」是什么意思,而是按照之前的约定用 cursor 分页的方式去修改对账明细接口。
只要这次会话还没结束,前面说过的话、读过的文件、跑过的测试,它都还能记得,这是会话内的记忆。
隔天你新开一个会话,输入「给售后单列表接口加上分页」,Claude Code 仍然能够按照之前你要求的方式添加分页。
会话关了,记忆还在,新开会话,还能用得上,这是跨会话的记忆。
基础课讲过大模型本身没有记忆,API 也是无状态的。 模型处理这一次请求时,只看你这次传进去的内容,既不记得上一轮,也不会替你保存昨天的对话。
「记得」从来不是模型自带的能力,而是 Agent 要具备的能力,「记忆系统」是每个Agent必备的。这一模块,我们就来讲讲如何为Agent构建记忆系统。
一、短期记忆—对话历史
记忆按照生命周期分为两类:短期记忆和长期记忆。前面提到的会话内记忆,就是短期记忆,跨会话记忆,就是长期记忆。
短期记忆指的是这次任务还在进行时,Agent 当前用得上的信息;任务一结束,这些信息就不该继续作为永久事实保留下来。有些资料里还把它称作是工作记忆( working memory)。
模块一写最小 Agent 时,那个不断增长的 messages 列表,做的就是这件事。用户说的话、模型的回复、工具返回的结果,都按时间追加进 messages。下一轮调用时,整份 messages 列表再发给模型。
# 最小 Agent 里,messages 就是这一次会话的短期记忆
messages = [
    {"role": "system", "content": "你是订单服务的开发助手。"},
    {"role": "user", "content": "给订单列表加分页,统一用 cursor,不要 offset。"},
]
# 每一轮:追加本轮消息,再整份发给模型
response = client.chat.completions.create(
    model="gpt-5.6",  # 生产环境应锁定到带日期的快照 ID
    messages=messages,
)
messages.append({"role": "assistant", "content": response.choices[0].message.content})所以,会话内的对话历史,就是短期记忆最基本的形态。
接下来一个工程问题就来了:这份列表只活在当前进程的内存里,够不够?
不够。用户关掉会话页面、过一会儿再回来继续,Claude Code宕机重启,原来的会话还可以继续进行,这些需求的实现,都要求对话历史不能仅仅放在内存中。如果 messages 只在内存里,进程一停,这一次会话的历史就都丢了,会话就无法继续进行。
因此,对话历史必须持久化。常见做法是按 user_id + session_id 把消息列表写到 Redis、MySQL、PostgreSQL 等,跟其他业务数据的持久化方式无异。键必须把不同用户的不同会话隔开:你这次改对账明细的记录,不能出现在别人的会话里,也不能串到你自己另一个会话里。
不过,Claude Code,它的对话历史没有存在数据库中,而是存在用户本地机器的文件里。当前会话会持续写成 ~/.claude/projects/ 下的一份 JSONL文件,如下所示。其中,-Users-zheng-code-codecrush 是你当时的工作目录( /Users/zheng/code/codecrush ):把路径里的斜杠等非字母和数字的字符换成 -。文件名是这次会话的 ID,一般是一个 UUID。
~/.claude/projects/-Users-zheng-code-codecrush/a3f2c8e1-4b19-4d2a-9c11-7e8f0a1b2c3d.jsonl打开就是一行一条 JSON,用户说的话、助手回复、工具结果按时间往下追加:
{"type":"user","message":{"role":"user","content":"这个项目的列表接口统一用 cursor 分页,不要用 offset 分页"}}
{"type":"assistant","message":{"role":"assistant","content":"我先读 OrderController"}}
{"type":"user","message":{"role":"user","content":"对账明细接口也加上同样的分页"}}
历史一长,新的问题就出现了,如果每次完整塞回去,一来会超过上下文窗口的限制,二来会导致Lost In Middle 问题。这些前面都讲过了。
工程上最常见的处理是:把更早的对话调用大模型压缩成一段摘要,然后每次用户发送消息时,只需要把摘要、最近几条对话和当前用户消息打包发送即可,这样既节省了Token,又让大模型了解了历史对话情况。
还是用前面那个分页任务。假设前面已经有N多轮对话,用户新说了一句「跑一下测试」,这时上下文窗口已达到上限,于是就会启动历史对话压缩,然后,这一次发给模型的 messages,就变成了:
messages = [
    {
        "role": "system",
        "content": "你是订单服务的开发助手。",
    },
    # 摘要
    {
        "role": "user",
        "content": "【对话摘要】列表接口统一用 cursor 分页,不要 offset。OrderController 已改完,OrderControllerTest 已通过。查询必须写出字段,不要写 select *。",
    },
    # 最近几条
    {
        "role": "user",
        "content": "对账明细接口也加上同样的分页",
    },
    {
        "role": "assistant",
        "content": "已经按 cursor 改好 ReconciliationController,用 nextCursor 往下翻。",
    },
    # 当前用户消息
    {
        "role": "user",
        "content": "跑一下 ReconciliationControllerTest",
    },
]
摘要里是已经结束的旧过程,最近几条是刚说完的原文,最后一条才是用户刚刚输入。改列表时读过哪些文件、某次编译报了哪一行错,已经不在这次请求里了。真实项目可能会多留几轮原文,看 Token 还剩多少。
不过,压缩对话历史也有有代价的,即摘要会丢细节,因此,摘要怎么压缩非常有讲究,不过,这不是我们这个模块要解决的问题,是下一个模块「上下文工程」的事。这里先记住结论:短期记忆一般是完整对话历史,在超过上下窗口之后,短期记忆会变为:早期对话历史摘要 + 最近几轮对话历史。
二、短期记忆—工作状态
大多数对话助手(比如ChatGPT、DeepSeek)、短任务的 Agent,短期记忆做到上一小节讲的就够了。
对于复杂Agent,比如编程助手(Claude Code、Codex),要读文件、改代码、跑测试、修bug等等,一轮任务可能走几十步甚至上百步。这时候只靠对话历史就有点不够用了。
对话历史是按时间追加的流水账。任务进行到后面,模型要自己从几十轮对话里,翻出「目标是啥」「方案是啥」「已经完成了哪些」「现在在做啥」「下一步该干啥」等等这些跟开发进度有关的信息,就可能会出现偏差。
更麻烦的是,上一小节讲到,压缩摘要会丢失细节,而目标、方案往往是开头定下来的,对话历史持续变长,越往后Agent就越糊涂,越偏离原来的目标和方向。
所以,对于复杂Agent来说,短期记忆,除了包含对话历史,还需要记录工作状态(state)。说白了,工作状态的目的就是为了让长任务不跑偏,让它能严格按照制定的计划逐步完成的增强手段。
我们可以拿开发来举例,如果只是一个简单的功能开发,10分钟就能搞定,你可以直接上手写代码,所有的信息都保存在脑子里,每一个函数、每一个类,都是拿脑子里的全量信息去指导如何写。因为简单,脑子的上下文窗口足够容得下所有信息,还不会丢失细节,所以,开发的过程很顺利。
相反,如果开发一个复杂的功能,一个礼拜才能搞定,如果直接上手写代码,写着写着就得回忆之前方案是啥、完成了哪些,还得做哪些等等信息,脑子的上下文窗口不够了,就开始丢三落四,很难一次性写出正确的代码。
如果我们先把开发计划写到一个文档里,然后再去对照着执行,每完成开发计划中的一步,就回来重新看一眼开发计划文档,这样就能有条不紊的开发下去。
人和大模型做的是同一件事,只是「脑子」和「计划文档」换成了对话历史和工作状态:
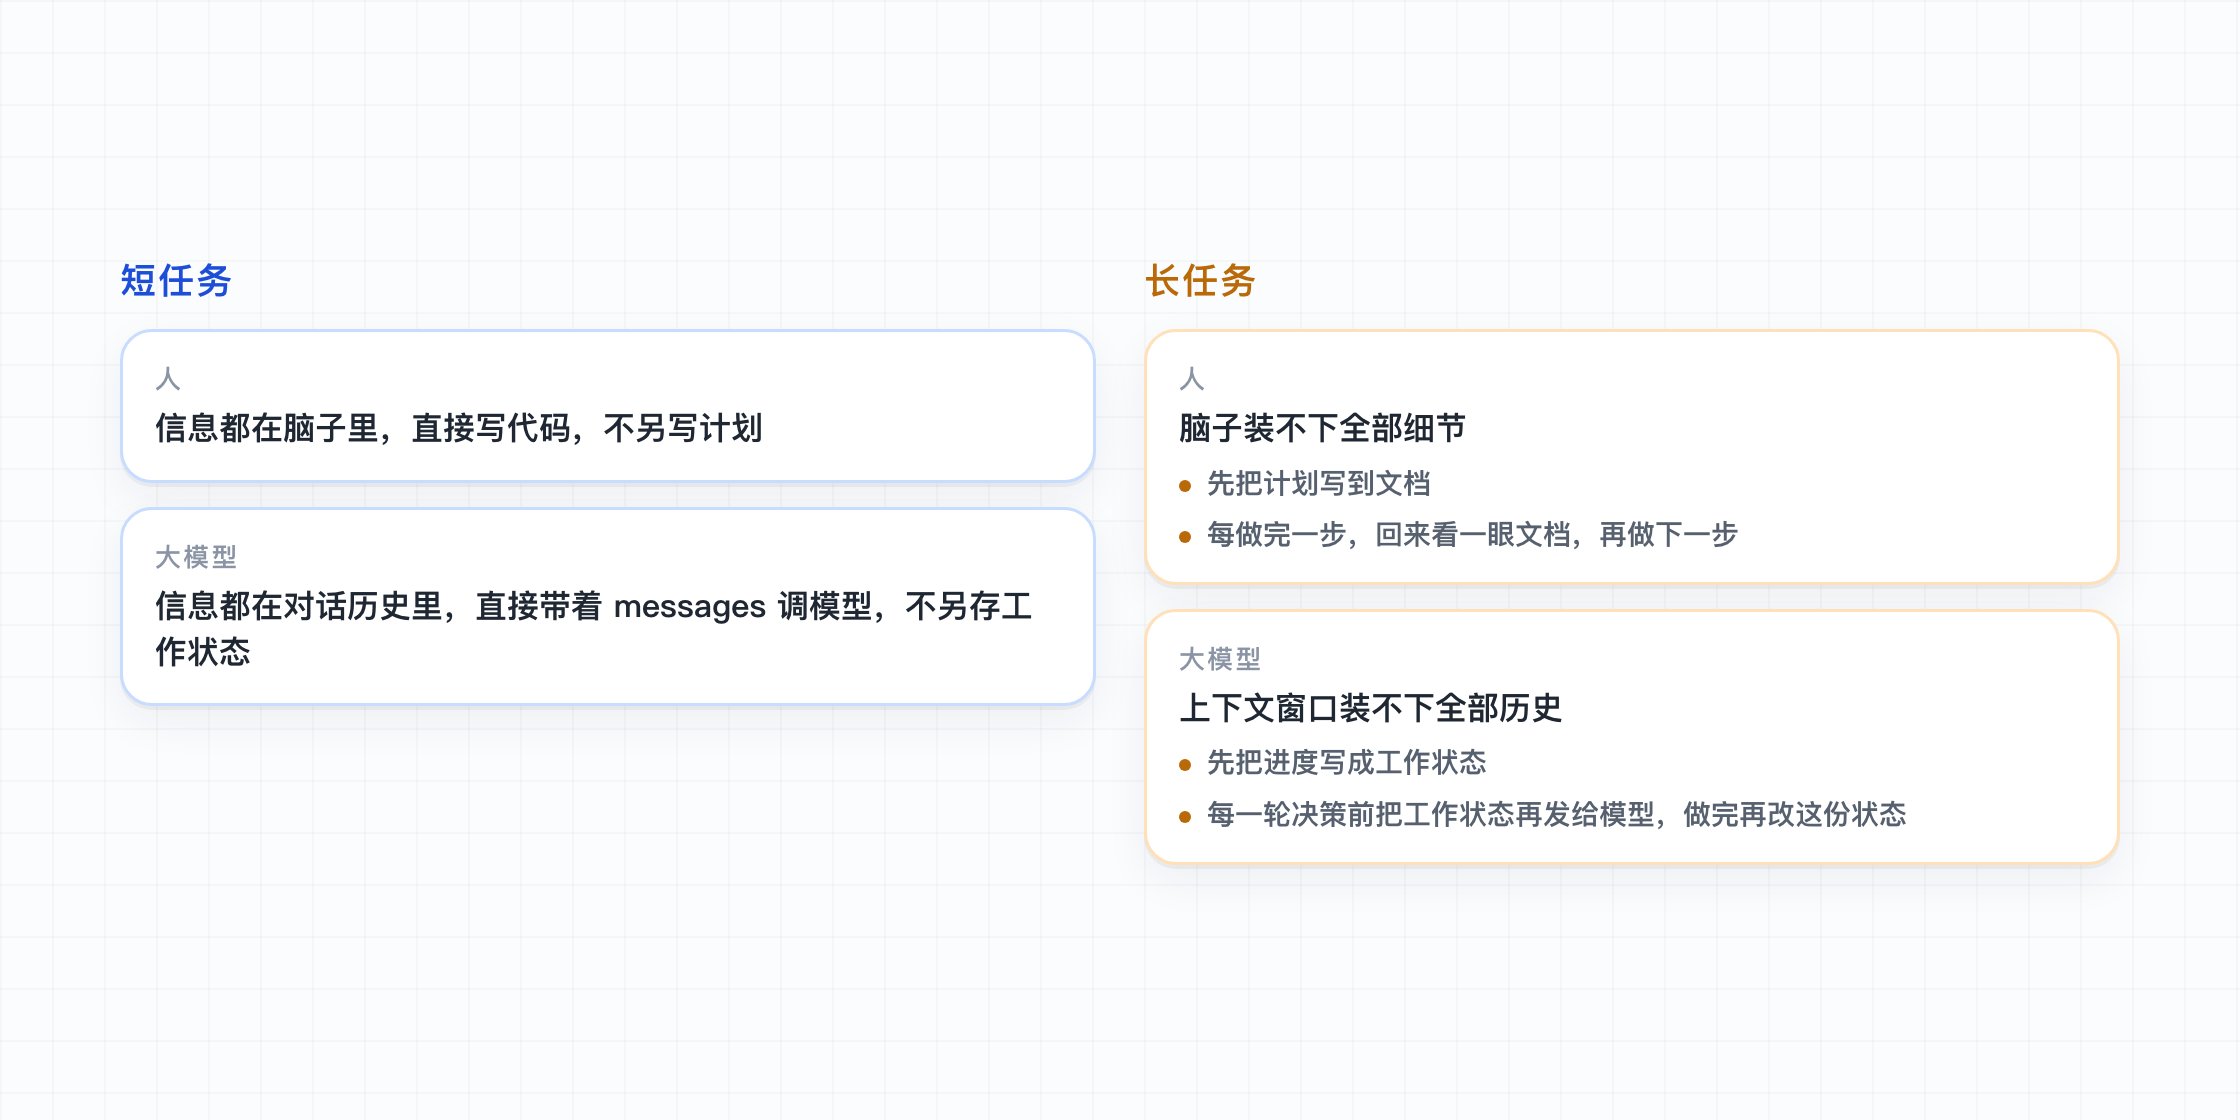
你看,人脑和大模型是不是非常类似。其实,人类的很多做事、思考方式,都可以借鉴到Agent开发中。
了解了工作状态是什么之后,我们来看,工作状态记录什么内容?
工作状态到底记录什么信息,笼统点就就是工作计划,比如,任务目标、方案、待办列表、下一步工作等等,具体记点啥,跟你的业务强相关,这不是一个技术问题,而是一个业务问题。我们给一个简单的示例:
{
  "goal": "对账明细列表改成 cursor 分页,和订单列表同一套约定",
  "plan": "对照已经改完的 OrderController,给 ReconciliationController 加上 nextCursor / prevCursor。查询写出字段,不要 select *。改完跑 ReconciliationControllerTest。",
  "todos": [
    {"id": "1", "subject": "读 OrderController,确认 cursor 分页写法", "status": "pending"},
    {"id": "2", "subject": "改 ReconciliationController", "status": "pending"},
    {"id": "3", "subject": "跑 ReconciliationControllerTest", "status": "pending"}
  ],
  "next_step": "1"
}
对于复杂长任务,通过系统提示词,让大模型在任务开始就生成工作状态(一般是 JSON 格式的),并通过调用工具持久化,比如写入文件、数据库。Claude Code 的 Plan 模式就是这样做的,后面讲到的Plan-And-Execute架构模式的过程也是类似的。
messages = [
    {
        "role": "system",
        "content": """你是一名编程开发助手。用户交给你的是多步开发任务时,先生成工作状态,再按这份状态推进。

工作状态的格式(JSON):
{
  "goal": "这次要做成什么",
  "plan": "当前采用的方案",
  "todos": [
    {"id": "1", "subject": "待办内容", "status": "pending"},
    {"id": "2", "subject": "待办内容", "status": "pending"}
  ],
  "next_step": "1"
}

next_step 的值是当前要做的那条 todo 的 id。上面这份里,下一步就是 id 为 "1" 的那条。做完了改成 "2"。
status 取 pending、in_progress、done、failure。

规则:
1. 任务一开始,先调用 write_working_state 把这份 JSON 写出去,再开始读代码、改文件。
2. 目标、方案、进度变了,就再调用一次 write_working_state,用最新的一份覆盖旧值,不要追加。
""",
    },
    {
        "role": "user",
        "content": "这个项目的列表接口统一用 cursor 分页,不要用 offset 分页。请给对账明细接口也加上同样的分页。",
    },
]
每次对话,Runtime都将这份工作状态放入 messages中 一并发送给大模型,具体位置是对话历史的后面,用户最新消息的前面,原因是大模型对上下文的首和尾注意力最强。这样,即便对话历史会被压缩摘要,丢失细节,但是,工作状态永远都不会丢,大模型就不会跑偏。
二、长期记忆
长期记忆,就是跨会话的记忆。
你昨天用 Claude Code 把列表改成 cursor 分页方式,还纠正过「查询不要写 select *」,测试命令也确认过用哪个。
今天新开一个会话,说「给售后单列表接口加上分页」。如果没有跨会话的记忆,接下来几乎可以料定:它重新搜索代码,按最常见的 offset 分页写一版,测试怎么跑也要再问一次。昨天定下的约定,今天都不在了。
你以为的:  昨天的约定已经留在模型里了
实际发生的: 新会话 → 空的上下文窗口 → 模型从零看起
需要注意的是,对话历史就算已经持久化了,也不是长期记忆。因为对话历史记录的是流水账,没有被整理过,多数信息仅本会话有用,跨会话无用。下次真正用得上的,是「列表统一 cursor 分页」「不要写 select *」这种事实,不是中间那几十轮工具调用日志。
所以,长期记忆要记的,是跨会话还要用的信息,比如用户偏好、经验总结、约束限制等等。还是那句话,具体记哪些东西,需要根据你的业务来。你需要明确的制定好,并写到提示词里告诉大模型去从对话历史中提取。
以下是Claude Code的系统提示词中写的哪些东西需要提取成长期记忆,后面还会具体来讲,这里只是让你有个直观的印象。
## Types of memory

There are several discrete types of memory that you can store in your memory system:

user
Contain information about the user's role, goals, responsibilities, and knowledge.
<when_to_save>When you learn any details about the user's role, preferences, responsibilities, or knowledge</when_to_save>

feedback
Guidance the user has given you about how to approach work — both what to avoid and what to keep doing. Record from failure AND success.
<when_to_save>Any time the user corrects your approach ("no not that", "don't", "stop doing X") OR confirms a non-obvious approach worked ("yes exactly", "perfect, keep doing that"). Include *why*.</when_to_save>
<body_structure>Lead with the rule itself, then a **Why:** line and a **How to apply:** line.</body_structure>

project
Information about ongoing work, goals, initiatives, bugs, or incidents that is not otherwise derivable from the code or git history.
<when_to_save>When you learn who is doing what, why, or by when. Convert relative dates to absolute dates.</when_to_save>

reference
Stores pointers to where information can be found in external systems (Linear, Slack, Grafana, ...).

## What NOT to save in memory

- Code patterns, conventions, architecture, file paths, or project structure — these can be derived by reading the current project state.
- Git history, recent changes, or who-changed-what — `git log` / `git blame` are authoritative.
- Debugging solutions or fix recipes — the fix is in the code; the commit message has the context.
- Anything already documented in CLAUDE.md files.
- Ephemeral task details: in-progress work, temporary state, current conversation context.
我们还是拿人作类比。长期记忆就相当于开发过程中沉淀下来的经验文档,它不会记录某个具体功能的开发流程,而是适用于所有功能开发的经验总结。当你做新的功能开发时,只要去看一眼这个文档,就能获取所有必须的开发经验。而不是去翻看之前N多功能开发的流水账本。
这一次功能开发(工作状态)
  人:把这个功能的开发计划写到文档,做一步看一眼
      记的是这次要做到哪、下一步干什么
      这个功能做完,这份计划就可以收起来了

  大模型:把本次进度写成工作状态,每一轮再带上
         任务结束,这份状态就删掉

跨多次功能开发(长期记忆)
  人: 经验文档不记某个功能怎么一步步做完的
      记的是适用于所有功能的经验
      做新功能时先看一眼这个经验文档
      而不是去翻之前那么多次开发的流水账本

  大模型:新会话的上下文窗口是空的
        只把跨会话还要用的事实写成长期记忆
        新任务开始前先取回相关几条
        而不是把过去那些会话的对话历史再看一遍
长期记忆要比短期记忆处理起来复杂,毕竟生命周期更长,记录的东西会更多,不同的任务需要匹配不同的记忆,记忆中事实也有可能会被更新等等。因此,长期记忆会涉及 提取、存储、召回、更新 几个问题,我们留在下一篇详细讲解。
本篇小结
11-记忆提取、存储、召回、更新
上一篇我们把短期记忆和长期记忆各自要管的事分清楚了:短期记忆跟着这一次会话走,会话一结束就丢掉了;长期记忆是跨会话还成立的事实,会话关了也要留着。我们也说过,长期记忆比短期记忆麻烦,因为它生命周期更长,记的东西更多,还会随着事实变化被改写,所以,要单独处理提取、存储、召回、更新这四步。这一篇就把这四步讲清楚。
还是接着上一篇的那个开发场景。昨天你用 Claude Code 把订单服务的列表接口改成了 cursor 分页,中途纠正过「查询不要写 select *」,测试命令也确认过。今天新开一个会话,说「给售后单列表接口加上分页」。上一篇讲过,新会话的上下文窗口是空的,要让模型今天还能按昨天的约定办事,靠的就是长期记忆这一层。下面从零开始一步步把它实现出来。
一、记录哪些内容
我们先明确一件事:长期记忆存的不是昨天那次会话的流水账,而是一份可改、可删、跨会话还有用的事实表。
昨天那次会话结束后,真正值得留下的只有这样几条事实:
- 这个订单服务的列表接口统一用 cursor 分页,不用 offset。
- 查询必须写出字段,不要写
select *。 - 列表相关的测试命令是
mvn test -Dtest=OrderControllerTest。
中间读过哪个文件、哪一次测试因为漏传参数挂了、某段源码的原文,都不应该放入长期记忆。这些都属于短期记忆,会话一结束就丢掉了。
判断一条信息该不该进长期记忆,我们可以问自己三个问题:
- 三天后再做相关任务,缺了这条会不会重复犯错,或者要再问你一遍?
- 它是已经确认的结论,还是这次任务里还可能改口的中间值?
- 它属于这个用户、这个项目,还是谁都能用的公共知识?
第三个问题用来和 RAG 划清界限。
基础课讲过 RAG,它检索的是人事先准备好的外部知识,比如接口文档、差旅制度,公共的知识应该提前放在RAG里或者直接拼进System Prompt(公共知识较短时)。
而你纠正过的「不要写 select *」,是在交互过程里产生的约束,是针对某个用户、某个项目的,应该走记忆系统。
两者都可以用向量库来存,区别在于来源不同。
二、如何提取
提取就是从对话中发现以后还用得上的事实。事实的抽取是调用大模型来完成的。
from pydantic import BaseModel

LTM_EXTRACT_PROMPT = """从这次任务里抽出值得跨会话保存的事实。
只抽已经确认的结论:项目约定、用户明确提出的约束、反复用到的操作方式。
不要抽:正在改的文件、某一次测试失败、源码原文、还可能改口的中间方案。
如果没有新的稳定结论,返回空列表。"""

class ExtractResult(BaseModel):
    facts: list[str]

def extract_long_term(model, messages: list[dict]) -> list[str]:
    structured = model.with_structured_output(ExtractResult)
    result = structured.invoke(
        [{"role": "system", "content": LTM_EXTRACT_PROMPT}, *messages]
    )
    return result.facts
    # 模型应回:["列表接口统一用 cursor,不用 offset", "查询必须写字段,不要 select *"]
提示词里写清楚要什么、不要什么。最终得到的是一条一条的事实。
当然,为了稳妥,防止模型瞎编,我们还可以给每个事实,关联原对话(即来源),也就是,输出的内容变成了如下这个样子:
# 模型应回:其中,source可以是user、assistant、tool,表明是从哪种类型的消息提取的
[
  {
    "fact": "列表接口统一用 cursor,不用 offset",
    "source":“user”,
    "evidence": "别用 offset,统一 cursor"
  },
  {
    "fact": "查询必须写字段,不要写 select *",
    "source":“user”,
    "evidence": "不要写 select *"
  }
]
那么,什么时候触发提取记忆这个动作呢?一般就三种思路。
- 思路一:
在系统提示词中约定,只要大模型觉得当前的对话有值得提取的记忆,就直接提取并调用工具(工具描述一并给它)存储下来。
我们把提示词在会话的一开始,就发送给大模型,这样,后续在对话的过程中,它发现有值得提取的记忆,就顺道做了。
这种方式完全是由大模型来决定什么时候触发记忆的提取,Claude Code就是这么干的,后面会讲到的。
- 思路二:
在一个会话里面,可能会有多轮对话。我们先来搞清楚什么是“一轮对话”,才能继续往下讲。
一轮对话包含:
用户的任务或者提问(user消息)
模型回复的工具调用消息(assistant消息里包含tool_use)
程序回复的工具调用结果(tool消息)
...可能有好几次工具调用...
模型回复的完成消息(assistant消息,不包含tool_use)
当程序(也就是第一个模块中讲到的运行时Runtime)收到不带tool_use的assistant消息时,就判断已经完成了一轮对话。这个时候,就会独立做一次对这轮对话的事实提取,也就是打包本轮对话的消息,跟写好的提取提示词,一并发给大模型,让它去提取。
Claude Code 其实也用到了这种方法,思路一和思路二两种方法相结合,具体后面会详细讲。
- 思路三:
在整个会话结束之后,再进行提取。程序将整个对话历史打包或者分批发送给大模型,让大模型去提取事实。其实,跟思路二非常类似,都是由程序来触发的。只不过,思路三触发的时机是等整个会话结束之后,而思路二是在会话的过程中进行提取的。
三、如何存储
长期记忆需要持久化,才能跨会话使用。存在哪没有唯一答案,常见有这样几种。
数据库。 比如MySQL、PostgreSQL 或 Redis 等,一行一条记忆,方便按照用户、项目等过滤。
文件。 把长期记忆写成 Markdown 文件。Claude Code 就是这样做的:人写的项目规矩放在仓库根目录的 CLAUDE.md,模型自己记下的笔记放在用户的 ~/.claude/projects/<项目>/memory/ 目录下,入口文件叫 MEMORY.md,相当于一个索引目录,细节再拆成类似 pagination.md 这这样的主题文件。下下篇讲 Claude Code 的记忆系统设计时会详细讲解。
向量库,也就是按 RAG 那套来存。 基础课讲过 RAG:把文本做成向量,按意思相近取回。长期记忆也可以这样存,这样用户说「同样的分页」时,不必精确对上某个关键词,也能命中「列表统一 cursor 分页」这条事实。Mem0记忆组件就是用RAG存储长期记忆,下篇会详细讲。
不管落在哪一种介质上,一条记忆不能只存正文。至少还要带上下面这些字段,后面的召回和更新才做得到。
- user_id,必要时再加 project_id,用于隔离不同用户、不同项目的记忆。
- 时间。
created_at、updated_at用来判断这条记忆还新不新。测试命令换了,旧命令还留着,下次 Agent 会按更新时间来选择。 - 来源。方便用来溯源,避免模型瞎编。
因此,一条记录大概是这个样子:
{
  "id": "mem_01",
  "user_id": "2934",
  "project_id": "codecrush",
  "content": "列表接口统一用 cursor,不用 offset",
  "source": "user",
  "evidence": "别用 offset,统一 cursor",
  "created_at": "2026-09-16T21:10:00+08:00",
  "updated_at": "2026-09-16T21:10:00+08:00",
  "deleted": false
}
不同的存储方式,元信息(除了content字段)的存储方式不同。存在文件里时,这些字段可以写成文件头;存在表里时,就是普通列;存在向量数据库里,就是前面RAG里讲到的元数据metadata。
四、如何召回
召回,就是在新会话或新任务开始时,把和当前目标有关、并且现在仍然有效的长期事实取回来,而不是把这个用户名下的所有记忆整包塞进提示词。
今天你说「给售后单列表接口加上分页」,长期记忆召回至少要命中「列表用 cursor 分页」「查询必须写字段」「列表测试命令是哪一条」。而你上个月改登录页时留下的某个按钮文案偏好,在这个会话里就不应该被召回。
从上述需求描述里,我们也能发现,长期记忆的召回得按照语义去搜索,而不是按关键词精确搜索。
因此,如果你使用数据库来存储存储长期记忆,那么,我们只能根据用户ID、项目ID等过滤条件,获取到所有的长期记忆,然后交给大模型自行去判断跟当前问题的相关性。
这比较适合长期记忆不多的情况。在长期记忆比较多的情况下,这显然是比较浪费上下文窗口,还会造成Lost In Middle问题。
说到语义搜索,我想你应该能想到RAG。前一小节也提到,可以将长期记忆存储在RAG中,对于大部分项目来说,应该是首选。
很多向量数据库支持混合检索,既可以进行语义搜索还可以进行关键词搜索,除此之外,重排序、查询重写等等提升搜索相关性质量的手段,也非常成熟,拿来直接用,方便又省事。
在上一小节中,我们还提到了基于文件的存储方式,比如Claude Code就是使用的这种方式。这种方式会先存储一份目录/索引(也就是前面提到的 MEMORY.md),这个文件里存储着每个细分markdown文件的一句话介绍和文件路径。
当会话开始时,先将这个 MEMORY.md 的内容(往往不会很大,Claude Code的是200行)给到大模型,让大模型自己去挑选匹配的几个细分文件,然后再取读取那几个细分文件。这跟前面讲到的Skills的渐进式披露是一个原理。
五、如何更新
过了几天,你又新开一个会话,说:「这个项目别再一刀切了。订单列表继续用 cursor 分页,售后单列表数据量大,改回 offset 分页。」
上一节存下来的,还是昨天那条:
{
  "id": "mem_01",
  "user_id": "2934",
  "project_id": "codecrush",
  "content": "列表接口统一用 cursor,不用 offset",
  "source": "user",
  "evidence": "别用 offset,统一 cursor",
  "updated_at": "2026-09-16T21:10:00+08:00",
  "deleted": false
}
今天这句话一出,这条就已经不再成立了。正确的做法是改掉它,或者拆成两条:订单列表用 cursor,售后单列表用 offset。如果只再插入一句「售后单用 offset」,旧的「列表统一 cursor 分页」还在,下次你再说「给售后单加分页」,召回会把两条一起取出来。
所以更新要做的事就是:同一件事只留下现在成立的那个事实。 难点不在有没有 update 接口,而在先找到旧的那一条,再覆盖或删掉。
怎么找到旧的那一条呢?跟前面选的存储有关。
如果使用数据库存储长期记忆,我们在给新的对话提取长期记忆的时候,要先把原来的长期记忆(带上ID,方便重新写入数据库)全部取出,一并发给大模型,让大模型自己去更新,即遇到冲突的事实,把旧的删掉,把新的插入。最后,把更新好的长期记忆,updateOrInsert到数据库中(基于ID做update)。
如果使用文件存储长期记忆,方法也是类似的,也需要把原来的长期记忆给到大模型,让它基于此来修改。不过,比使用数据库更加好的一点是,它可以借助前面讲到的渐进式披露的方法,先给到 MEMORY.md,让大模型看需要哪些细分的markdown,然后再给到对应的细分markdown,不需要一次性把所有的细分markdown都喂给大模型。
如果使用RAG来做存储,更新起来就稍微麻烦了。可以想到的办法是,拿新的事实,去向量库里语义检索,然后把检索出来的内容,再次给到大模型,让大模型去做判断,是否冲突、应该怎么更新,最后将最新的、没有冲突的事实,写入到向量库中。虽然这个方法听起来很完美,但是,费时费力还不一定准确,一旦判定错误,将导致长期记忆中记录错误的事实,影响非常大。
一般更加推荐的做法是,存入时,不做冲突检测,记录好更新时间,当召回时,让大模型自己检测是否存在冲突事实,并基于更新时间的先后顺序,去判断使用哪条事实。
本篇小结
12-Mem0记忆组件的实现原理
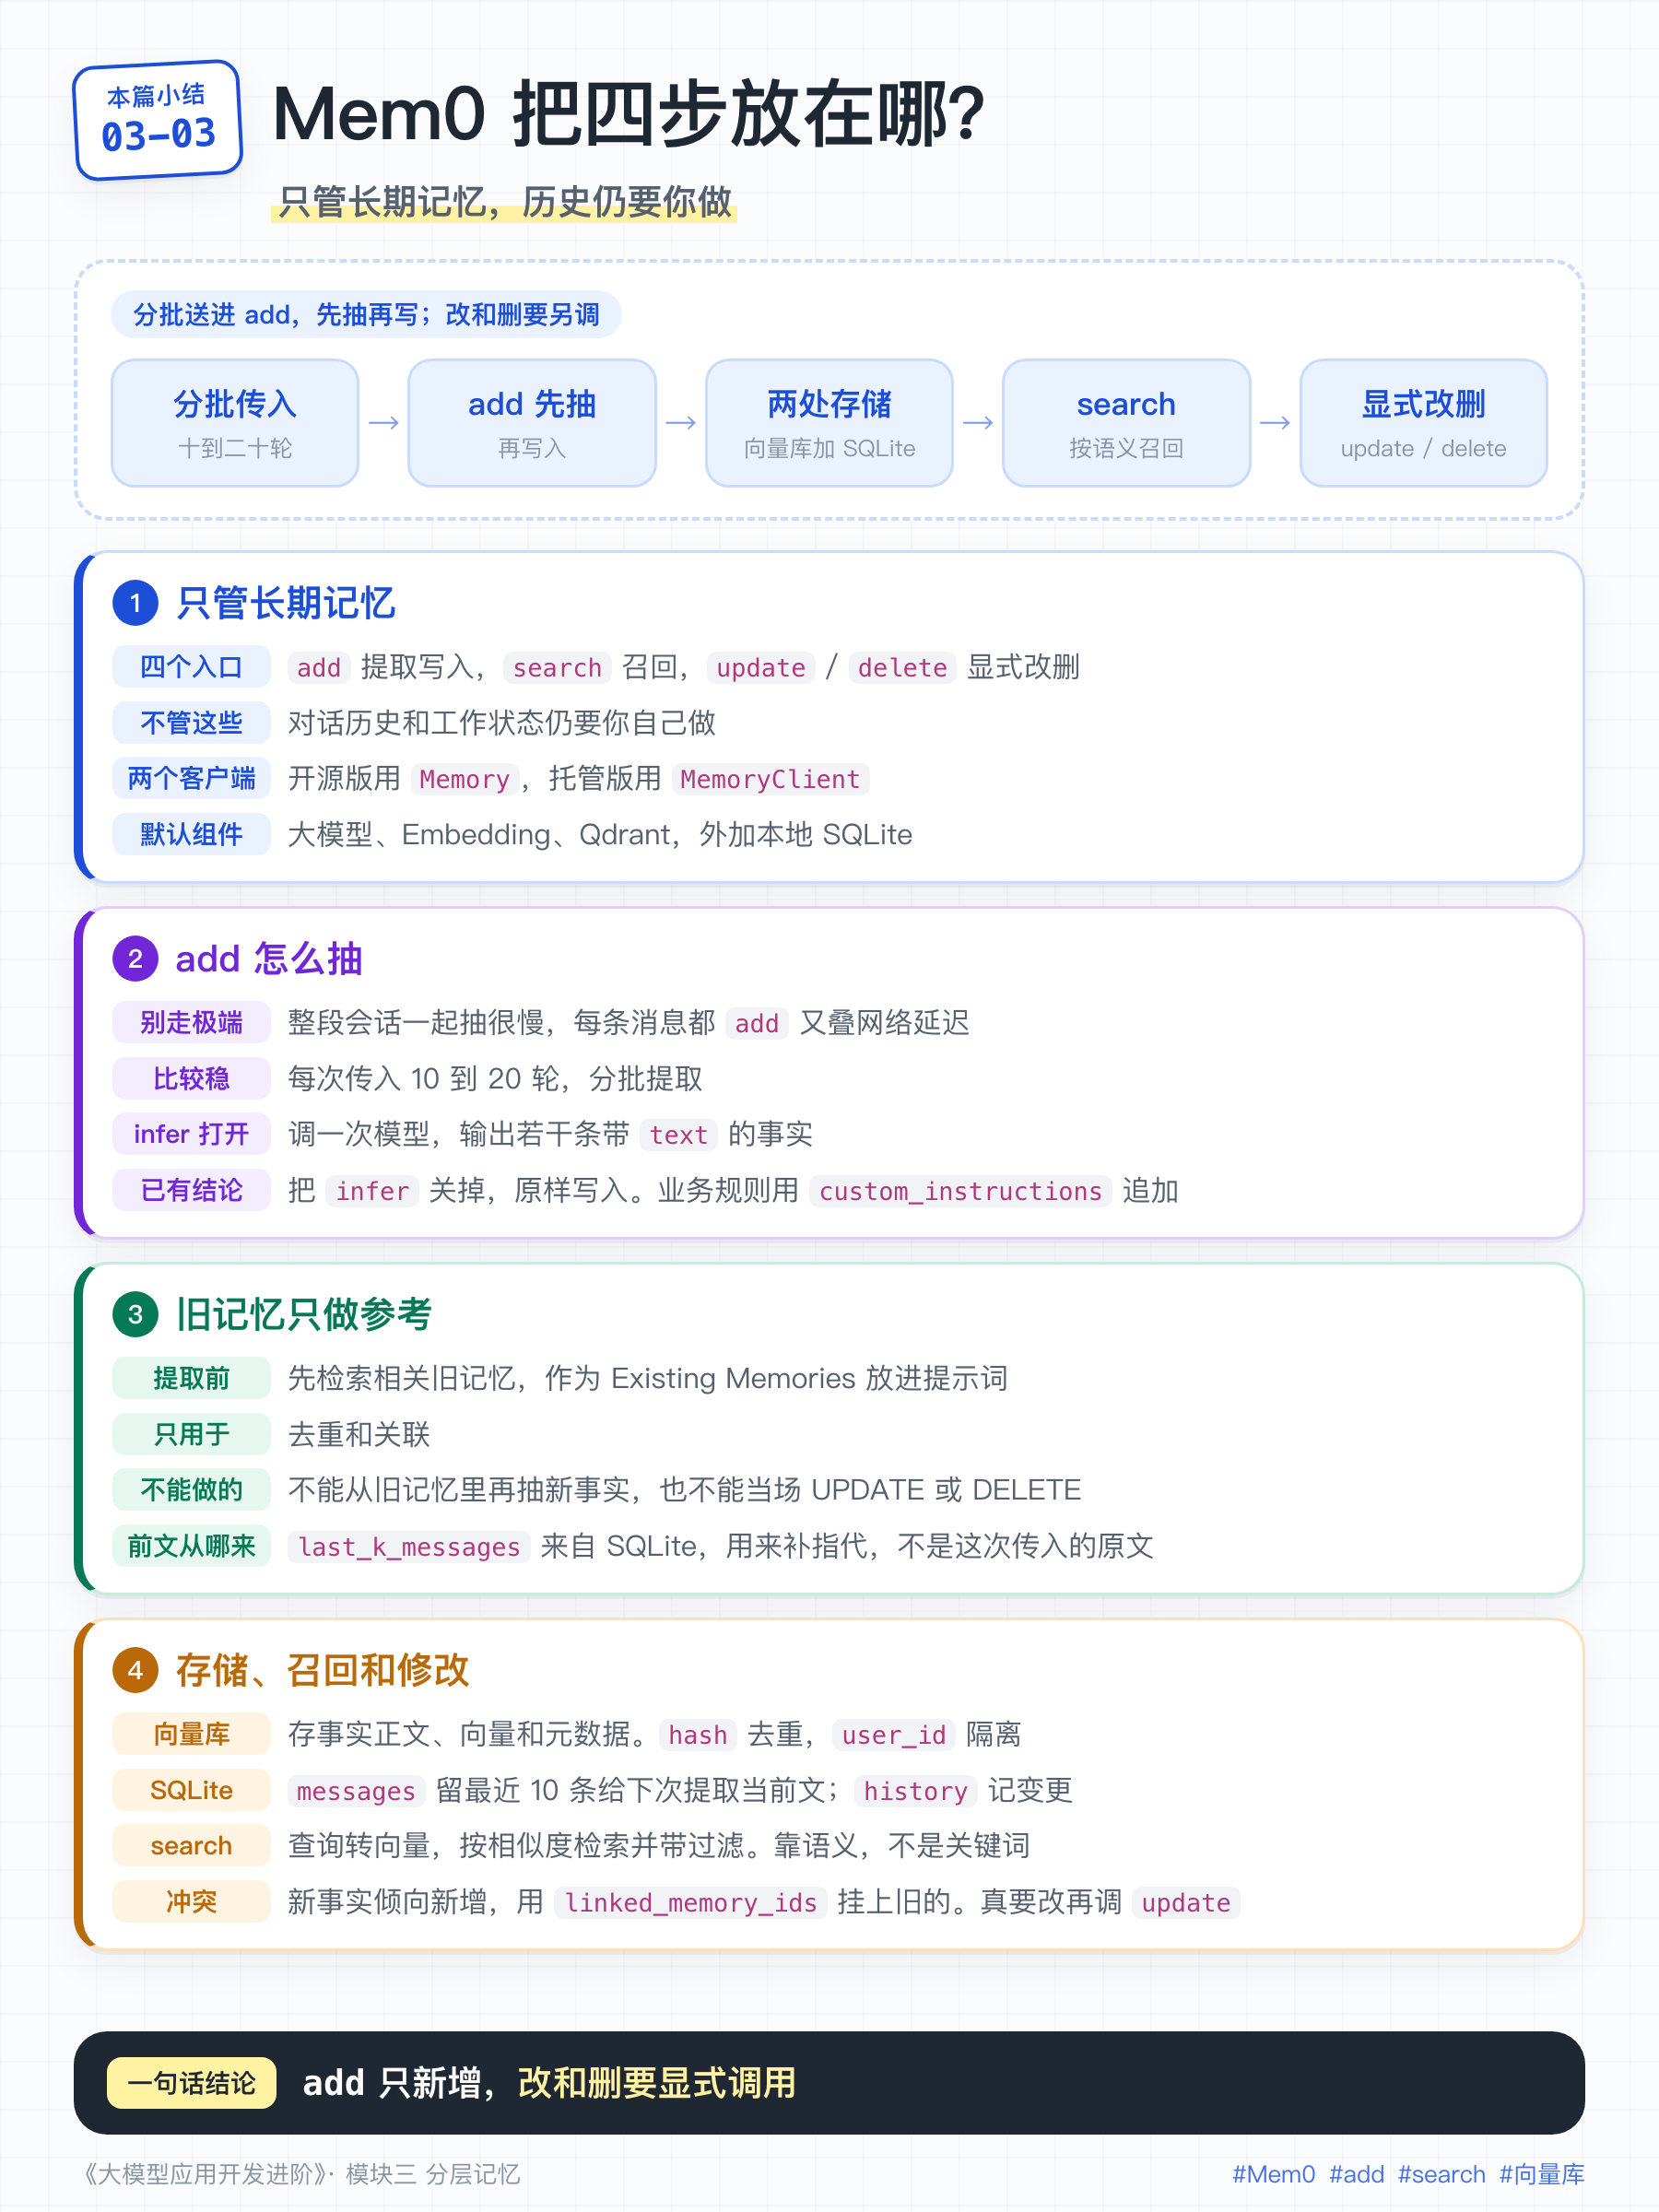
上一篇我们把长期记忆拆成了提取、存储、召回、更新这四个步骤,并详细介绍了各个步骤的具体实现过程。每接一个新项目,这些处理逻辑都要重写一遍,非常麻烦,而多数处理流程都是通用的,不该重复编写。于是,社区里就出现了现成的记忆组件,把这四步封装好。Mem0 是其中用得比较多的一个。
这节课,我们就来看看Mem0是如何实现长期记忆的提取、存储、召回、更新这四个步骤的。
一、Mem0 是什么?如何使用?
Mem0 只做长期记忆这一层:你把一段对话交给它,它从里面抽出一条条事实存起来;下次你用一段对话去检索,它按语义把相关的事实返回给你。
上一篇讲的短期记忆,也就是对话历史和工作状态,Mem0 一概不管,那些仍然要你自己实现。
Mem0 有两种形态,区别在于底层的向量库和模型是你自己部署,还是交给官方:
- 开源自托管版:用
Memory类,向量库、Embedding 模型、大模型都由你自己配置和部署。 - 托管版:用
MemoryClient,你只需要一个 API Key,底层的存储和模型都由官方托管,不用自己维护。
两个版本对外的接口是一致的,核心就是四个方法:add(提取和写入)、search(召回)、update / delete(更新与删除)。
下面的剖析都以开源版为准,因为只有它能看到完整源码。开源版默认会用到下面这几个组件:
- 大模型(配置项
llm):负责提取事实和更新记忆。 - Embedding 模型(配置项
embedder,默认text-embedding-3-small):负责把事实转成向量。 - 向量库(默认 Qdrant):负责存放事实向量。
- 本地 SQLite:额外保存最近的消息和记忆的变更历史。
具体的配置和调用如下:
from mem0 import Memory

config = {
    "llm": {"provider": "openai", "config": {"model": "gpt-5.6"}},
    "embedder": {"provider": "openai", "config": {"model": "text-embedding-3-small"}},
    "vector_store": {"provider": "qdrant", "config": {"collection_name": "codecrush"}},
}
m = Memory.from_config(config)

m.add(messages, user_id="zheng", metadata={"project_id": "codecrush"})  # 提取和写入,其中messages是对话历史
m.search("列表分页怎么做,测试怎么跑", user_id="zheng", limit=5)          # 召回
一般来讲,我们并不会把一个会话的所有对话历史一次性通过 add 传入Mem0进行提取和写入,这样会导致处理时间过长,当然,也不会一条消息一条消息的 add,频繁调用,也会增加多次调用返回的网络延迟。推荐的做法是,每次调用 add 传递10~20轮对话,分批进行。
从上述代码,我们可以看到,Mem0 用起来并不复杂。接下来,我们就对照上一篇讲到的「提取、存储、召回、更新」这四个关键步骤,剖析Mem0底层的实现原理。
二、提取
Mem0 的提取由 add 完成。
add 既支持先让大模型从对话里提取事实、再把事实写入,也支持跳过提取、把内容原样写入,具体走哪条路径通过 infer 参数来控制,默认值为 True。
当 infer=True 时,add 的第一步就是用一段固定的提取提示词调用大模型,把对话提取成一条条独立的事实。如果你传入的内容本身已经是一条确认好的结论,不需要模型再提取一遍,可以把 infer 设为 False,这时 add 会跳过提取,直接把整句话存进去:
m.add("导出接口和列表分开,用按时间翻页", user_id="zheng", infer=False)提取提示词在 mem0/configs/prompts.py 里,名字叫 ADDITIVE_EXTRACTION_PROMPT。完整提示词很长,核心原文如下:
# ROLE

You are a Memory Extractor — a precise, evidence-bound processor responsible for extracting rich, contextual memories from conversations. Your sole operation is ADD: identify every piece of memorable information and produce self-contained, contextually rich factual statements.

You extract from BOTH user and assistant messages. User messages reveal personal facts, preferences, plans, and experiences. Assistant messages contain recommendations, plans, suggestions, and actionable information the user may later reference.

# INPUTS

## New Messages

The current conversation turn(s) with "role" (user/assistant) and "content".

## Existing Memories

Memories currently in the system relevant to this conversation. Formatted as:
[{"id": "uuid-string", "text": "..."}]

Use these ONLY for deduplication and linking — do NOT extract new memories from Existing Memories. Your extractions must come exclusively from New Messages. If new information in New Messages is semantically equivalent to an Existing Memory with no meaningful new context, skip it.

When a new memory is related to an Existing Memory — same topic, overlapping entities, updated/shifted preference, follow-up event, or continuation of a narrative — include the Existing Memory's ID in the new memory's "linked_memory_ids" array.

## Observation Date

When the conversation actually took place (e.g., "2023-05-24"). This is your ONLY temporal anchor for resolving time references.

## Optional Inputs

- **custom_instructions**: User-defined rules (highest priority)

# OUTPUT FORMAT

Return ONLY valid JSON parsable by json.loads(). No text, reasoning, explanations, or wrappers.

## Structure

{
 "memory": [
 {"id": "0", "text": "First extracted memory", "attributed_to": "user", "linked_memory_ids": ["uuid-of-related-existing-memory"]},
 {"id": "1", "text": "Second extracted memory", "attributed_to": "assistant"}
 ]
}

## Rules

- Extract every piece of memorable information as a separate memory object.
- If nothing is worth extracting, return: {"memory": []}
- No duplicate IDs. Use double quotes. No trailing commas.
针对自己的业务场景,比如编程Agent,Agent可以自定义提取规则,如下代码所示。注意,它不是替换上面的系统提示词,而是作为 ## Custom Instructions 追加到用户提示词里,和系统自带的提取规则、去重规则、输出格式一起生效。
custom_instructions = """
从对话里抽取下次会话还用得上的长期记忆。

可以记:
1. user:用户的角色、目标、职责、知识背景、协作偏好。
2. feedback:用户对工作方式的纠正或确认,包括以后要避免什么、保留什么;能写清原因时,要把原因写进去。
3. project:和当前项目、目标、事项、缺陷、事故有关,并且不能从当前代码或 git 历史直接推出来的背景信息。
4. reference:外部系统里的信息入口,例如 Linear、Slack、Grafana、Notion、文档链接;只记录指向哪里找,不要复制大量正文。

不要记:
- 代码模式、架构、文件路径、项目结构;这些应该通过读取当前项目确认。
- git 历史、最近改动、谁改了什么;这些应该以 `git log` / `git blame` 为准。
- 调试过程和修复步骤;修复结果在代码里,背景在提交信息里。
- 已经写在 CLAUDE.md、AGENTS.md、项目规则或文档里的内容。
- 本次任务的临时状态:正在改哪个文件、某一次测试失败、当前计划、待办进度、对话上下文。
- 问候和闲聊。

没有可保存的内容时,不要抽取记忆。

Here are some few shot examples:

Input: Hi.
应抽取:无。

Input: 先读一下 OrderController。
应抽取:无。

Input: 别用 offset,列表统一 cursor。查询不要写 select *。
应抽取:「列表接口统一用 cursor,不用 offset」「查询必须写字段,不要 select *」。

Input: 我是这个仓库的后端,回复用中文。刚才那种不读测试就直接改实现的方式不要再用了,先看测试能少走弯路。
应抽取:「用户是这个仓库的后端」「用户偏好使用中文沟通」「修改实现前应先阅读相关测试,因为用户认为这样能减少返工」。

Input: 这个报警的背景在 Grafana 的 order-service latency dashboard,链接我已经发到 Slack #order-backend 频道了。
应抽取:「order-service 延迟报警的背景可在 Grafana 的 order-service latency dashboard 查看,相关链接在 Slack #order-backend 频道」。
"""

config = {
    "llm": {"provider": "openai", "config": {"model": "gpt-5.6"}},  # 生产环境应锁定到带日期的快照 ID
    "embedder": {"provider": "openai", "config": {"model": "text-embedding-3-small"}},
    "vector_store": {"provider": "qdrant", "config": {"collection_name": "codecrush"}},
    "custom_instructions": custom_instructions,
}
m = Memory.from_config(config)
搞清楚了提取提示词之后,我们来看具体的提取流程,其实,从提示词里,你应该已经能大致推断出来了。
提取的过程中,会将已有的记忆一并给到大模型,但不是全量传入。Mem0 会先用对话历史做一次向量检索,取回最相关的已有记忆,再作为 Existing Memories 单独放进提示词,用于去重和建立关联。
源码里的流程是:
add先解析这次传入的messages,得到parsed_messages。
messages = [
    {"role": "user", "content": "别用 offset,列表统一 cursor。"},
    {"role": "assistant", "content": "好,后面列表都按 cursor 做。"},
]

parsed_message:
user: 别用 offset,列表统一 cursor。
assistant: 好,后面列表都按 cursor 做。- 再用
parsed_messages做 embedding,然后去向量库检索旧记忆:
existing_results = self.vector_store.search(
    query=parsed_messages,
    vectors=query_embedding,
    top_k=10,
    filters=search_filters,
)- 检索出来的旧记忆只保留
id和text,组成existing_memories。 - 然后调用
generate_additive_extraction_prompt(...),把这些东西一起拼进同一个 user prompt:
user_prompt = generate_additive_extraction_prompt(
    existing_memories=existing_memories,
    new_messages=parsed_messages,
    last_k_messages=last_messages,
    custom_instructions=custom_instr,
)
注意,其中 last_k_messages 是 parsed_messages 前面的若干条历史对话,用来给 parsed_messages 提供前文信息,以免有些对话比如「刚才那个方案」找不到代指。
last_k_messages 并不是调用 add 时传入的,而是 Mem0 从本地 SQLite 里取出来的。
每次调用 add 结束时,Mem0 都会把这次传入的原始 messages 存进 messages 表,并且同一个 session_scope 只保留最近 10 条。
下一次再调用 add 时,就可以先从这里取出最近历史,拼进 Last k Messages 。
- 最后调用大模型提取记忆:
response = self.llm.generate_response(
    messages=[
        {"role": "system", "content": ADDITIVE_EXTRACTION_PROMPT},
        {"role": "user", "content": user_prompt},
    ],
    response_format={"type": "json_object"},
)
最后输出的记忆格式如下所示。
{
  "memory": [
    {
      "id": "0",
      "text": "列表接口统一用 cursor,不用 offset",
      "attributed_to": "user",
      "linked_memory_ids": ["3"]
    },
    {
      "id": "1",
      "text": "查询必须写字段,不要 select *",
      "attributed_to": "user"
    }
  ]
}
每条记忆至少包含 id、text、attributed_to,还可以带 linked_memory_ids。
当一条新记忆和某条已有记忆相关时,比如属于同一个主题、涉及重叠的实体、更新或改变了某个偏好、是后续事件,或者是同一段经历的延续,就把那条已有记忆的 ID 放进新记忆的 linked_memory_ids 数组里(具体看前面的Prompt中的描述,我摘抄到了下面)。这正好对应上一篇说的更稳的更新策略:写入时先保留事实和时间,召回时再处理冲突。
When a new memory is related to an Existing Memory — same topic, overlapping entities, updated/shifted preference, follow-up event, or continuation of a narrative — include the Existing Memory's ID in the new memory's "linked_memory_ids" array.三、存储
抽完事实,接下来看 Mem0 把它们存到了哪里。
Mem0 有两套存储系统:一套是向量库,另一套是本地 SQLite。
向量库(默认 Qdrant)。每条事实先用Embedding模型转成向量,连同事实本身、元数据一起存入向量数据库中。
{
  "id": "b3f2c8e1-...",
  "data": "列表接口统一用 cursor,不用 offset",
  "hash": "9a1c...",
  "user_id": "zheng",
  "project_id": "codecrush",
  "created_at": "2026-09-16T21:10:00-07:00",
  "updated_at": null
}
除了事实正文和向量,这条记录里还有其他几个字段:
hash:事实正文的 MD5。写入事实前, Mem0 会先用它比对,如果新事实的文本和库里某条完全一样,就直接跳过,不重复写入。created_at/updated_at:记录的创建和更新时间,用来判断一条记忆的新旧,更新时会用到。user_id/project_id:用来做数据隔离,保证一个项目的约定只会被召回到它自己的会话里,不会串到别的用户、别的项目。
本地 SQLite(默认在 ~/.mem0/history.db)。它里面有两张表:messages表和 history表。
messages 表保存同一个 session_scope 下最近 10 条原始消息,给前面提到的 last_k_messages 用;
history 表记录记忆变更流水,包括 memory_id、old_memory、new_memory、event、时间等字段,方便事后回溯一条记忆是怎么写入、更新或删除的。
四、召回
search 的内部流程很简单,就是RAG检索的那套流程:先把你的查询用同一个Embedding模型转成向量,再调向量库的相似度检索并带上 user_id 等过滤条件,最后把命中的记忆连同相似度分数返回。
hits = m.search("列表分页怎么做,测试怎么跑", user_id="zheng", limit=5)
for item in hits["results"]:
    print(item["score"], item["memory"])  # memory 就是事实
召回靠的是语义,不是关键词精确匹配。所以,今天你说「同样的分页」,一个字都没提 cursor,也能命中「列表接口统一用 cursor 分页」这条。
五、更新
更新是四步里最容易出错的。
通过前面的提示词,我们也可以发现:add 阶段只做 ADD,不在提取时自动 UPDATE 或 DELETE 旧记忆。
前面提到的 Existing Memories 虽然会进入提取提示词,但它只承担两个作用:
第一,帮助模型判断新消息是不是已经被记过,避免重复抽取;
第二,发现新旧记忆相关时,把旧记忆 id 写进 linked_memory_ids,但是,它不会让模型当场把旧记忆改掉。
拿一个具体场景来看。
之前库里有一条「列表接口统一用 cursor 分页,不用 offset 分页」。过几天你又说「订单列表继续用 cursor 分页,售后单列表数据量大,改回 offset 分页」。Mem0 更倾向于新增一条和售后单有关的记忆,并通过 linked_memory_ids 关联旧的分页记忆,而不是直接把旧记忆覆盖成另一句话。
这和上一篇的观点是一致的:长期记忆一旦被错误覆盖,影响会跨很多个会话扩散。与其在写入时让模型一次性判断「该改哪条、删哪条」,更稳妥的做法是保留新旧事实、记录时间和关联关系,召回时再结合当前任务判断哪条仍然成立。
当然,Mem0 保留了显式的更新和删除接口,当你明确知道需要变更哪条长期记忆的时候,可以直接调用它们:
m.update(memory_id, data="订单列表接口用 cursor,不用 offset")  # 按 id 覆盖正文
m.delete(memory_id)                                            # 删掉某一条
m.delete_all(user_id="zheng")                                  # 清空这个用户的全部记忆
本篇小结
13-Claude Code记忆系统设计
上一篇,我们介绍了Mem0记忆系统的底层实现原理,见识了长期记忆四个步骤(提取、存储、召回、更新)的真实落地方案。
这篇文章,我们剖析Claude Code 的记忆系统设计,看看它跟 Mem0 又有何不同。
一、Claude Code 分层记忆系统
Claude Code 的记忆系统也是分为短期记忆和长期记忆。
跨会话(长期记忆)
  CLAUDE.md           用户写的指令和规矩,会话开始时加载
  auto memory         模型自己写下的笔记,会话开始时只加载索引 MEMORY.md

本次任务(短期记忆)
  当前 messages       对话历史 JSONL
  待办 / 计划文件      最接近「工作状态」的东西
  压缩摘要 + 近期原文   窗口不够时的处理办法
短期记忆这一层,对应第一篇讲的对话历史和工作状态,比较简单,我们不做介绍。我们重点看长期记忆。
Claude Code 的长期记忆比较特殊,长期记忆这一层又分成两类: CLAUDE.md 和 auto memory。这两类信息的来源和维护方式完全不同。
先看第一类:CLAUDE.md,这是用户写给模型的规矩。
CLAUDE.md 是用户定的规矩,比如构建命令、代码风格、接口约定,用户可以直接打开 CLAUDE.md 进行编辑。
每次会话开始时,Claude Code 会把这份文件读进这一次会话的上下文窗口。这部分比较简单,是用户维护的,我们不做深入讨论。
再看第二类:auto memory,这是模型自己写的笔记。
auto memory 是模型在推进任务的过程中,自己判断「这条以后还用得上」,然后写下来的笔记。
它默认开启,记录在用户本机的 ~/.claude/projects/<项目>/memory/目录下。这一类正好对应第二篇讲的基于文件的长期记忆存储方式:入口文件叫 MEMORY.md,相当于一个索引,细节再拆到 feedback_sql.md、project_pagination.md 这类细分的主题文件里。
MEMORY.md 一行一条索引,指向主题文件,具体的写法是「标题 + 文件链接 + 一句话描述」:
# Memory

- [列表分页约定](project_pagination.md) — 列表接口统一 cursor,不用 offset
- [查询必须写字段](feedback_sql.md) — 不要写 select *
- [延迟看板入口](reference_grafana.md) — 订单延迟看 Grafana,链接在 Slack
细分的主题文件长这个样子:
---
name: 列表分页约定
description: 订单服务的列表接口统一用 cursor 分页,不用 offset
type: project
---

列表接口统一用 cursor 分页,不用 offset。

**Why:** 订单、对账这类列表数据量大,offset 翻到后面会越来越慢,中间插入新数据还会漏页或重页。用户明确要求新接口不要再各写一套。

**How to apply:** 新做或改列表接口时,用 nextCursor / prevCursor 翻页,不要加 page + pageSize。给售后单列表加分页时,也按这套约定做。
会话开始时,Claude Code 只加载 MEMORY.md 的前 200 行(或前 25KB,谁先到算谁)。主题文件不预加载,等模型根据当前的对话,判断需要时再加载。
下面详细讲解Claude Code 长期记忆的提取、存储、召回、更新的落地方案。
二、Claude Code 长期记忆
其实,Claude Code 长期记忆的所有实现细节,都藏在了一份系统提示词里。
这个系统提示词说清楚了长期记忆所有使用细节,包括什么时候提取、提取哪些事实、存储格式、什么时候召回、各种约束等等。
这份提示词会在会话开始时,给到大模型,在后续的对话中,大模型会据此来提取和召回长期记忆。
我们先把英文版本的这份提示词直接给到你。
# auto memory

You have a persistent, file-based memory system at `~/.claude/projects/<项目>/memory/`.
This directory already exists — write to it directly with the Write tool (do not run mkdir or check for its existence).

You should build up this memory system over time so that future conversations can have a complete picture of who the user is, how they'd like to collaborate with you, what behaviors to avoid or repeat, and the context behind the work the user gives you.

If the user explicitly asks you to remember something, save it immediately as whichever type fits best. If they ask you to forget something, find and remove the relevant entry.

## Types of memory

There are several discrete types of memory that you can store in your memory system:

user
Contain information about the user's role, goals, responsibilities, and knowledge.
<when_to_save>When you learn any details about the user's role, preferences, responsibilities, or knowledge</when_to_save>

feedback
Guidance the user has given you about how to approach work — both what to avoid and what to keep doing. Record from failure AND success.
<when_to_save>Any time the user corrects your approach ("no not that", "don't", "stop doing X") OR confirms a non-obvious approach worked ("yes exactly", "perfect, keep doing that"). Include *why*.</when_to_save>
<body_structure>Lead with the rule itself, then a **Why:** line and a **How to apply:** line.</body_structure>

project
Information about ongoing work, goals, initiatives, bugs, or incidents that is not otherwise derivable from the code or git history.
<when_to_save>When you learn who is doing what, why, or by when. Convert relative dates to absolute dates.</when_to_save>

reference
Stores pointers to where information can be found in external systems (Linear, Slack, Grafana, ...).

## What NOT to save in memory

- Code patterns, conventions, architecture, file paths, or project structure — these can be derived by reading the current project state.
- Git history, recent changes, or who-changed-what — `git log` / `git blame` are authoritative.
- Debugging solutions or fix recipes — the fix is in the code; the commit message has the context.
- Anything already documented in CLAUDE.md files.
- Ephemeral task details: in-progress work, temporary state, current conversation context.

These exclusions apply even when the user explicitly asks you to save. If they ask you to save a PR list or activity summary, ask what was *surprising* or *non-obvious* about it — that is the part worth keeping.

## How to save memories

Saving a memory is a two-step process:

**Step 1** — write the memory to its own file (e.g., `user_role.md`, `feedback_testing.md`) using this frontmatter format:

---
name: {{memory name}}
description: {{one-line description — used to decide relevance in future conversations, so be specific}}
type: {{user, feedback, project, reference}}
---

{{memory content — for feedback/project types, structure as: rule/fact, then **Why:** and **How to apply:** lines}}

**Step 2** — add a pointer to that file in `MEMORY.md`. `MEMORY.md` is an index, not a memory — each entry should be one line, under ~150 characters: `- [Title](file.md) — one-line hook`. It has no frontmatter. Never write memory content directly into `MEMORY.md`.

- `MEMORY.md` is always loaded into your conversation context — lines after 200 will be truncated, so keep the index concise
- Organize memory semantically by topic, not chronologically
- Update or remove memories that turn out to be wrong or outdated
- Do not write duplicate memories. First check if there is an existing memory you can update before writing a new one.

## When to access memories
- When memories seem relevant, or the user references prior-conversation work.
- You MUST access memory when the user explicitly asks you to check, recall, or remember.
- If the user says to *ignore* or *not use* memory: proceed as if MEMORY.md were empty.
- Memory records can become stale. Before answering based solely on memory, verify against current files. If memory conflicts with what you observe now, trust what you observe — and update or remove the stale memory.

## Before recommending from memory
A memory that names a specific function, file, or flag is a claim that it existed when the memory was written. Before recommending it:
- If the memory names a file path: check the file exists.
- If the memory names a function or flag: grep for it.
- If the user is about to act on your recommendation, verify first.
"The memory says X exists" is not the same as "X exists now."

## Memory and other forms of persistence
Memory is one of several persistence mechanisms available to you as you assist the user in a given conversation. The distinction is often that memory can be recalled in future conversations and should not be used for persisting information that is only useful within the scope of the current conversation.
- When to use or update a plan instead of memory: If you are about to start a non-trivial implementation task and would like to reach alignment with the user on your approach you should use a Plan rather than saving this information to memory. Similarly, if you already have a plan within the conversation and you have changed your approach persist that change by updating the plan rather than saving a memory.
- When to use or update tasks instead of memory: When you need to break your work in current conversation into discrete steps or keep track of your progress use tasks instead of saving to memory. Tasks are great for persisting information about the work that needs to be done in the current conversation, but memory should be reserved for information that will be useful in future conversations.
真心建议你好好读读上面这大段英文的prompt,读懂了它,你就知道Claude Code 长期记忆的设计思路了。
为了方便你理解,我们将它翻译成中文,并做了一些简单的解释。
# auto memory

你有一套基于文件的持久记忆,目录在 `~/.claude/projects/<项目>/memory/`。
这个目录已经存在,直接用 Write 工具往里写(不要先 mkdir,也不要先检查它在不在)。

你应该随时间把这套记忆补起来,让以后的会话能完整知道:用户是谁、希望怎么协作、哪些行为要避免或重复、以及用户交给你的工作背后有什么背景。

如果用户明确要求你记住某件事,立刻按最合适的类型保存。如果用户要求忘记某件事,找到对应条目并删掉。

## 记忆有哪些类型

记忆系统里可以存的类型是分开的,只有下面这几种:

user
记录用户的角色、目标、职责和知识背景。
<when_to_save>一旦了解到用户的角色、偏好、职责或知识,就写。</when_to_save>

feedback
记录用户对工作方式的指导:既包括要避免什么,也包括要继续做什么。失败和成功都要记。
<when_to_save>用户纠正你的做法(「不是那样」「不要」「别再做 X」),或者确认一种并不显而易见的做法有效(「对,就是这样」「以后都这么做」)时就写。要把原因写进去。</when_to_save>
<body_structure>先写规则本身,再写一行 **Why:**,再写一行 **How to apply:**。</body_structure>

project
记录进行中的工作、目标、事项、缺陷或事故,而且这些信息不能从当前代码或 git 历史直接推出来。
<when_to_save>了解到谁在做什么、为什么做、做到什么时候时就写。相对日期要换成绝对日期。</when_to_save>

reference
记录外部系统里信息入口的指针(Linear、Slack、Grafana 等)。

## 什么不要写进记忆

- 代码模式、约定、架构、文件路径、项目结构 — 读当前项目就能推出来。
- Git 历史、最近改动、谁改了什么 — 以 `git log` / `git blame` 为准。
- 某次调试怎么修的 — 修复结果在代码里,背景在提交信息里。
- 已经写在 CLAUDE.md 里的内容。
- 本次任务的临时细节:进行中的工作、临时状态、当前对话上下文。

即使用户明确要求你保存,这些排除项仍然生效。如果用户让你保存一份 PR 列表或活动摘要,要追问其中有什么出乎意料、以后还用得上的 — 那一部分才值得留下。

## 怎么保存记忆

保存一条记忆分两步:

**第一步** — 把记忆写到独立文件(例如 `user_role.md`、`feedback_testing.md`),文件头用下面这个格式:

---
name: {{记忆名称}}
description: {{一句话描述 — 以后用来判断这条跟当前任务相不相关,所以要写具体}}
type: {{user, feedback, project, reference}}
---

{{记忆正文 — feedback / project 类型按:规则/事实,然后 **Why:** 和 **How to apply:** 来写}}

**第二步** — 在 `MEMORY.md` 里加一行指针。`MEMORY.md` 是索引,不是记忆正文 — 每一条一行,大约 150 个字符以内:`- [标题](file.md) — 一句话钩子`。它没有文件头。不要把记忆正文直接写进 `MEMORY.md`。

- `MEMORY.md` 总会被加载进会话上下文 — 超过 200 行会被截断,所以索引要短
- 按主题组织记忆,不要按时间顺序排列
- 发现记错了或过时了,就更新或删掉
- 不要写重复的记忆。先检查有没有能更新的旧记忆,再决定要不要写新的

## 什么时候去读记忆
- 记忆看起来跟当前任务有关,或者用户提到了之前会话里的工作时。
- 用户明确要求你查看、回忆或记住时,必须去读记忆。
- 如果用户说 *忽略* 或 *不要用* 记忆:当作 MEMORY.md 是空的继续做。
- 记忆会过时。只根据记忆回答之前,先对照当前文件核实。记忆和你现在看到的不一致时,以当前观察到的为准,并更新或删掉过时的记忆。

## 根据记忆给出建议之前
一条记忆里出现了某个函数、文件或开关,只说明它在这条记忆写下时存在过。在据此建议之前:
- 如果记忆点了文件路径:先确认文件还在。
- 如果记忆点了函数或开关:先 grep 一下。
- 如果用户马上要按你的建议行动,先核实。
「记忆里写 X 存在」不等于「X 现在还存在」。

## 记忆和其他持久化方式
记忆只是你在这次会话里可用的多种持久化方式之一。区别通常是:记忆能在以后的会话里被召回,因此不该用来保存只对当前会话有用的信息。
- 什么时候该用计划而不是记忆:你准备开始一项需要多步完成的实现任务,并希望先和用户对齐方案时,应该写 Plan,而不是把方案存进记忆。如果这次会话里已经有计划、方案又变了,应该改计划文件,而不是另存一条记忆。
- 什么时候该用待办而不是记忆:需要把当前会话的工作拆成步骤、或跟踪进度时,用 Tasks,不要写进记忆。待办适合记录这次会话里还要做完的事;记忆留给以后会话还用得上的信息。
这份prompt已经写得非常清楚了,唯独有一个地方,我们需要额外解释一下,那就是长期记忆提取和写入的时机。
在prompt中提到,只要是大模型觉得当前的对话值得提取,就可以调用 Write 工具写入markdown文件。
但是,大模型可能无法做到100%遵守,毕竟一边要完成用户的任务,一边还要想着提取事实记录markdown文档,本身注意力就会被分散,漏记并不是一件很稀奇的事情。
怎么解决漏记这个问题呢?
Claude Code 是这么做的:在 每一轮对话结束 之后,就会补充做一次对这轮对话的事实提取。
怎么定义一轮对话?怎么判定一轮对话的结束,在本模块的第二篇文章中已经讲过了。
一轮对话包含:user消息 + 几轮工具调用 + assistant消息(不包含工具调用的消息)
你如果忘记了,再回去看下。
当然,这又有一个问题,那就是,如果在这轮对话进行中,大模型已经顺道做了事实提取,当这轮对话结束之后,再提取,就会导致重复提取。
怎么解决重复提取的问题呢?
其实,解决办法也很简单。它只需要先翻一翻这一轮对话记录里,有没有 Write 或者 Edit 的工具调用记录,并且写入的是长期记忆的目录(工具参数是:~/.claude/projects/<项目>/memory/ )即可。
有,就说明已经提取过事实,就不要重复提取了,没有,就补充提取一下。
补充提取事实的提示词跟前面的那份略有不同,开头如下所示,后面拼上同一套 Types / What NOT to save / How to save。
You are now acting as the memory extraction subagent. Analyze the most recent ~N messages above and use them to update your persistent memory systems.

Available tools: Read, Grep, Glob, read-only Bash (ls/find/cat/stat/wc/head/tail), and Edit/Write for paths inside the memory directory only. Bash rm is not permitted. All other tools — MCP, Agent, write-capable Bash, etc — will be denied.

You have a limited turn budget. Edit requires a prior Read of the same file, so the efficient strategy is: turn 1 — issue all Read calls in parallel for every file you might update; turn 2 — issue all Write/Edit calls in parallel. Do not interleave reads and writes across multiple turns.

You MUST only use content from the last ~N messages to update your persistent memories. Do not waste any turns attempting to investigate or verify that content further — no grepping source files, no reading code to confirm a pattern exists, no git commands.
本篇小结