07-Agent开发框架
07-Agent开发框架
30-Agent开发框架介绍
从模块一到模块六,我们一直在做一件事:用最朴素的代码,一点点把 Agent 搭起来。模块一写了一个最小的循环,模块二接上工具,模块三加了记忆,模块四管好上下文,模块五把这些收进 Runtime,模块六又在 Runtime 之上组织出 ReAct、Plan-and-Execute、Reflection 和 Multi-Agent 几种架构模式。
到这里,我们应该意识到,前面讲到的很多 Agent 开发技术,跟具体业务是无关的,非常适合抽象成开发框架。
这节课,我们就来介绍一下各种 Agent 开发框架,看看它们各自具备哪些功能,对前面讲到的 Agent 开发技术支持情况如何。
一、为什么需要框架?
我们从工具调用、分层记忆、上下文工程(主要是上下文压缩)、Runtime、架构模式几个方面,看看哪些事情可以交给框架来完成。
工具调用
回想模块二里我们是怎么给 Agent 加一个工具的。先写好函数本身,再单独手写一份 JSON Schema,把函数名、每个参数的类型、哪些是必填,一项项描述清楚,拼进请求的 tools 字段。模型返回之后,还要从 tool_calls 里把它想调的函数名和参数解析出来,找到对应的函数,把参数反序列化后传进去,执行,捕获异常,再把结果包成一条 tool 消息塞回对话历史,进入下一轮。
你会发现,除了函数体那几行是真正的业务逻辑,剩下的 Schema 生成、调用解析、结果回填,每加一个工具都要重复一遍,而且写法几乎完全一样。这正是框架最该接手的部分。
框架的做法是:你只管写函数,给它加一个注解或装饰器,框架通过反射读出函数签名和注释,自动生成 Schema、自动注册、自动在循环里解析和分发。
from langchain.tools import tool
from langchain.agents import create_agent

@tool
def get_weather(city: str) -> str:
    """查询指定城市的实时天气。"""
    return weather_api.query(city)

# 工具的 Schema、调用解析、结果回填都由框架完成
agent = create_agent(model="gpt-5.6", tools=[get_weather])
agent.invoke({"messages": [{"role": "user", "content": "北京今天天气怎么样?"}]})
分层记忆
模块三里,我们把记忆分成了短期和长期两层。短期记忆是对话历史和工作状态,需要按会话 ID 隔离,太长了还要按窗口裁剪;长期记忆是跨会话的事实,我们仿照 Mem0 做了提取、存储、召回、更新,底层用向量库加 SQLite 两套存储。
这里面真正跟业务相关的,其实只有「记什么、怎么判断该不该记」这件事。而会话隔离、窗口管理、底层存储怎么对接,不管做什么业务都长一个样。
框架就把这一层固定下来:短期记忆给一个带会话 ID 的记忆组件,底层存储可以换成内存、Redis 或数据库;长期记忆给一个独立的 Store(LangChain中的概念),提供写入和检索接口,底层可以接各种向量库。你要做的只是选一个后端配上去,而不是再把存储和召回的流程重写一遍。
上下文工程
模块四讲的是,在有限的窗口里,每一步到底该喂给模型哪些数据,装什么数据要自己来决定。但是,最复杂的是上下文压缩:工具结果裁剪、微压缩、对话历史压缩等等。其实,这部分压缩的工作也可以通过框架来完成。
Runtime
模块五里,我们把模型、工具、记忆、上下文串成了一个决策—行动—观察的循环,还给它加了退出条件(最大步数、预算、循环检测)、可靠的工具执行(执行前校验、权限控制、失败重试、只读并行而写操作串行),以及人工介入时的挂起和恢复、状态持久化和中断恢复。
这套循环骨架,几乎是每个 Agent 都要有的,而且逻辑高度一致。框架可以提供一个现成的执行引擎。你不用再为每个新 Agent 把这套控制逻辑从头写一遍。
架构模式
模块六的几种架构模式,本质都是在 Runtime 之上组织模型怎么决策、任务怎么切分。
其中 ReAct 基本就是默认的那个循环,所以大多数框架都直接给了现成的 ReAct Agent,一行代码就能用。而 Plan-and-Execute、Reflection、Multi-Agent 这些,需要在循环之上再搭一层结构,于是框架提供节点、边、条件路由、子图这类编排原语,让你把这些模式拼出来;有的框架还会把常见的几种模式也封装成现成组件。
二、主流框架介绍
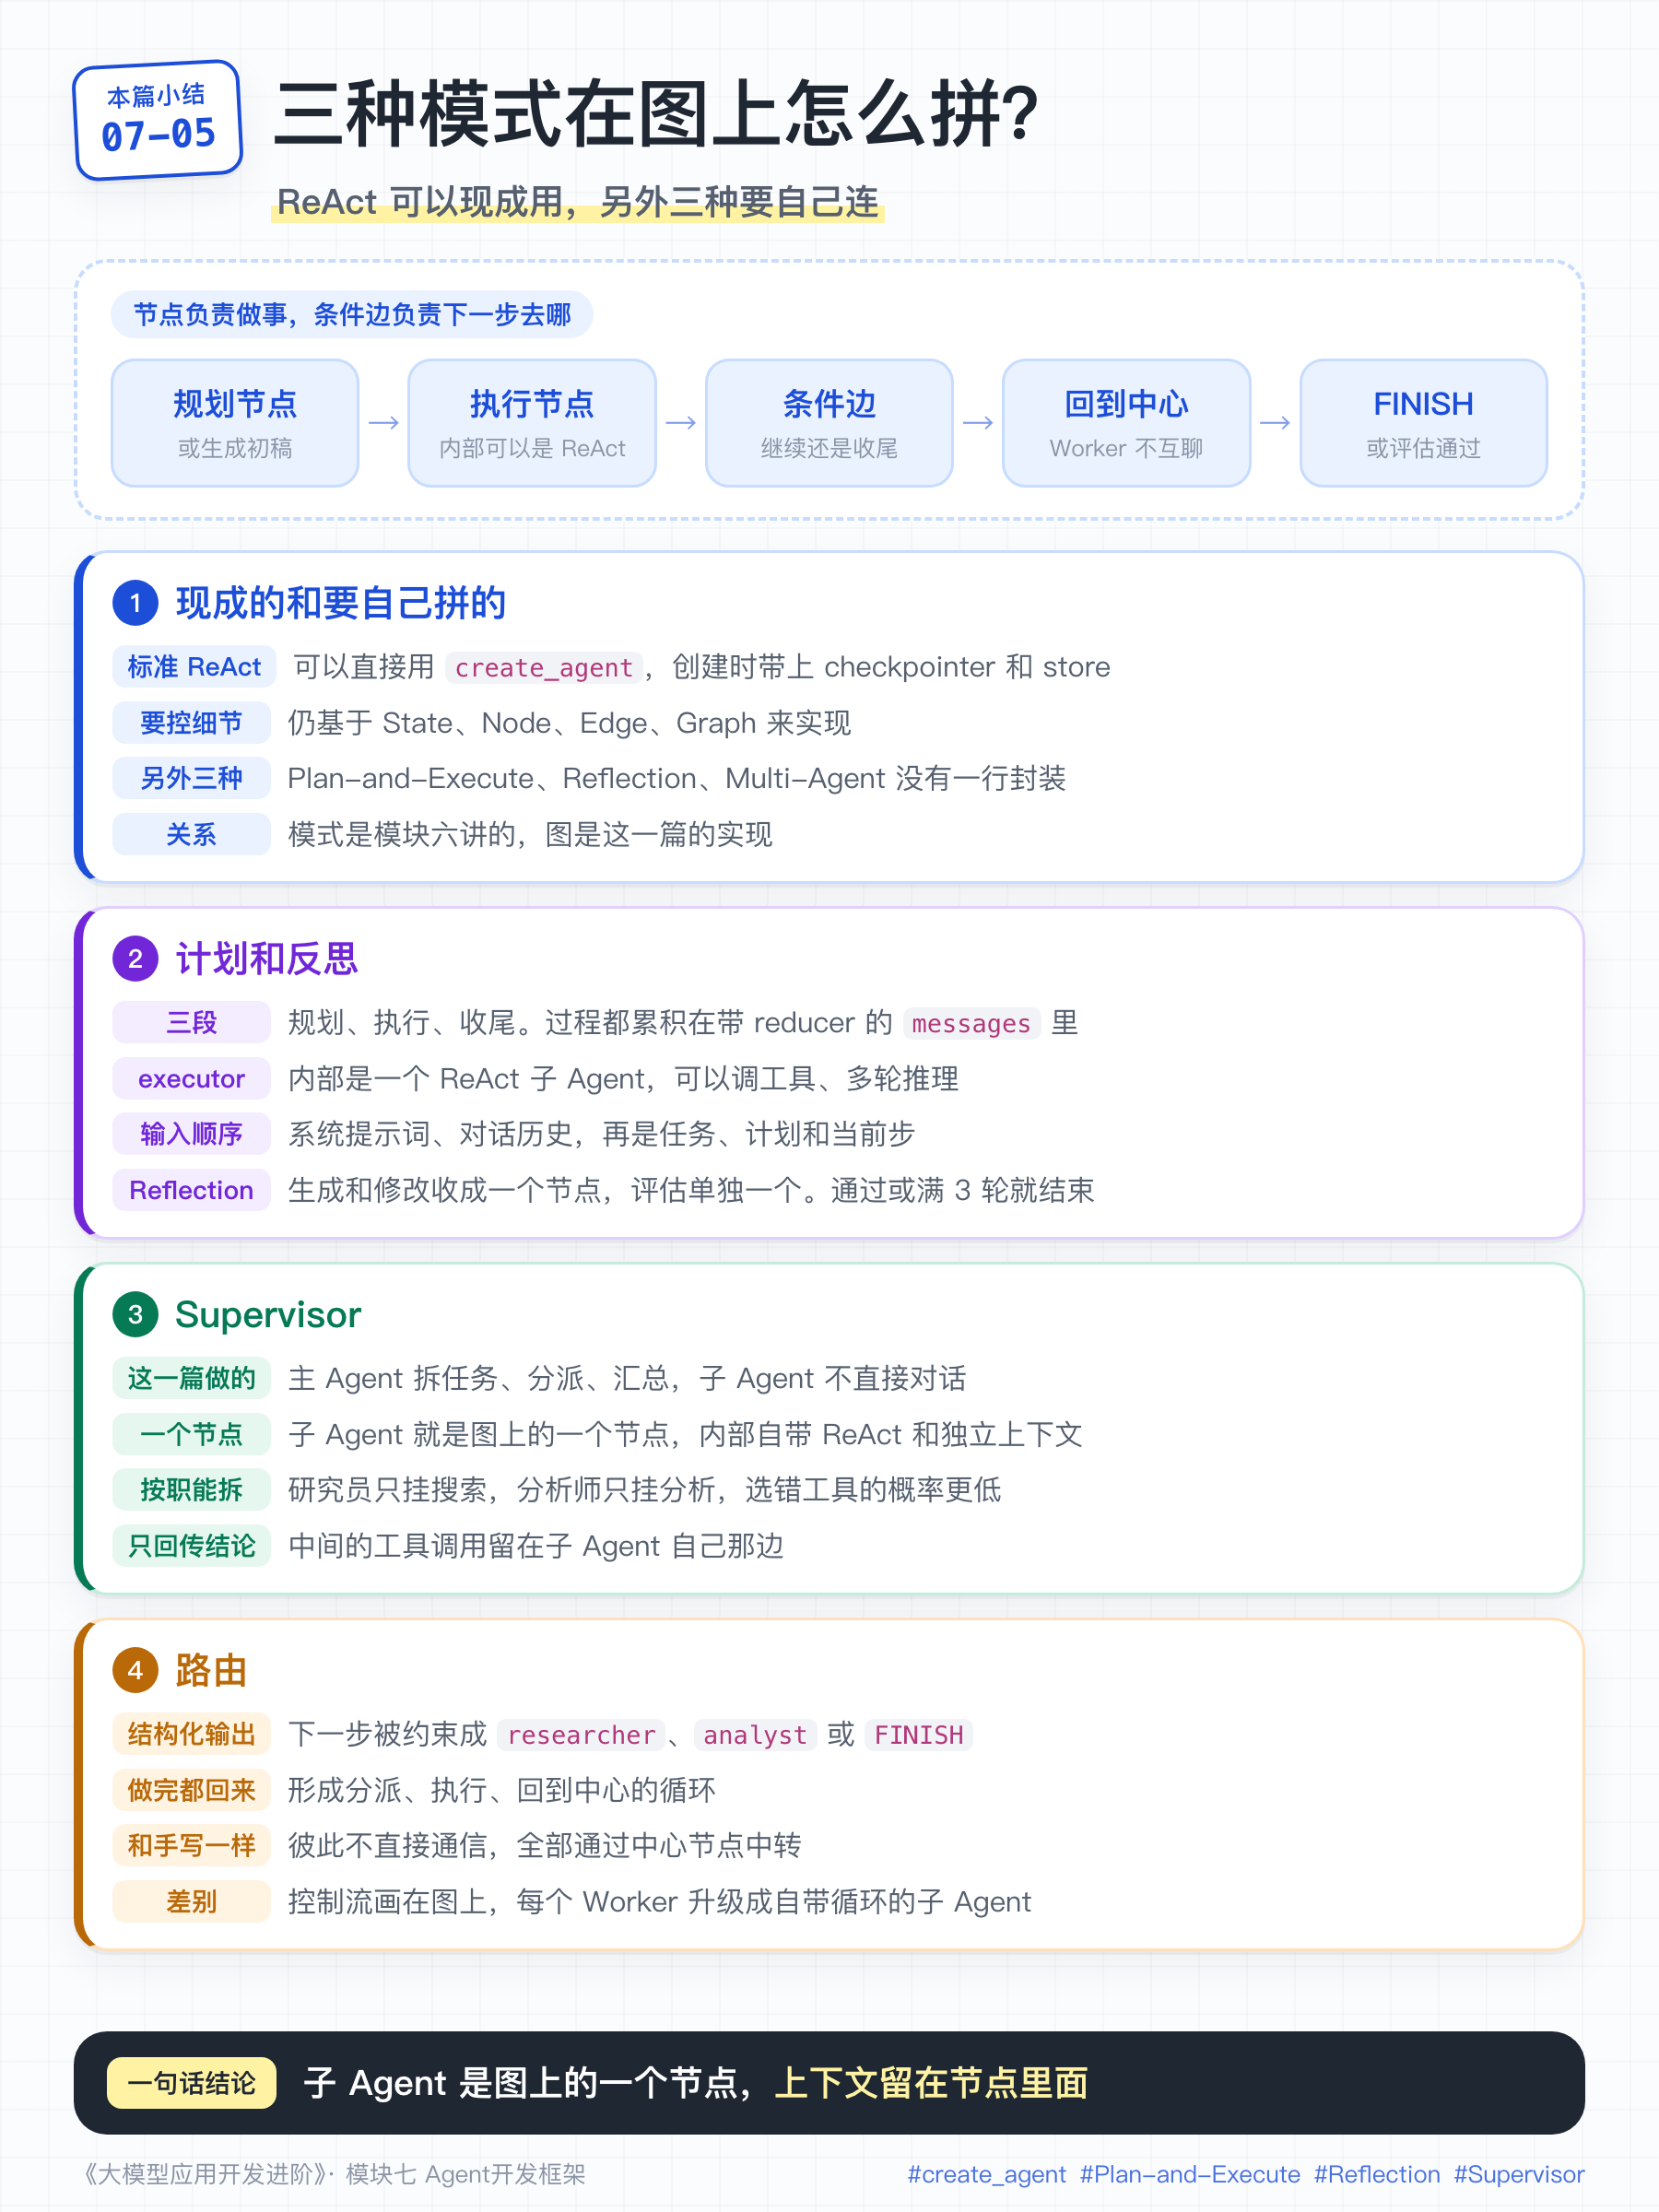
Agent 开发框架现在是日新月异,不停地涌现出各种框架,框架的功能也在不停地更新、丰富。
我们这里介绍几个主流的、市面上讨论比较多的开发框架。注意,这里只是简单介绍,让你有个印象。至于如何选型、具体开发时需要哪一个框架,你还是要自己去研究。
当然,你也无需把所有的框架都研究透彻,因为大多数框架具备的功能都是大同小异的,底层原理就是我们前面讲到的那些 Agent 技术。
只要掌握了前面的技术,对这些框架的理解就会比较透彻,用起来也会非常容易上手。
LangChain & LangGraph
先说这两个的关系,因为很多人分不清。
LangChain 出现得早,最初是一个把大模型调用串起来的库:提示词模板、链式调用、工具、RAG等。但随着 Agent 需要循环、需要维护状态,原来那套链式结构就不够用了。于是团队又做了 LangGraph,一个更底层的引擎,把 Agent 的运行抽象成一张图:State 存状态,Node 是一步操作,Edge 决定下一步走到哪,还支持条件路由、Checkpointer 持久化、中断与恢复。
两者的关系是依赖关系:LangChain 构建在 LangGraph 之上。
从安装层面就可以看出来这个关系,当你执行 pip install langchain 时,安装程序会自动把 langgraph 作为核心依赖一起装进来。反过来,pip install langgraph 不会安装 langchain。
LangGraph 的定位是 Agent Runtime(运行时)。它提供的是底层执行能力:状态图、检查点、持久化执行、Human-in-the-loop。它不关心你用哪家模型、怎么定义工具,只负责把“节点和边”组成的流程可靠地跑起来。后面几篇会详细讲解。
LangChain 的定位是 Agent Framework(开发框架)。它提供的是高层抽象和集成:统一的模型接口(init_chat_model)、工具定义(@tool)、Agent 创建(create_agent)、Middleware。开发者用 LangChain 可以快速搭出一个标准的 Agent,不需要接触图、状态、边这些 LangGraph 的概念。
Deep Agents
Deep Agents 同样出自 LangChain,是架在 LangGraph 更上层的一套封装,专门面向跑长任务的 Agent,比如深度调研、写长报告这一类。
它把 Claude Code这类产品验证过的几个做法直接做成了默认配置:一个规划工具(让模型先列待办再一步步做)、一套虚拟文件系统(把放不下的上下文落盘,用到再读回来)、以及派生子 Agent 的能力。换句话说,它把 Plan-and-Execute、上下文落盘、Multi-Agent 这几样打包成了开箱即用的默认值。当你要做的正是这类长任务时,用它能省掉自己从头开发的时间。
OpenAI Agents SDK、Claude Agents SDK
前面几个框架都是第三方做的,各家模型厂商自己也下场了,推出了官方的 Agent 开发 SDK。和 LangChain 这类通用框架不同,官方 SDK 的共同特点是:轻量、克制,优先把自家模型的能力发挥到极致,而不是追求支持所有模型、覆盖所有场景。
OpenAI Agents SDK 是 OpenAI 官方推出的轻量级框架,核心概念很少,就是 Agent(带指令和工具的模型)、Handoffs(把任务转交给另一个 Agent)、Guardrails(对输入输出做校验)、Sessions(自动管理对话历史)这么几样。它的循环逻辑、工具调用、多 Agent 转交都由 SDK 内置,还自带 Tracing(把每一步执行可视化出来,方便调试和观测)。它是 OpenAI 早期实验项目 Swarm 的生产级升级版,设计上刻意保持简单,上手很快。
Claude Agents SDK(原 Claude Code SDK)是 Anthropic 把 Claude Code 背后的那套 Agent 能力抽出来开放的 SDK,提供 Python 和 TypeScript 两个版本。它把 Claude Code 验证过的做法直接内置:自动管理上下文、读写文件和执行命令的工具、细粒度的权限控制、MCP 扩展、以及子 Agent。它尤其擅长那种需要长时间自主执行、反复读写文件和调用命令行的任务,比如写代码、做自动化运维。
Spring AI & Spring AI Alibaba
前面几个都是 Python 阵营的,Java 这边也有对应的方案。
Spring AI 是 Spring 官方做的大模型应用框架,把模型调用统一成 ChatClient,工具用 @Tool 注解声明,短期记忆有 ChatMemory,RAG 有 VectorStore 和 Advisor。它最大的价值是无缝接入现有的 Spring 生态,如果你的系统本来就是 Spring Boot,把大模型能力加进去几乎没有额外的接入成本。但是,它提供的构建Agent的支持非常有限。
Spring AI Alibaba 是阿里在 Spring AI 之上的扩展,补上了 Agent 开发需要各种技术实现,比如,图式编排(Spring AI Alibaba Graph,思路和 LangGraph 类似),并且和通义千问、Nacos、可观测性这些国内常用的组件结合得更紧。Java 团队如果需要更完整的 Agent 开发能力,可以直接使用它。
补充一句,Java 阵营除了 Spring 这条线,还有一个独立于 Spring 的 LangChain4J,思路借鉴 LangChain,适合不在 Spring 体系里的 Java 团队。
AgentScope
AgentScope 是阿里(通义实验室)开源的多 Agent 框架,重心在多 Agent 协作上。它和下面要讲的 AutoGen、CrewAI 有个区别:后者你只要设好角色和任务,Agent 之间怎么对话、按什么顺序走,基本由框架内部自动决定;而 AgentScope 要你自己写清楚:哪个 Agent 把消息发给谁、广播给哪些人、先执行谁后执行谁,整个协作流程都由你来控制。
单个 Agent 以 ReAct 为核心,常规的工具调用、记忆、MCP、Tracing 都支持。多 Agent 这块是它的特色:Agent 之间传 Msg 消息,用 MsgHub 广播(群聊式协作),用 Pipeline 编排顺序或并行,也支持一个主 Agent 调度多个子 Agent 的 master-worker 模式。它适合那种需要多个 Agent 协作、又想自己掌控协作流程的场景。
这里顺带说清楚它和前面 Spring AI Alibaba 的关系:两者是上下层关系,不是二选一的竞品。AgentScope 的本体是 Python 版,另有一个对齐它的 Java 移植版 AgentScope-Java,而 Spring AI Alibaba 的 Agent 能力底层就采用 AgentScope-Java 作为引擎。所以选型跟着技术栈走就行:Python 项目直接用 AgentScope,功能最全、更新最快;Java / Spring Boot 项目用 Spring AI Alibaba,既能接入现有 Spring 生态,又能通过底层的 AgentScope-Java 拿到 Agent 能力,不必自己去碰 AgentScope-Java。
AutoGen & CrewAI
这两个的重心都在多 Agent 协作上。
AutoGen 是微软做的,核心模型是让多个 Agent 通过对话互相协作,适合群聊式的分工的场景。
CrewAI 走的是角色分工的路子:你给每个 Agent 设定角色、目标和背景,再定义任务,交给一个 Crew 按分工执行。它的好处是「组一个 Agent 团队」这件事实现起来很容易,代价是灵活度不够,不如直接使用LangGraph这类更低层的框架来构建。
这两个的定位,决定了它们更适合那种一上来就是多角色协作的任务,而不是需要你对执行细节精细控制的场景。
小结:各框架是什么语言的
最后按语言把上面这些框架归一下类,方便你对照自己的技术栈。
Python 阵营(生态最全)
- LangChain / LangGraph:Python(也有 JS/TS 版的 LangChain.js)
- Deep Agents:Python(基于 LangGraph)
- OpenAI Agents SDK:Python(另有 TypeScript 版)
- Claude Agents SDK(原 Claude Code SDK):Python 和 TypeScript 两个版本
- AutoGen:Python(微软,另有 .NET 版)
- CrewAI:Python
- AgentScope:以 Python 为本体(另有 Java 移植版 AgentScope-Java)
Java 阵营
- Spring AI:Java
- Spring AI Alibaba:Java(底层引擎用 AgentScope-Java)
- LangChain4J:Java
三、使用框架 VS 手搓 Agent
讲完这些,回到最实际的问题:开发Agent,到底该用框架,还是自己从零手搓?
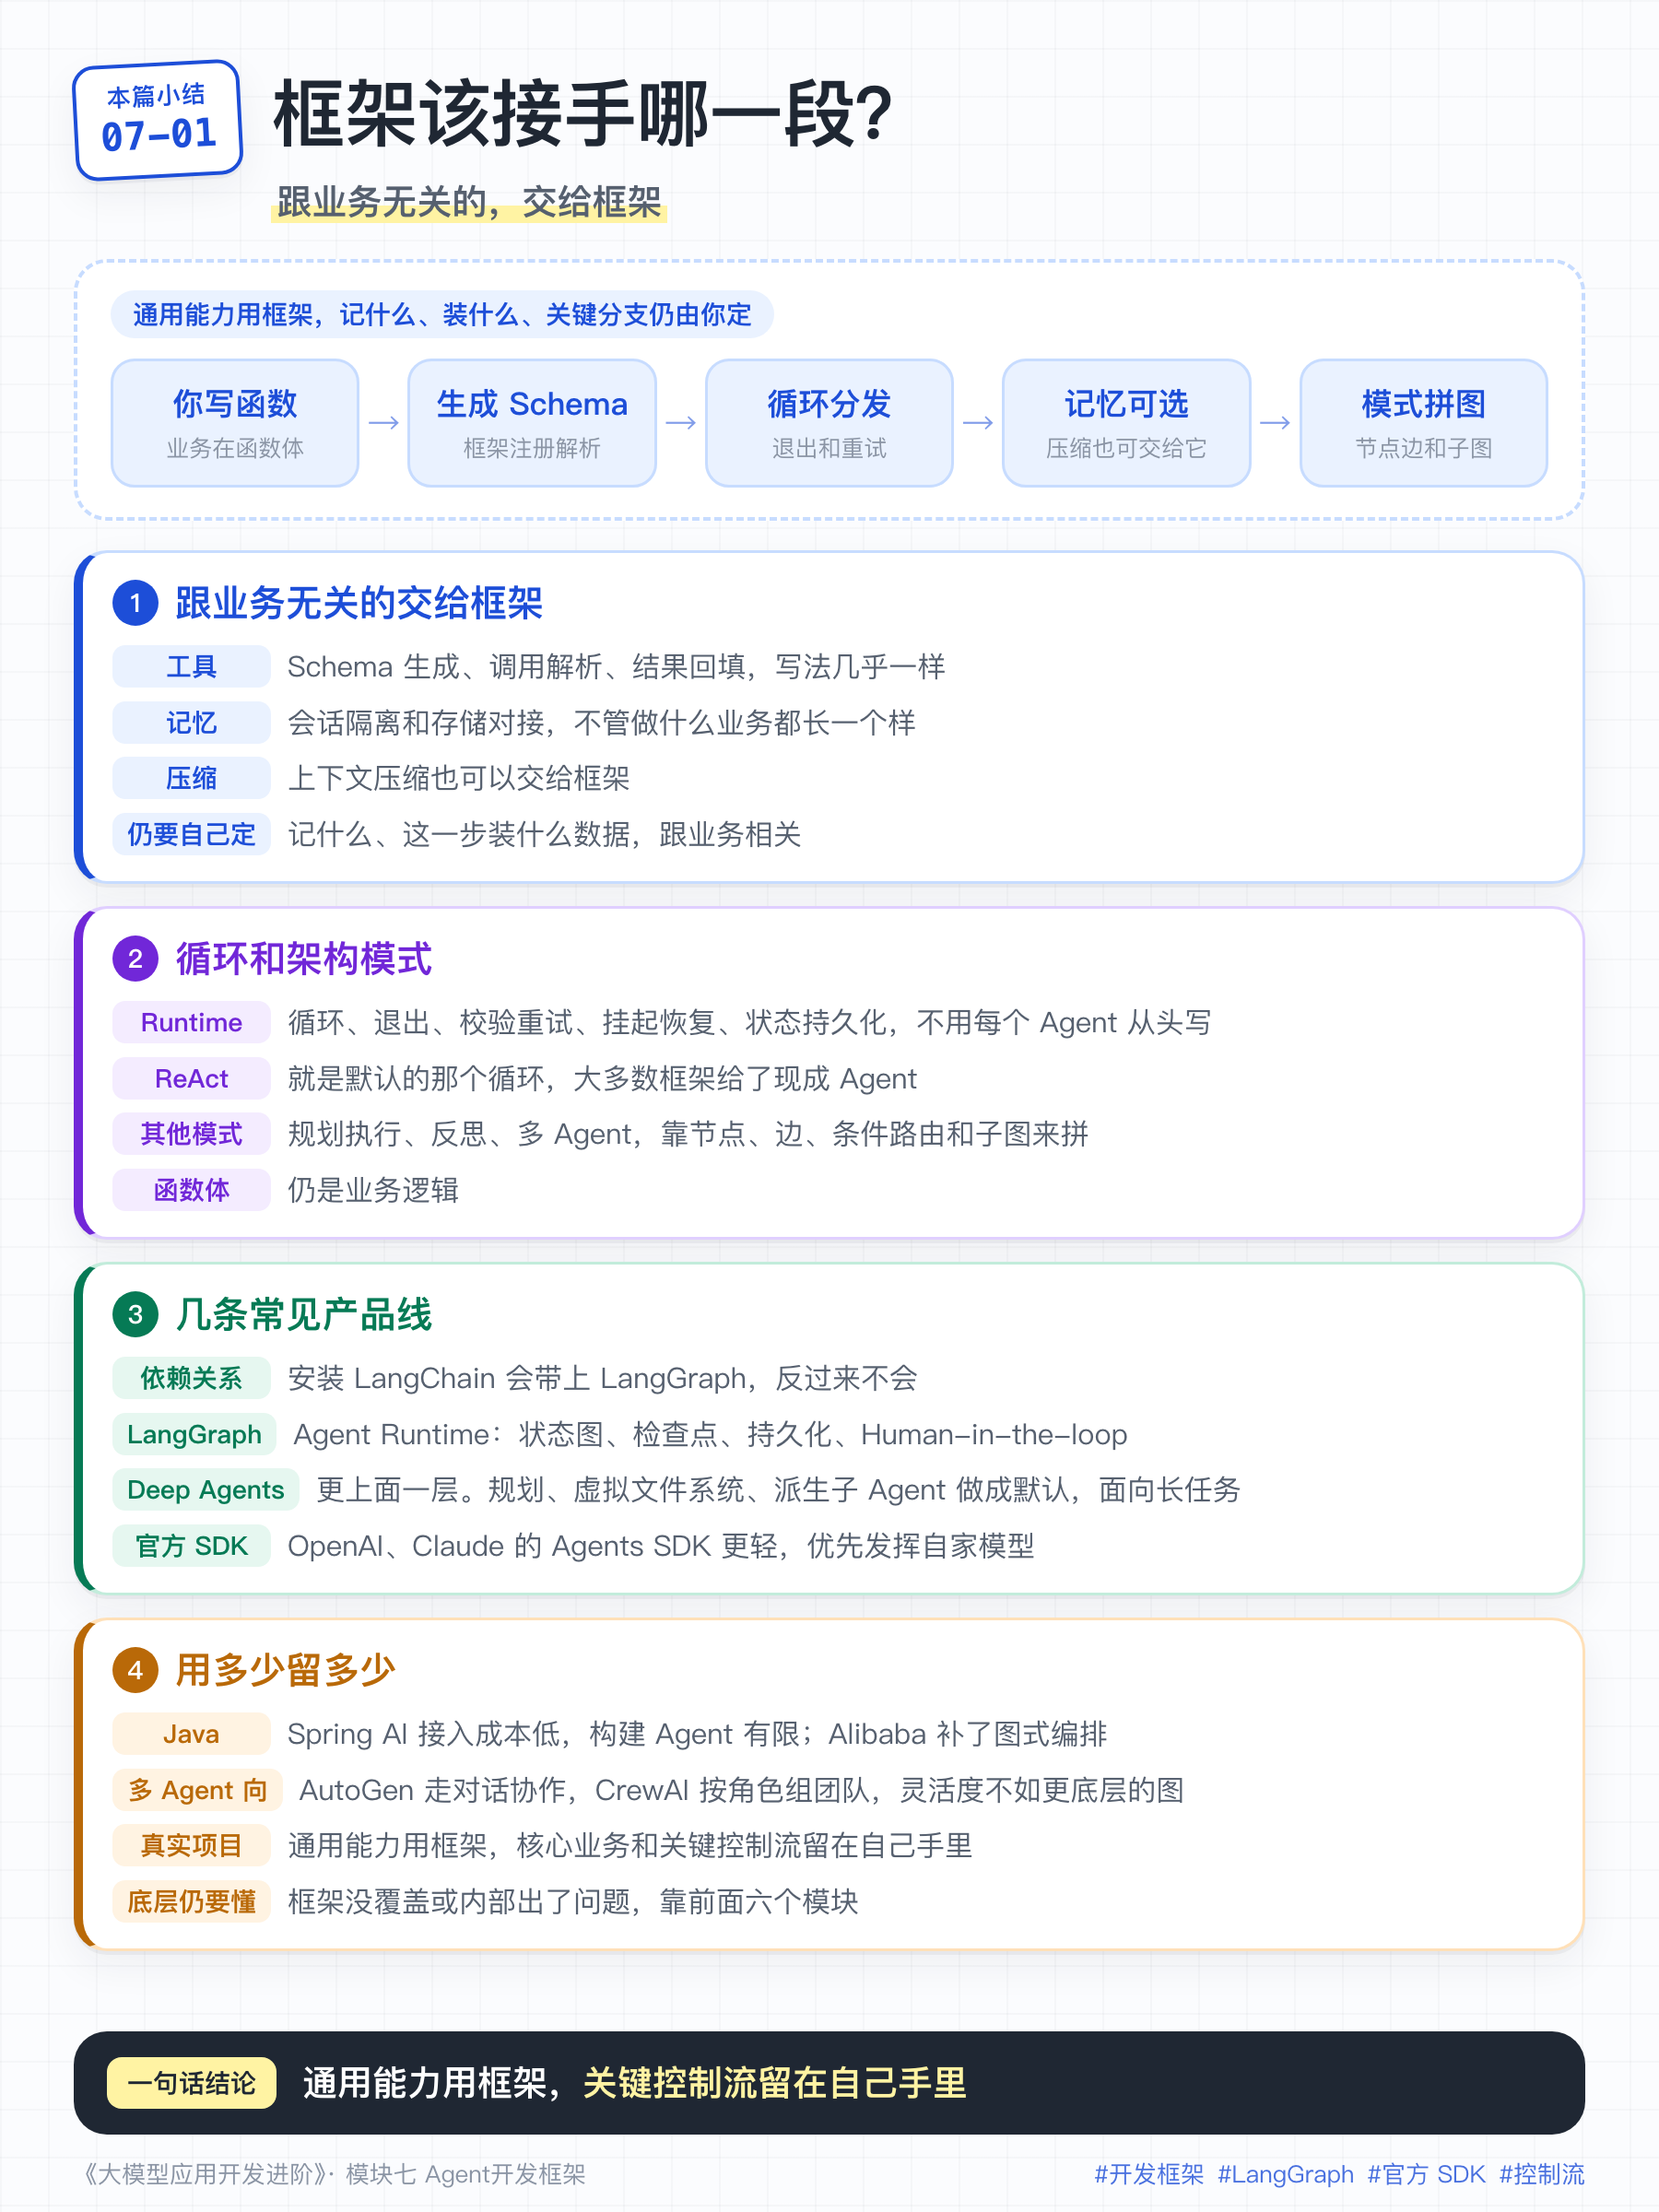
先说结论:真实项目里,大多数情况会用框架,但往往只用它的一部分。
为什么用框架?因为前面那些跟业务无关的功能:Schema 生成、调用循环、状态持久化、各家模型和工具的集成,框架都替你做好了,自己从头写既费时又容易出错。这部分逻辑比较清晰,用框架也不会导致对底层实现细节的模糊、debug难度的增加。
那为什么又只用一部分?因为框架不是没有代价的:有学习成本,框架抽象层次过多(出了问题得钻进框架内部才能查清楚),版本更新还快,用深了也会有迁移风险。所以常见的做法是,把框架里通用的那部分用起来(工具调用、模型适配、Checkpointer、各种集成),而把核心业务逻辑和关键的控制流留在自己手里,需要精细控制的地方甚至绕开框架自己写。
那什么时候干脆自己写?如果你的 Agent 很简单,就一个循环加两三个工具,引入一整套框架反而是负担;或者你对依赖和控制有很高的要求,也可以自己写。另外,为了学习原理而手写,同样很有价值。
这也正好回答了一个很多人纠结的问题:学了原理还要不要学框架?答案是,原理恰恰是你用好框架的前提。框架把细节藏了起来,但一旦遇到它没覆盖到的需求、或者它内部出了问题需要debug,能不能搞得定,靠的就是你对底层技术的理解。反过来,掌握了前面六个模块,再看这些框架,你会发现它们的功能大同小异,底层就是那些 Agent 技术,上手会非常快。
本篇小结
31-LangGraph实现最小Agent
上一节课,我们介绍了常用的主流Agent开发框架,从这节课开始,我们拿LangGraph最为代表来展开讲解下。
这一节课,我们先用LangGraph实现前面讲到的最小Agent。
一、LangGraph的四个核心概念
LangGraph 的四个核心概念:State、Node、Edge、Graph。
- State(状态):就是手写循环里那个不断追加的
messages列表,外加你需要的工作状态字段。 - Node(节点):手写循环体里被拆出来的一个个步骤。「调模型」是一个节点,「执行工具」是一个节点。
- Edge(边):手写循环里「这一步做完接着做哪一步」的走向。
- Graph(图):把节点和边装配在一起的那张完整流程图,相当于整个 Runtime 的骨架。
接下来我们一块一块把它们写出来。
二、定义 State
State 是整张图的地基,所有节点都读写它。在 LangGraph 里,State 通常用一个 TypedDict 来声明,告诉框架状态里有哪些字段、每个字段是什么类型。
对一个对话型 Agent 来说,最核心的字段就是消息列表:
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class AgentState(TypedDict):
    # messages 字段用 add_messages 这个 reducer 来更新
messages: Annotated[list, add_messages]这里有一个必须讲清楚的点:Annotated[list, add_messages] 里的 add_messages 是什么,为什么需要它。
节点返回的是「对state的更新」,而不是「新的完整state」。那框架拿到更新后,怎么把它合并进旧state?这个合并规则,就叫 reducer(归约函数)。
如果不指定 reducer,默认规则是「覆盖」:节点返回 messages,就把旧的 messages 整个替换掉。但对消息列表来说,我们要的显然不是覆盖,而是追加。模型新说的一句话、工具新返回的一条结果,都应该接在历史后面,而不是把历史冲掉。add_messages 就是官方提供的追加型 reducer,它负责把节点返回的新消息合并到已有列表末尾,还顺带处理了消息 ID 去重这类细节。
理解了 reducer,你就抓住了 LangGraph state 状态管理的关键:每个字段都可以有自己的合并规则,节点只管返回增量,怎么并进去由 reducer 决定。 这也是它和手写代码最不一样的地方,手写时你自己 messages.append(...),现在这个追加动作交给了 reducer。
三、定义节点:调用模型
节点就是一个普通函数,签名是「接收当前 State,返回要更新的字段」。先写最重要的节点:调用模型。
在此之前要先准备好模型和工具。模型用 LangChain 的统一入口初始化:
from langchain.chat_models import init_chat_model
from langchain_core.tools import tool

# 生产环境应锁定到带日期的快照 ID
llm = init_chat_model("gpt-5.6", model_provider="openai")

@tool
def get_weather(city: str) -> str:
    """查询某个城市今天的温度,返回摄氏度。"""
    data = {"北京": 5, "上海": 12}
    return f"{city}今天 {data.get(city, 20)} 摄氏度"

@tool
def calculator(expression: str) -> str:
    """计算一个数学表达式,比如 '12 - 5'。"""
    return str(eval(expression))

tools = [get_weather, calculator]

# 把工具描述绑定给模型,模型才知道有哪些工具可调
llm_with_tools = llm.bind_tools(tools)
@tool 装饰器会把函数签名和那句文档字符串,自动转成模型能看懂的工具描述(也就是我们手写的那份 JSON Schema)。bind_tools 则把这些描述附加到每次模型调用上。这两步合起来,省掉了我们自己拼工具定义的工作。
有了模型,调用模型的节点就很简单了。
def call_model(state: AgentState):
    # 读状态里的全部消息,交给模型
    response = llm_with_tools.invoke(state["messages"])
    # 只返回增量:模型新产出的这条消息
    # add_messages 会把它追加到 state["messages"] 末尾
    return {"messages": [response]}
对照最小Agent实现中的手写代码:那边是 message = call_model(messages) 再 messages.append(message),这里节点只负责返回新消息,追加动作交给了 add_messages。逻辑一模一样,只是职责被分开了。
四、定义节点:工具调用
在最小Agent里,执行工具那段逻辑我们自己写过:从模型返回解出 tool_calls,按名字找函数,执行,再把结果包成 tool 消息写回。这段每次都要重写、还容易出错的逻辑,LangGraph 用一个现成组件 ToolNode 替我们做了。
from langgraph.prebuilt import ToolNode

# 把工具列表交给 ToolNode,它就是一个能执行工具的节点
tool_node = ToolNode(tools)
ToolNode 读状态里最新那条消息,取出其中的工具调用,逐个执行(一轮里有多个工具调用也会都处理),再把每个结果包成带正确 tool_call_id 的 tool 消息写回状态。
五、用条件路由实现分支与循环
现在节点都有了:call_model 和 tool_node。接下来要把它们按流程连起来。
流程本身,我们已经很熟悉了:模型回复后判断一下,要调工具就去执行工具、执行完再回到模型;不调工具就说明任务完成,结束。这里的「判断一下」就是条件路由,而「执行完再回到模型」会形成一个循环。
先写判断函数。它读状态里最新那条消息,看模型有没有提出工具调用:
def should_continue(state: AgentState) -> str:
    last_message = state["messages"][-1]
    # 模型提出了工具调用 —— 去执行工具
    if last_message.tool_calls:
        return "call_tools"
    # 没有工具调用 —— 任务完成,结束
    return "end"
这个函数返回的是一个字符串标签,框架根据标签决定下一步走到哪个节点。它对应的正是手写循环里那句 if not message.tool_calls,只不过现在它是一条画在图上的分叉线。
六、把Graph图装配起来
state、node、判断函数都齐了,现在通过edge,把它们装进一张 StateGraph:
from langgraph.graph import StateGraph, START, END

# 用 AgentState 作为状态结构,新建一张图
builder = StateGraph(AgentState)

# 注册两个节点
builder.add_node("call_model", call_model)
builder.add_node("call_tools", tool_node)

# 入口:从 START 进入,先到 call_model
builder.add_edge(START, "call_model")

# 条件边:call_model 之后,按 should_continue 的返回值分叉
builder.add_conditional_edges(
    "call_model",
    should_continue,
    {
        "call_tools": "call_tools",   # 返回 "call_tools" -> 去 call_tools 节点
        "end": END,         # 返回 "end" -> 结束
    },
)

# 普通边:call_tools 执行完,回到 call_model,形成循环
builder.add_edge("call_tools", "call_model")

# 编译成可运行的图
graph = builder.compile()
这段代码就是整个 Agent 的骨架,它最小Agent实现中的 for 循环完整地翻译成了一张图:
START -> call_model:进来先调模型,对应循环的第一步。call_model的条件边:模型回复后:有工具调用去tools,没有就END。这是循环的退出判断。call_tools -> call_model:工具执行完回到模型。正是这条回边,构成了 Agent 的循环。
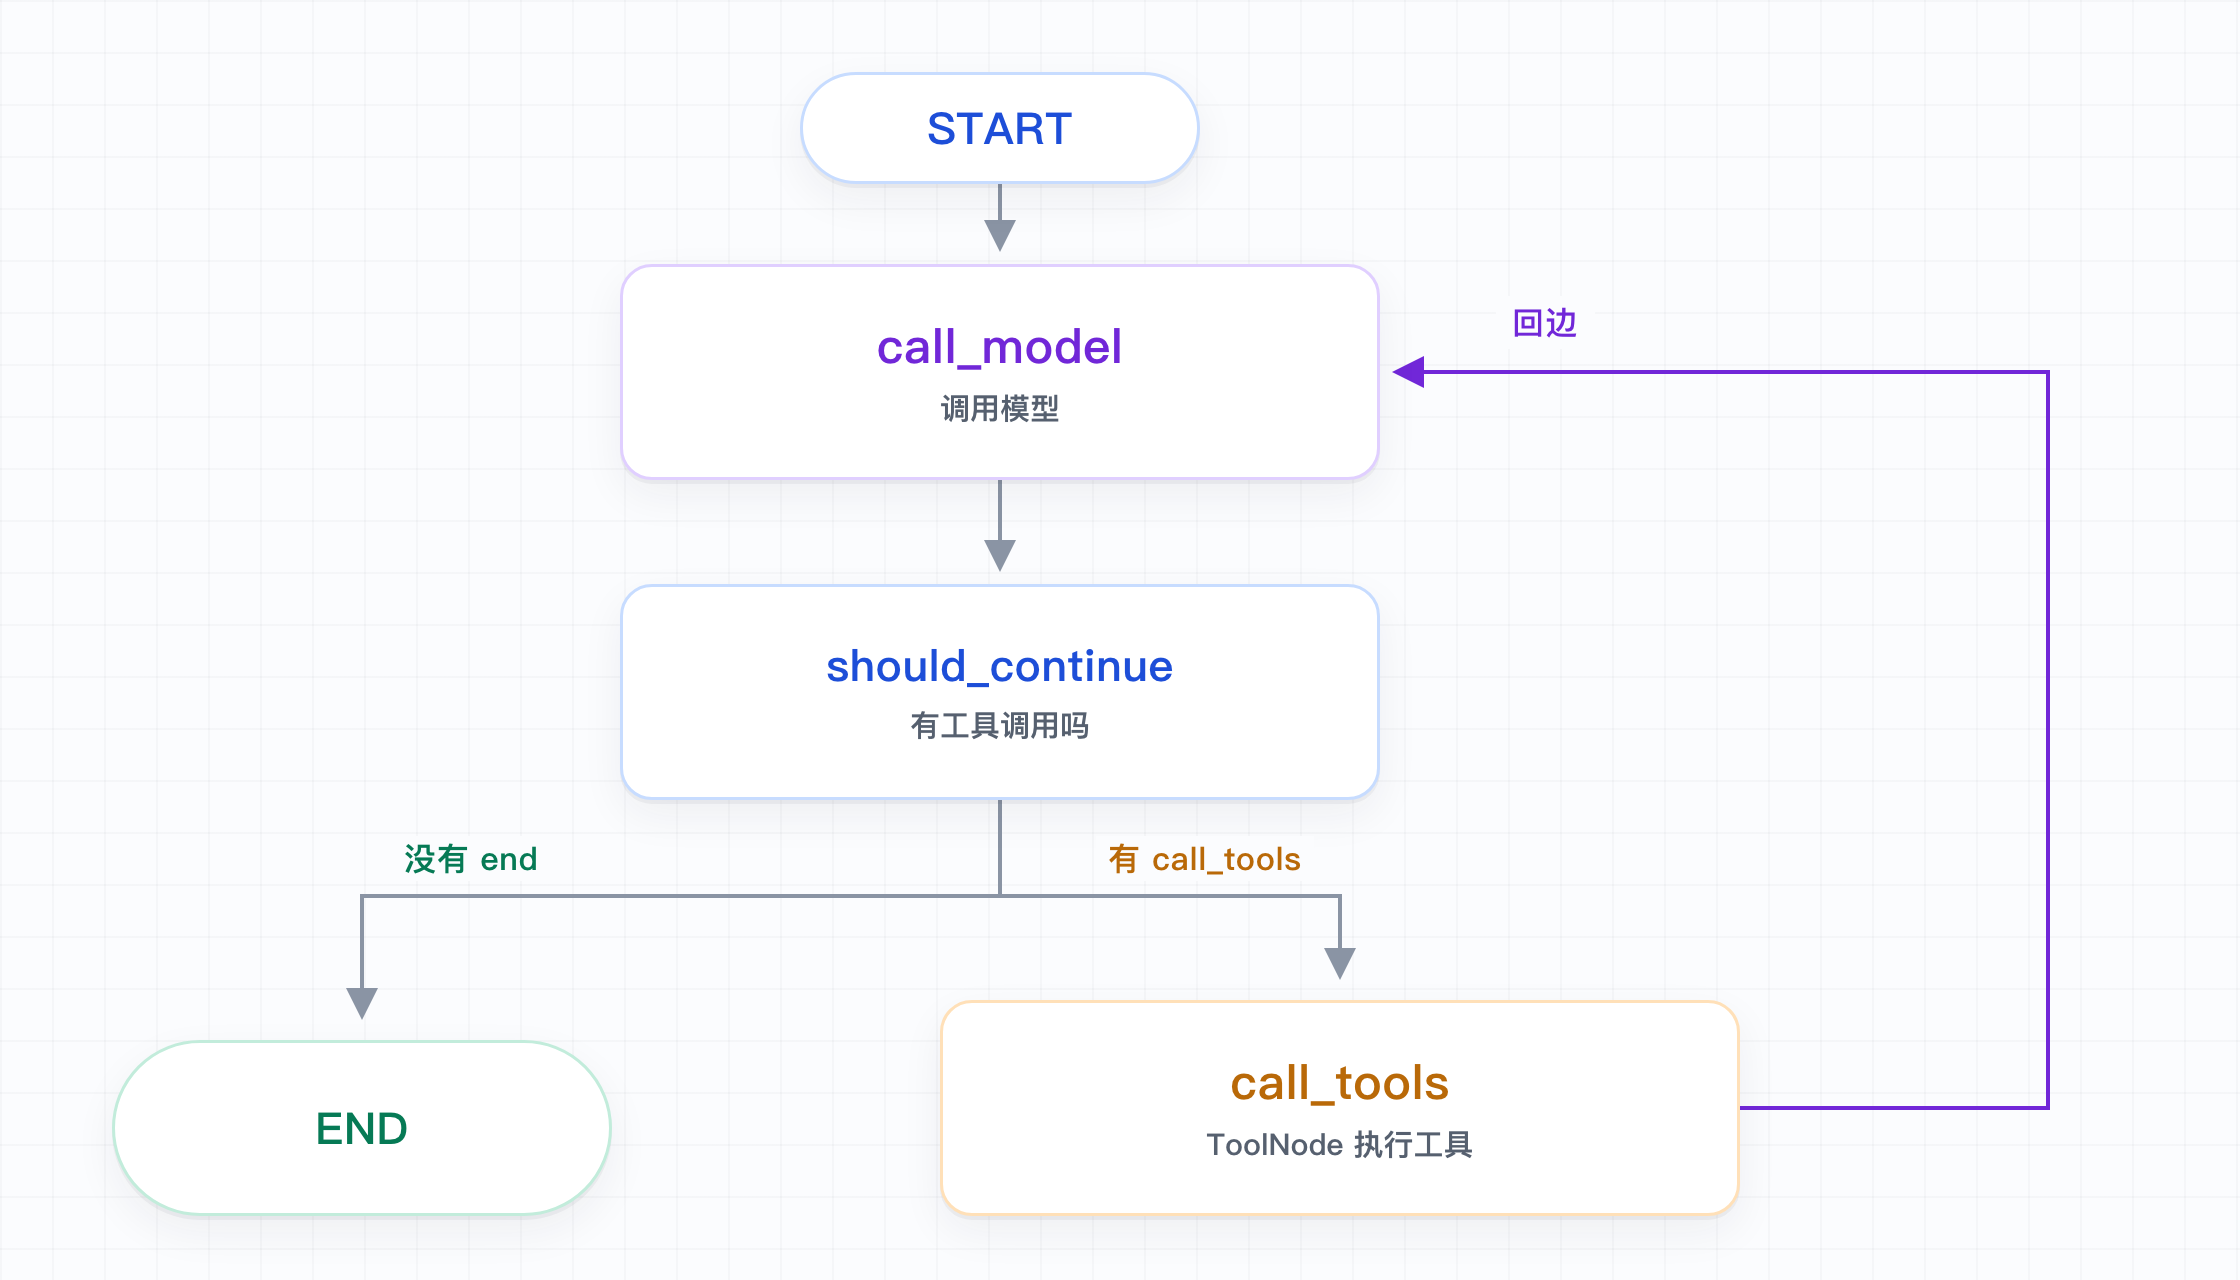
循环控制、状态合并、工具执行这些你原本要自己写的部分,现在都由框架按图来驱动了。
七、运行与运行控制
图编译完就能跑。最简单的方式是 invoke,传入初始状态:
result = graph.invoke({
    "messages": [{"role": "user", "content": "北京和上海今天的温差是多少度?"}]
})

# result["messages"] 里是完整的对话轨迹:
# 用户问题 -> 模型要调 get_weather(北京) -> 工具结果
#          -> 模型要调 get_weather(上海) -> 工具结果
#          -> 模型要调 calculator -> 工具结果
#          -> 模型给出最终答案
print(result["messages"][-1].content)
invoke 会一次跑到底,返回终态。如果你想看中间每一步的进展(做成打字机式的输出,或者打日志),用 stream:
for chunk in graph.stream(
    {"messages": [{"role": "user", "content": "北京和上海今天的温差是多少度?"}]},
    stream_mode="values",
):
    # 每执行完一个节点,就吐出一次当前状态
chunk["messages"][-1].pretty_print()最后说一个必须配的运行控制:防止图无限循环。 模块五我们用 max_steps 兜底,LangGraph 对应的是 recursion_limit,图执行的节点步数上限。模型如果一直要调工具、停不下来,到达上限会直接抛错,而不是无限跑下去:
config = {"recursion_limit": 25}
graph.invoke({"messages": [...]}, config=config)
这正是模块五讲「如何让循环安全停下来」在框架里的落地:步数上限是最基本的那道兜底。至于预算、循环检测这些更细的退出条件,框架不会全替你做,仍然要你在节点里自己加判断。
八、从这个例子看框架和手写的对应关系
把这一篇和模块五摆在一起对照,你会很清楚地看到每一块的对应:
| 手写 Runtime | LangGraph |
|---|---|
messages 列表 | State 里的 messages 字段 |
messages.append(...) | add_messages reducer |
call_model(messages) | call_model 节点 |
解析 tool_calls、执行、写回 | ToolNode |
if not message.tool_calls | 条件路由 should_continue |
for 循环 + 回到开头 | call_tools -> call_model 的回边 |
max_steps | recursion_limit |
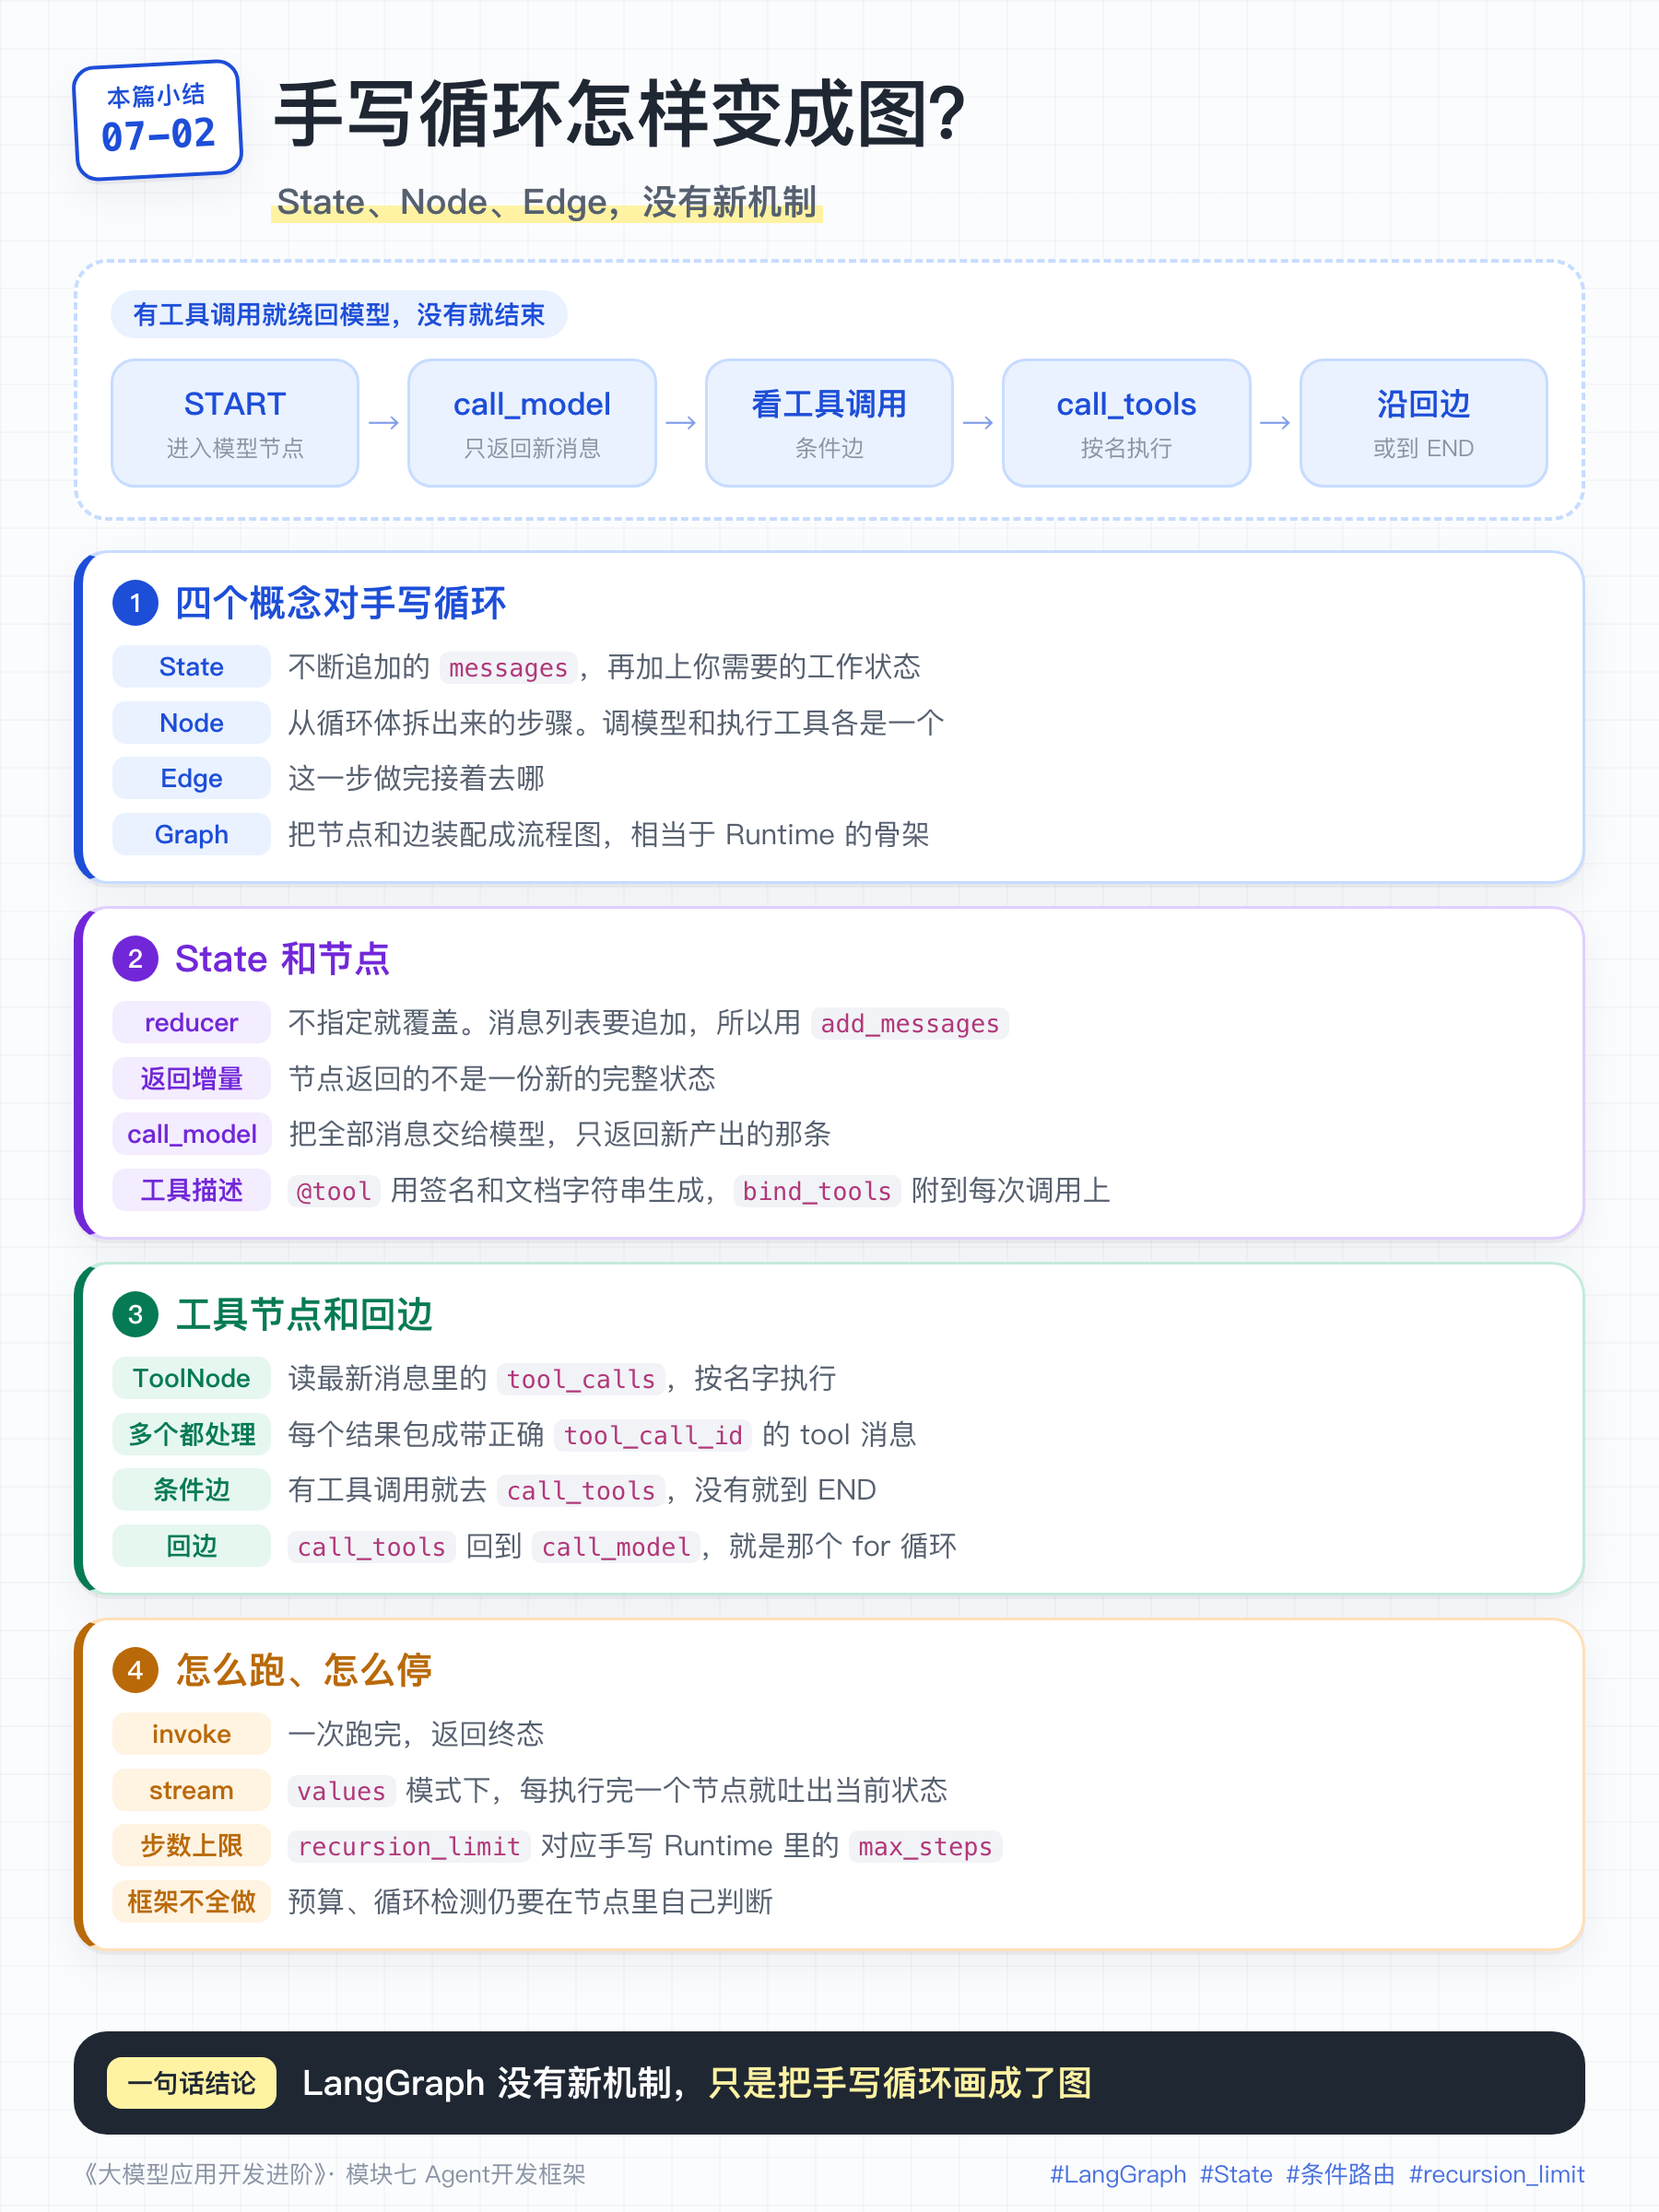
看懂这张表,你就抓住了这一篇的核心:LangGraph 没有发明新的 Agent 机制,它只是把模块五那段手写循环,用「图」这种更结构化、更好维护的方式重新表达了一遍。
本篇小结
32-LangGraph持久化和人工介入
上一篇我们用 LangGraph 把查天气、做计算的 Agent 搭了出来,但只用 invoke 一跑到底。那个版本有两个硬伤:进程一崩,跑到一半的状态就没了;遇到有副作用的操作,它不会停下来等人确认。
这两件事,正是模块5中讲到的:持久化和人工介入。
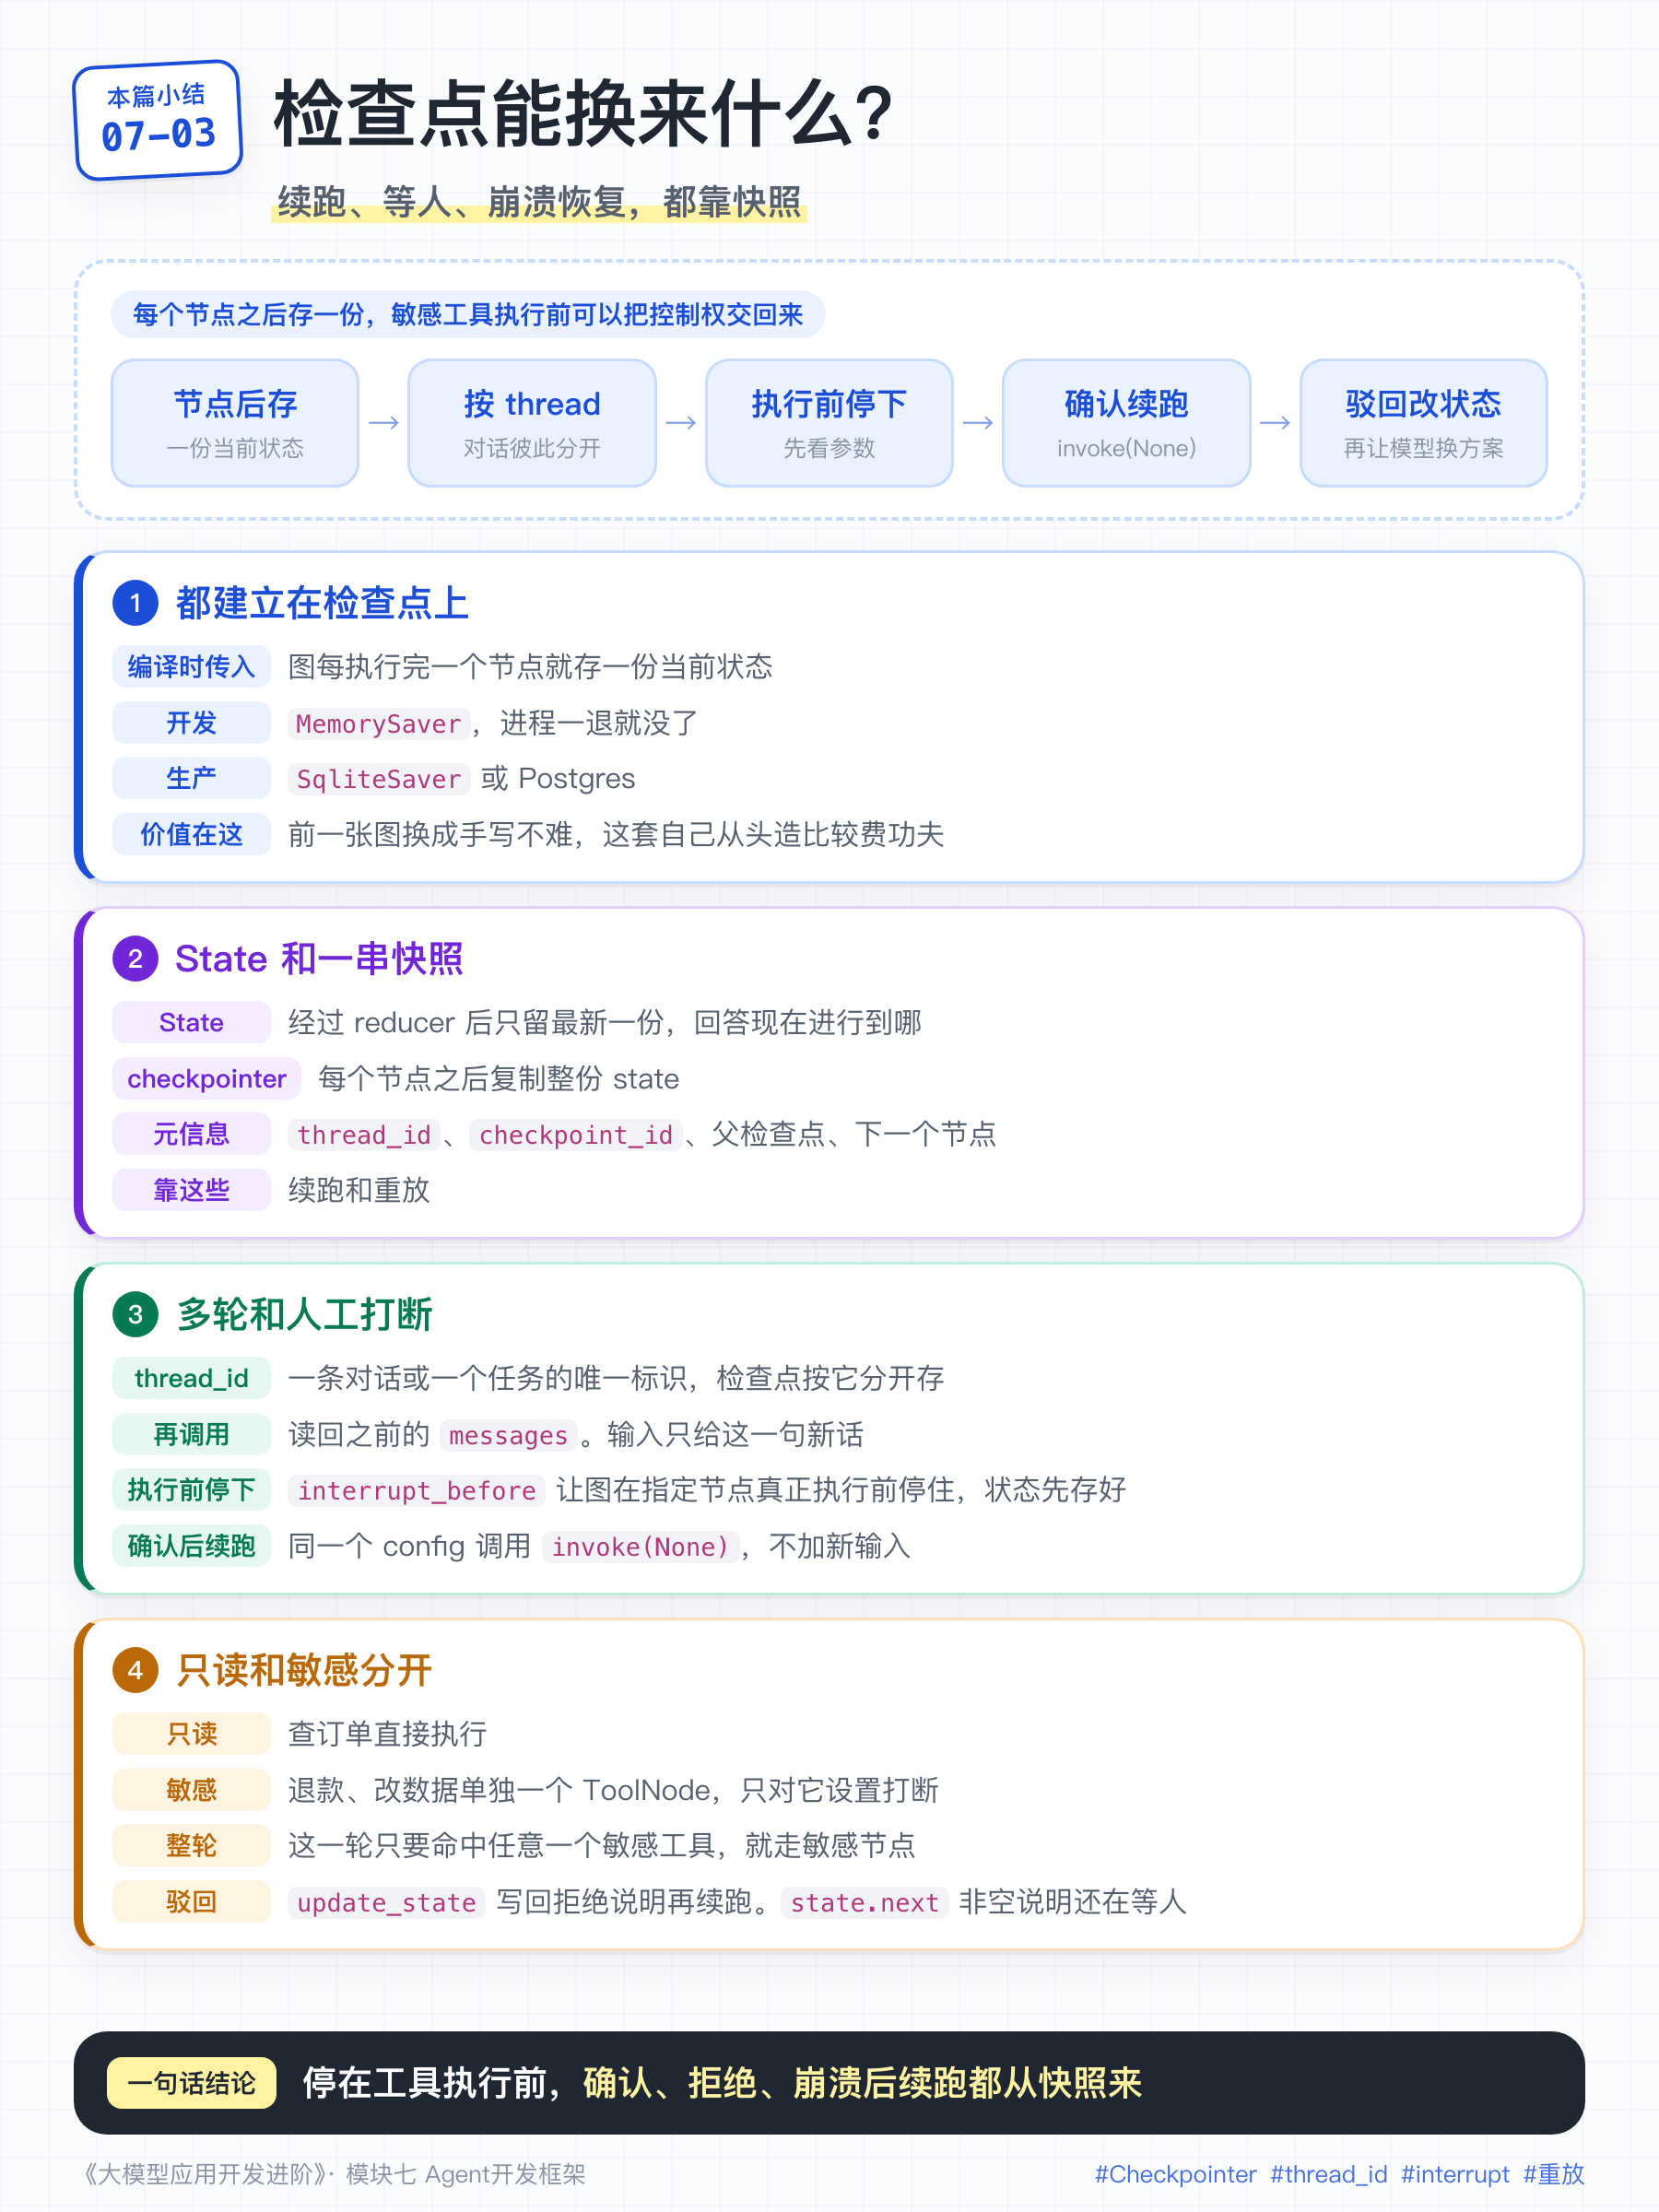
这一篇就把它们补上,这就要讲到LangGraph中的一个核心机制:检查点(Checkpoint)。
你会看到,持久化、多轮任务、中途停下等人、崩溃恢复、甚至回到过去重跑,全都建立在检查点之上。
这一篇也是 LangGraph 真正体现价值的地方。前一篇那张图,换成手写循环也不难;但接下来这套持久化和人工介入,自己从头造还是比较费功夫的。
一、CheckPointer 检查点
要开启检查点功能,只需要在构建图的时候传一个 checkpointer。图每执行完一个节点,框架就把当前状态(state和其他一些信息)完整存一份。
开发和测试阶段,可以用存在内存里的 MemorySaver:
from langgraph.checkpoint.memory import MemorySaver

checkpointer = MemorySaver()
graph = builder.compile(checkpointer=checkpointer)但内存版MemorySaver有一个问题,进程一退就没了,上生产要换成持久化的版本,比如 SQLite 或 Postgres:
# 生产环境:把状态落到 SQLite(Postgres 同理,换对应的 Saver)
from langgraph.checkpoint.sqlite import SqliteSaver

with SqliteSaver.from_conn_string("checkpoints.db") as checkpointer:
    graph = builder.compile(checkpointer=checkpointer)
# ...在这个上下文里使用 graph那么,接下来,我们再说下上一篇讲到的state和这里的checkpointer之间关系。一句话先说结论:state 是「此刻」的那一份数据,checkpointer 是存下来的一串 state 快照,外加一些元信息。
先看 state 存什么。 就是上一篇那个 TypedDict 定义的东西,核心是 messages 列表,再加上你自己加的工作字段。它是一个瞬时快照,回答的是「现在手头有哪些数据、任务进行到哪一步」。比如用户问「北京今天多少度」,图跑完一轮,此刻的 state 大致是这样:
{
    "messages": [
        HumanMessage("北京今天多少度?"),
        AIMessage(tool_calls=[get_weather(city="北京")]),  # 模型要调工具
        ToolMessage("北京今天 5 摄氏度"),                    # 工具结果
        AIMessage("北京今天 5 摄氏度。"),                    # 模型最终回答
    ]
}注意这只是一份数据,是「现在」的样子。节点每次返回的增量,经过 add_messages 这类 reducer 合并后,覆盖到这份 state 上,它始终只保留最新的一份。
再看 checkpointer 存什么。 checkpointer 不是只存最新那一份,而是每执行完一个节点,就把当时那一整份 state 复制一份存下来,于是执行一轮对话,会留下一串按时间排列的快照。还是上面这个例子,实际会落下好几个检查点:
| 检查点 | 什么时候存的 | 当时 state 里的 messages |
|---|---|---|
| ckpt-1 | 收到输入后 | [用户问题] |
| ckpt-2 | call_model 执行完 | [用户问题, AI(要调 get_weather)] |
| ckpt-3 | call_tools 执行完 | [用户问题, AI, 工具结果] |
| ckpt-4 | call_model 再执行完 | [用户问题, AI, 工具结果, AI(最终回答)] |
而且每个检查点除了那份 state 快照,还带着一些元信息:它属于哪条 thread_id(待会会讲)、 checkpoint_id、父检查点是谁、下一个该走哪个节点(也就是后面要用到的 state.next)等等。正是这些元信息,才让后面讲的「从断点续跑」「回到第 3 步重放」成为可能。
二、Thread 与多轮任务
开了 checkpointer 之后,调用图时必须多传一个东西:thread_id。
config = {"configurable": {"thread_id": "user-42-session-1"}}

graph.invoke(
    {"messages": [{"role": "user", "content": "北京今天多少度?"}]},
    config=config,
)
thread_id 是一条对话(或者说一个任务)的唯一标识。框架把每条 thread 的检查点分开存。它的作用是会话隔离。
有了 thread_id,多轮对话就不用自己管历史了。你带着同一个 thread_id 再调一次,框架会自动把 thread_id对应之前存的状态读回来,接着往下跑:
# 同一个 thread_id,接着上一轮问
graph.invoke(
    {"messages": [{"role": "user", "content": "那上海呢?"}]},
    config=config,  # thread_id 不变
)
注意,输入只给了「那上海呢」这一句新消息,没有显式地重新传之前的整段对话历史,因为这部分工作由框架的检查点来打包做掉了,框架会从检查点里读回了之前的 messages,再用 add_messages 把新消息追加上去。
三、中断和人工确认
持久化解决了「状态不丢」,接下来解决「该停的时候能停」。
前面说过,付款、删库、对外发消息这类有副作用的操作,不能让模型自己决定要不要做,Runtime 得停下来等人确认。
LangGraph提供了机制来中断执行流程。如下所示,构建图时,用 interrupt_before 指定「执行到某个节点之前先停下」:
graph = builder.compile(
    checkpointer=checkpointer,
    interrupt_before=["call_tools"],   # 执行 call_tools 节点前先停
)
这样,每当模型决定要调工具、图即将走到 tools 节点时,它会先把当前状态存成检查点,然后停下来,把控制权交还给你的程序:
config = {"configurable": {"thread_id": "t-1"}}

# 第一段:跑到 tools 之前会停下
graph.invoke({"messages": [{"role": "user", "content": "帮我把这单退款"}]}, config)

# 此时图已暂停。可以查看它准备调用什么工具
state = graph.get_state(config)
last_message = state.values["messages"][-1]
print("模型打算调用:", last_message.tool_calls)
graph.get_state(config) 把当前这条 thread 的最新状态读出来,你能看到模型「打算」调哪个工具、传什么参数,但工具还没真正执行。
人看过、觉得没问题,怎么让它继续?带着同一个 config 再调一次,输入传 None,表示「不加新输入,从断点接着跑」:
# 人确认通过,从断点继续,这次会真正执行 tools
graph.invoke(None, config)
五、失败恢复与重放
检查点一旦把每一步都存了下来,就不只能「从断点往下跑」,还能「回到任意一步重新跑」。这对调试和失败恢复特别有用。
先说失败恢复。 长任务跑到第八步,进程崩了。因为前七步的状态都在 checkpointer 里,重启后你带着原来的 thread_id 调一次 invoke(None, config),框架读回最近的检查点,从第八步接着跑,前面七步的执行结果一点都不丢。
再说重放。 每个检查点都有自己的 ID。你可以列出一条 thread 的全部历史检查点,挑其中某一个,让图从那个点重新往下走:
# 列出这条 thread 的所有历史检查点(从新到旧)
history = list(graph.get_state_history(config))

# 选中某一个较早的检查点
target = history[3]

# 用它的 checkpoint_id 构造 config,从这一步重新跑
replay_config = target.config
graph.invoke(None, replay_config)重放的价值在于:Agent 走偏时,你不用从头重来,而能回到走偏之前的那一步,改点东西再往下试。
六、完整代码示例
OK,有了前面的铺垫,我们给出一个较完整的代码示例。
第一步:把工具分成两组。
from langgraph.prebuilt import ToolNode

# 安全工具:只读,随便调
safe_tools = [get_order, get_logistics]

# 敏感工具:动钱、改数据,要人工确认
sensitive_tools = [refund, update_order]

# 绑给模型时两组都要绑,模型得知道所有工具
llm_with_tools = llm.bind_tools(safe_tools + sensitive_tools)

# 记一个「敏感工具名」的集合,路由时要用
SENSITIVE_TOOL_NAMES = {t.name for t in sensitive_tools}
第二步:建两个 ToolNode,成为两个独立节点。
builder.add_node("call_model", call_model)
builder.add_node("call_safe_tools", ToolNode(safe_tools))            # 普通工具节点
builder.add_node("call_sensitive_tools", ToolNode(sensitive_tools))  # 敏感工具节点
第三步:路由时,按「模型要调哪个工具」分叉。 原来的 should_continue 只判断「要不要调工具」,现在要再多判断一步「要调的是不是敏感工具」:
def should_continue(state: AgentState) -> str:
    last_message = state["messages"][-1]
    if not last_message.tool_calls:
        return "end"                       # 没有工具调用,结束
    # 这一轮只要命中任意一个敏感工具,就整轮走敏感节点
    for call in last_message.tool_calls:
        if call["name"] in SENSITIVE_TOOL_NAMES:
            return "sensitive"
    return "safe"

builder.add_conditional_edges(
    "call_model",
    should_continue,
    {
        "safe": "call_safe_tools",            # 普通工具 -> 不中断,直接执行
        "sensitive": "call_sensitive_tools",  # 敏感工具 -> 进节点前会被拦下
        "end": END,
    },
)

# 两个工具节点执行完,都回到模型
builder.add_edge("call_safe_tools", "call_model")
builder.add_edge("call_sensitive_tools", "call_model")
第四步:只对敏感节点中断,然后接上人工审核。
# 只在 sensitive_tools 节点前停,safe_tools 照常跑
graph = builder.compile(
    checkpointer=checkpointer,
    interrupt_before=["call_sensitive_tools"],
)

config = {"configurable": {"thread_id": f"ticket-{ticket_id}"}}

# 先跑,遇到敏感操作会自动停下(查天气、查订单这类不会停)
graph.invoke({"messages": [user_input]}, config)

# 检查它想干什么,交给人工审核
state = graph.get_state(config)
if state.next:  # state.next 非空,说明图在等待,还没结束
    pending = state.values["messages"][-1].tool_calls
    approved = ask_human_to_review(pending)   # 你的审批逻辑

    if approved:
        graph.invoke(None, config)            # 放行
    else:
        # 驳回:写回一条拒绝说明,让模型换个方案
        graph.update_state(
            config,
            {"messages": [{"role": "tool", "content": "操作被人工驳回,请改用其他方式"}]},
        )
        graph.invoke(None, config)
本篇小结
33-LangGraph的记忆和上下文
上一篇文章,我们讲了使用LangGraph实现持久化和人工介入,主要靠的是CheckPointer检查点。本篇文章,我们讲如何使用LangGraph实现模块三中讲的分层记忆、模块四中讲的上下文工程。
一、分层记忆
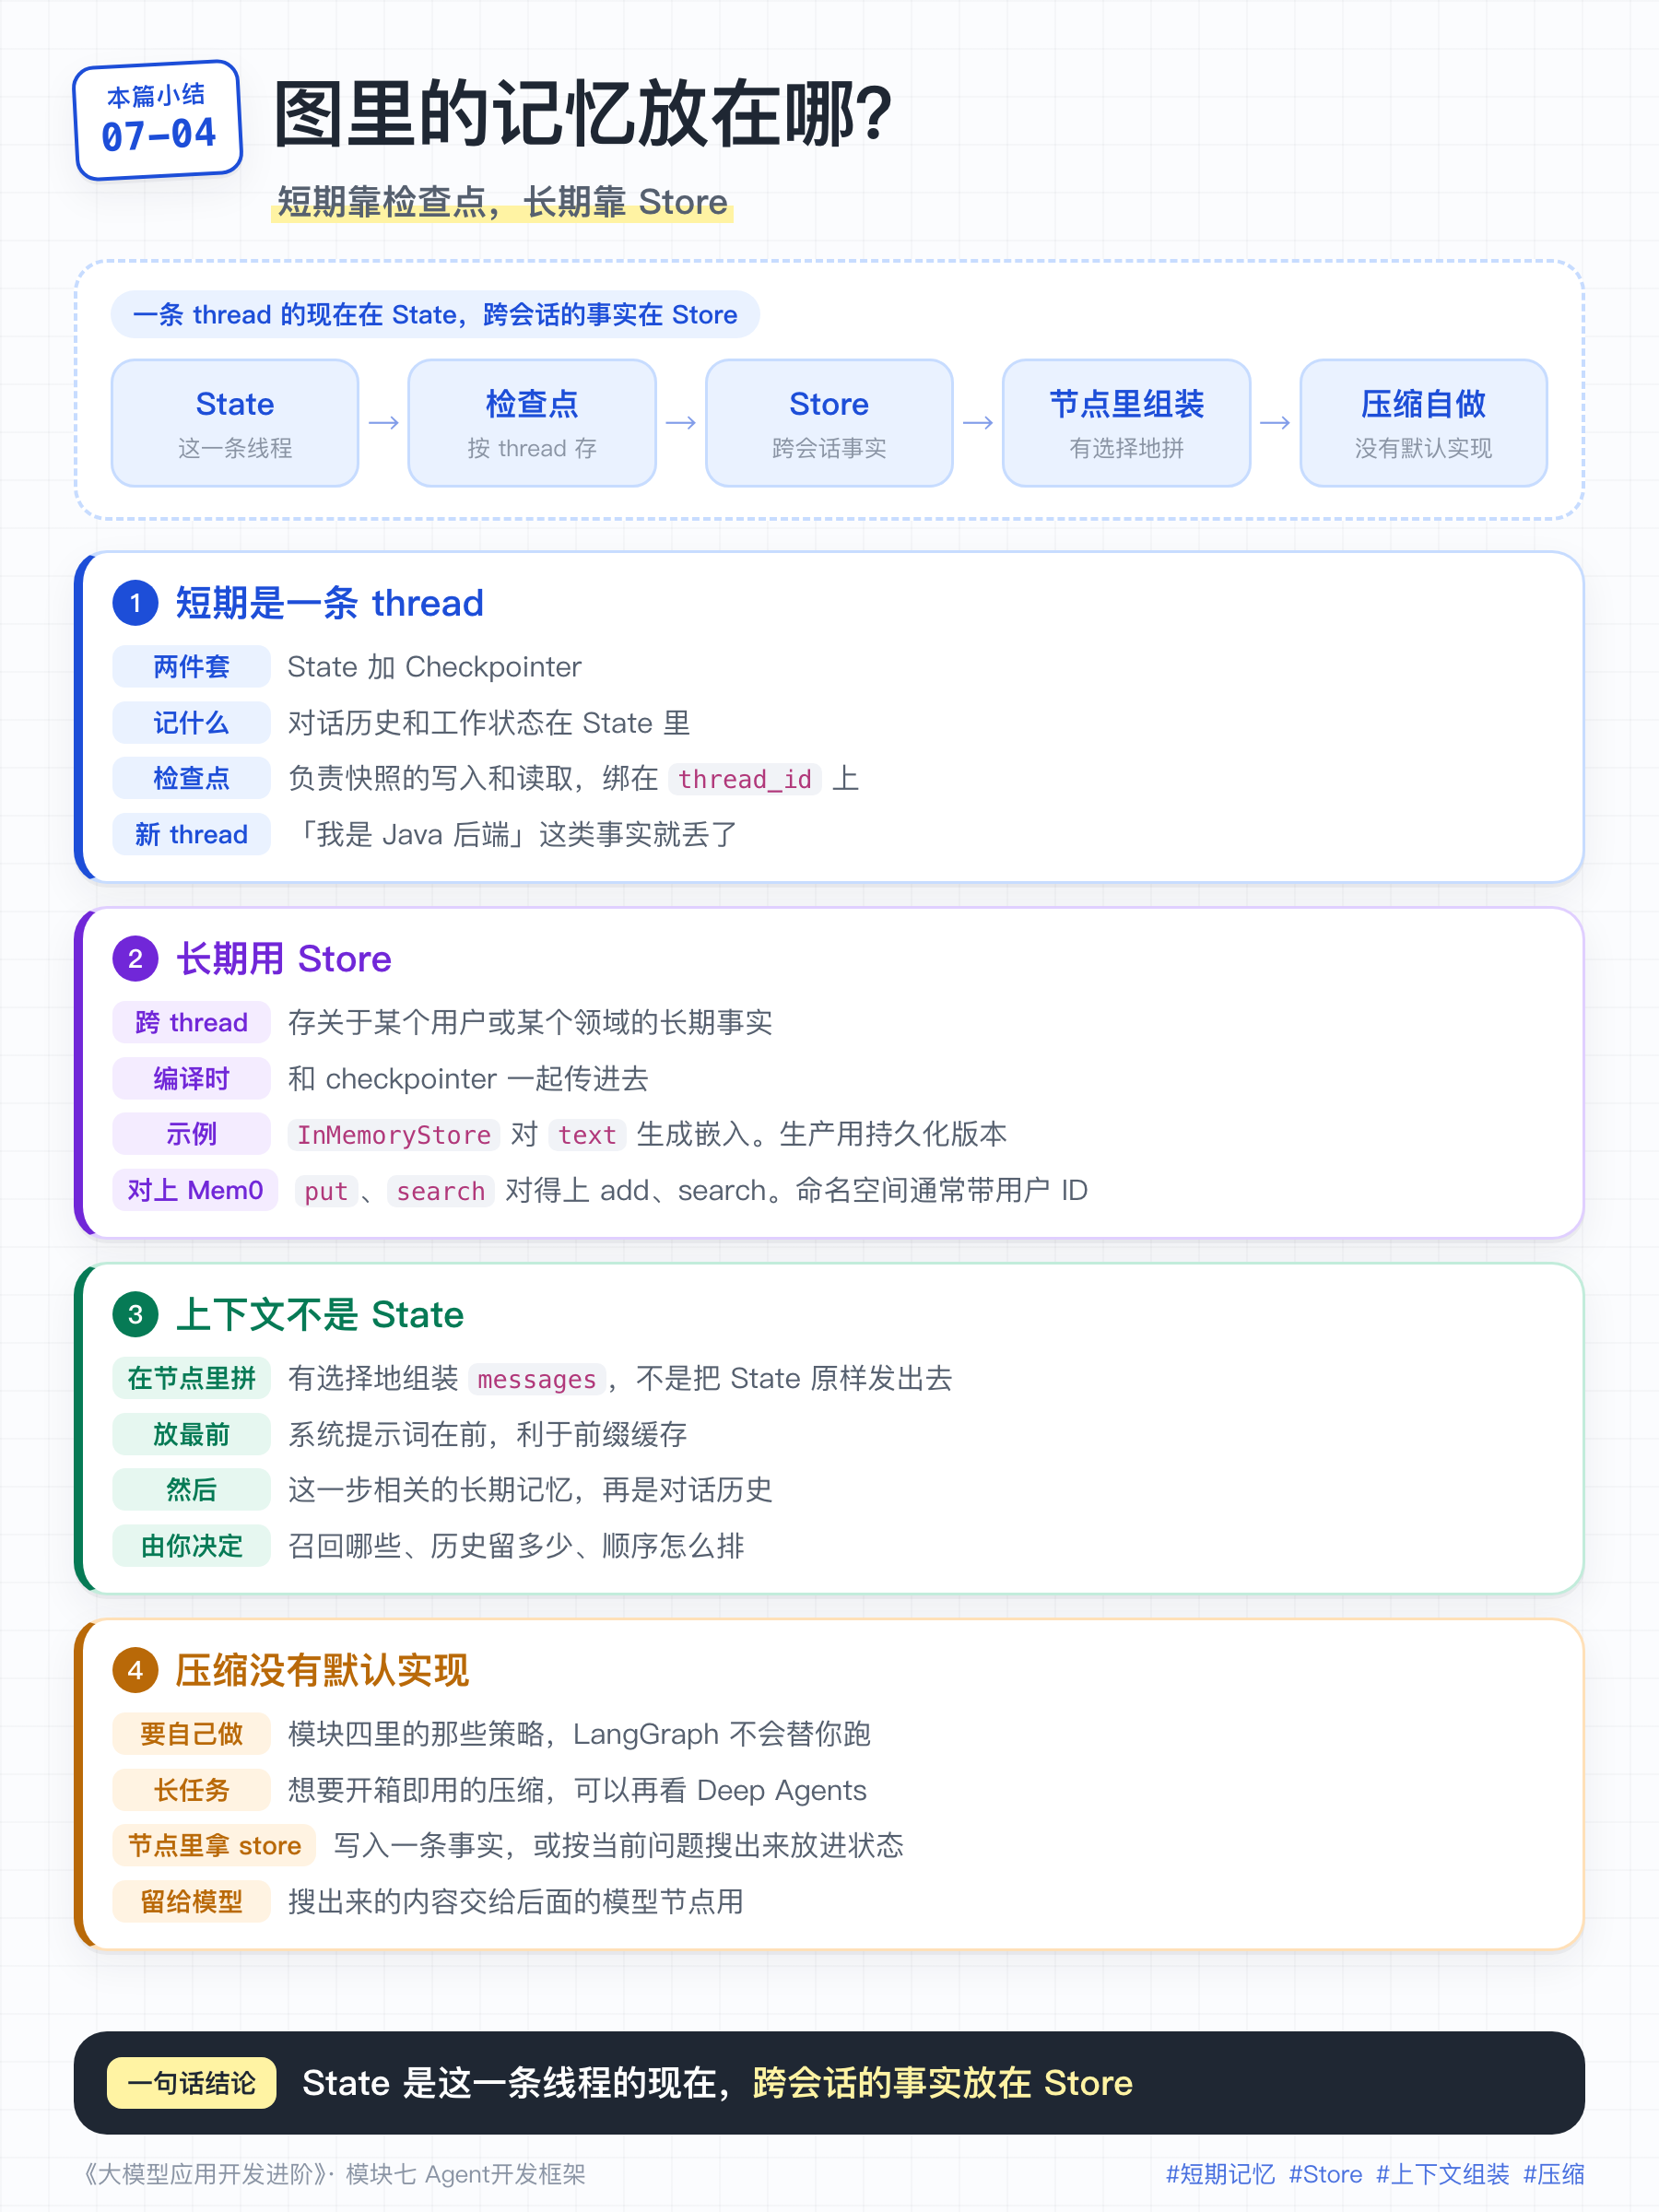
模块三中提到的分层记忆包含短期记忆和长期记忆。LangGraph 使用两套不同的机制来实现。
短期记忆,就是前两篇已经讲过的 State 加 Checkpointer。 它的作用范围是「一条 thread 之内」:同一个 thread_id 里的对话历史和工作状态用State记录,并由 checkpointer 负责维护 State 快照的写入和读取。
但这里有个问题:短期记忆是绑定在 thread 上的。用户这次会话里告诉你「我是 Java 后端、习惯用 Spring」,等他下次开一条新 thread 来,这条信息就丢了,因为它在上一条 thread 的 State 里。
跨会话还要记住的事实,是长期记忆,LangGraph 用一个独立的组件来存,叫 Store。 Store 跨 thread 存「关于某个用户或某个领域的长期事实」。
from langgraph.checkpoint.memory import MemorySaver
from langgraph.store.memory import InMemoryStore

checkpointer = MemorySaver()   # 短期:按 thread 存状态
store = InMemoryStore( # 长期:跨 thread 存事实(生产用持久化版本)
    index={
        "dims": 1536,  # 嵌入向量维度
        "embed": init_embeddings("openai:text-embedding-3-small"),  # 嵌入函数
        "fields": ["text"],  # 对 value 中的 "text" 字段生成嵌入
    }
)

graph = builder.compile(checkpointer=checkpointer, store=store)
Store 的用法,和模块三讲 Mem0 时的 add/search/update/delete 几乎能一一对上。
Store 用「命名空间 + 键」来组织数据。命名空间通常带上用户 ID,用来隔离不同用户的记忆,这和模块三讲记忆要按用户隔离是一个道理。
节点里可以直接拿到 store 来读写。写入一条记忆:
def save_memory_node(state, config, *, store):
    user_id = config["configurable"]["user_id"]
    namespace = (user_id, "memories")       # 按用户隔离的命名空间

    # 对应 Mem0 的 add:存一条跨会话事实
    store.put(namespace, key="tech_stack", value={"text": "用户是 Java 后端,习惯 Spring"})
    return state
要用的时候再搜出来,拼进上下文:
def recall_memory_node(state, config, *, store):
    user_id = config["configurable"]["user_id"]
    namespace = (user_id, "memories")

    # 对应 Mem0 的 search:按当前问题召回相关记忆
    query = state["messages"][-1].content
    memories = store.search(namespace, query=query, limit=5)

    # 把召回的记忆拼成一段,交给后面的模型节点(这就进入了上下文工程的范畴)
    memory_text = "\n".join(m.value["text"] for m in memories)
    return {"recalled": memory_text}
二、上下文工程
模块四讲的核心是:在有限窗口里,选出这一步该给模型的数据,按合理顺序装配。
回忆模块四给的组装顺序:系统提示词、工具描述、业务规则、会话级预取、对话历史、工作状态、当前用户输入。在 LangGraph 里,这个顺序就是你在节点里拼 messages 的顺序:
def call_model(state, config, *, store):
    # 1. 系统提示词(稳定,放最前,利于前缀缓存——模块四讲过)
    system = {"role": "system", "content": SYSTEM_PROMPT}

    # 2. 会话级预取 / 长期记忆召回(从 Store 来的,这一步相关的才拼进来)
    recalled = state.get("recalled", "")
    memory_block = {"role": "system", "content": f"已知用户信息:\n{recalled}"} if recalled else None

    # 3. 对话历史(可能需要裁剪,见下一节)
    history = state["messages"]

    # 自己决定装配顺序和取舍,再交给模型
    messages = [system] + ([memory_block] if memory_block else []) + history
    response = llm_with_tools.invoke(messages)
return {"messages": [response]}看这段代码,模块四的内容就落地了:上下文不是 State ,而是你有选择地组装出来的。 把哪些召回记忆拼进来、历史留多少、顺序怎么排,全由你来决定。
上下文组装比较简单,我们再来看上下文压缩。
在模块四中,我们讲了很多上下文压缩的策略,LangGraph中都没有默认的实现,全部需要你自己实现。
不过,LangChain团队应该也已经发现上下文压缩这件事,很多Agent都需要,于是,在 Deep Agents 中,针对长任务常见的几条压缩策略做了开箱即用的支持。这里我们就不详细介绍Deep Agents的做法了,感兴趣自己去研究吧。
本篇小结
34-LangGraph实现常用架构模式
最后这篇文章,我们讲如何使用LangGraph实现模块六中讲的四种架构模式:ReAct、Plan-And-Execute、Reflection、Multi-Agent。
一、ReAct
在本模块的是第02篇文章中,我们已经使用LangGraph中的State、Node、Edge、Graph来实现了ReAct。
实际上,如果要实现一个标准的ReAct Agent,我们可以直接使用上层的LangChain的 create_agent,它底层基于LangGraph的create_react_agent。
from langchain.agents import create_agent
from langgraph.checkpoint.memory import InMemorySaver

# 建议显式指定 provider:model 格式
agent = create_agent(
    model="openai:gpt-5.6",
    tools=[get_weather, calculator],
    system_prompt="You are a helpful assistant.",
    checkpointer=checkpointer,
    store=store,
)
当然,如果需要控制一些细节,我们还是乖乖的基于LangGraph那套State、Node、Edge、Graph来实现ReAct。
二、Plan-And-Execute
除了ReAct,对于剩下的三种架构模式,LangGraph并没有提供一行代码就搞定的方式。
对于Plan-And-Execute、Reflection、Multi-Agent,我们还得用LangGraph的那套State、Node、Edge、Graph来实现。
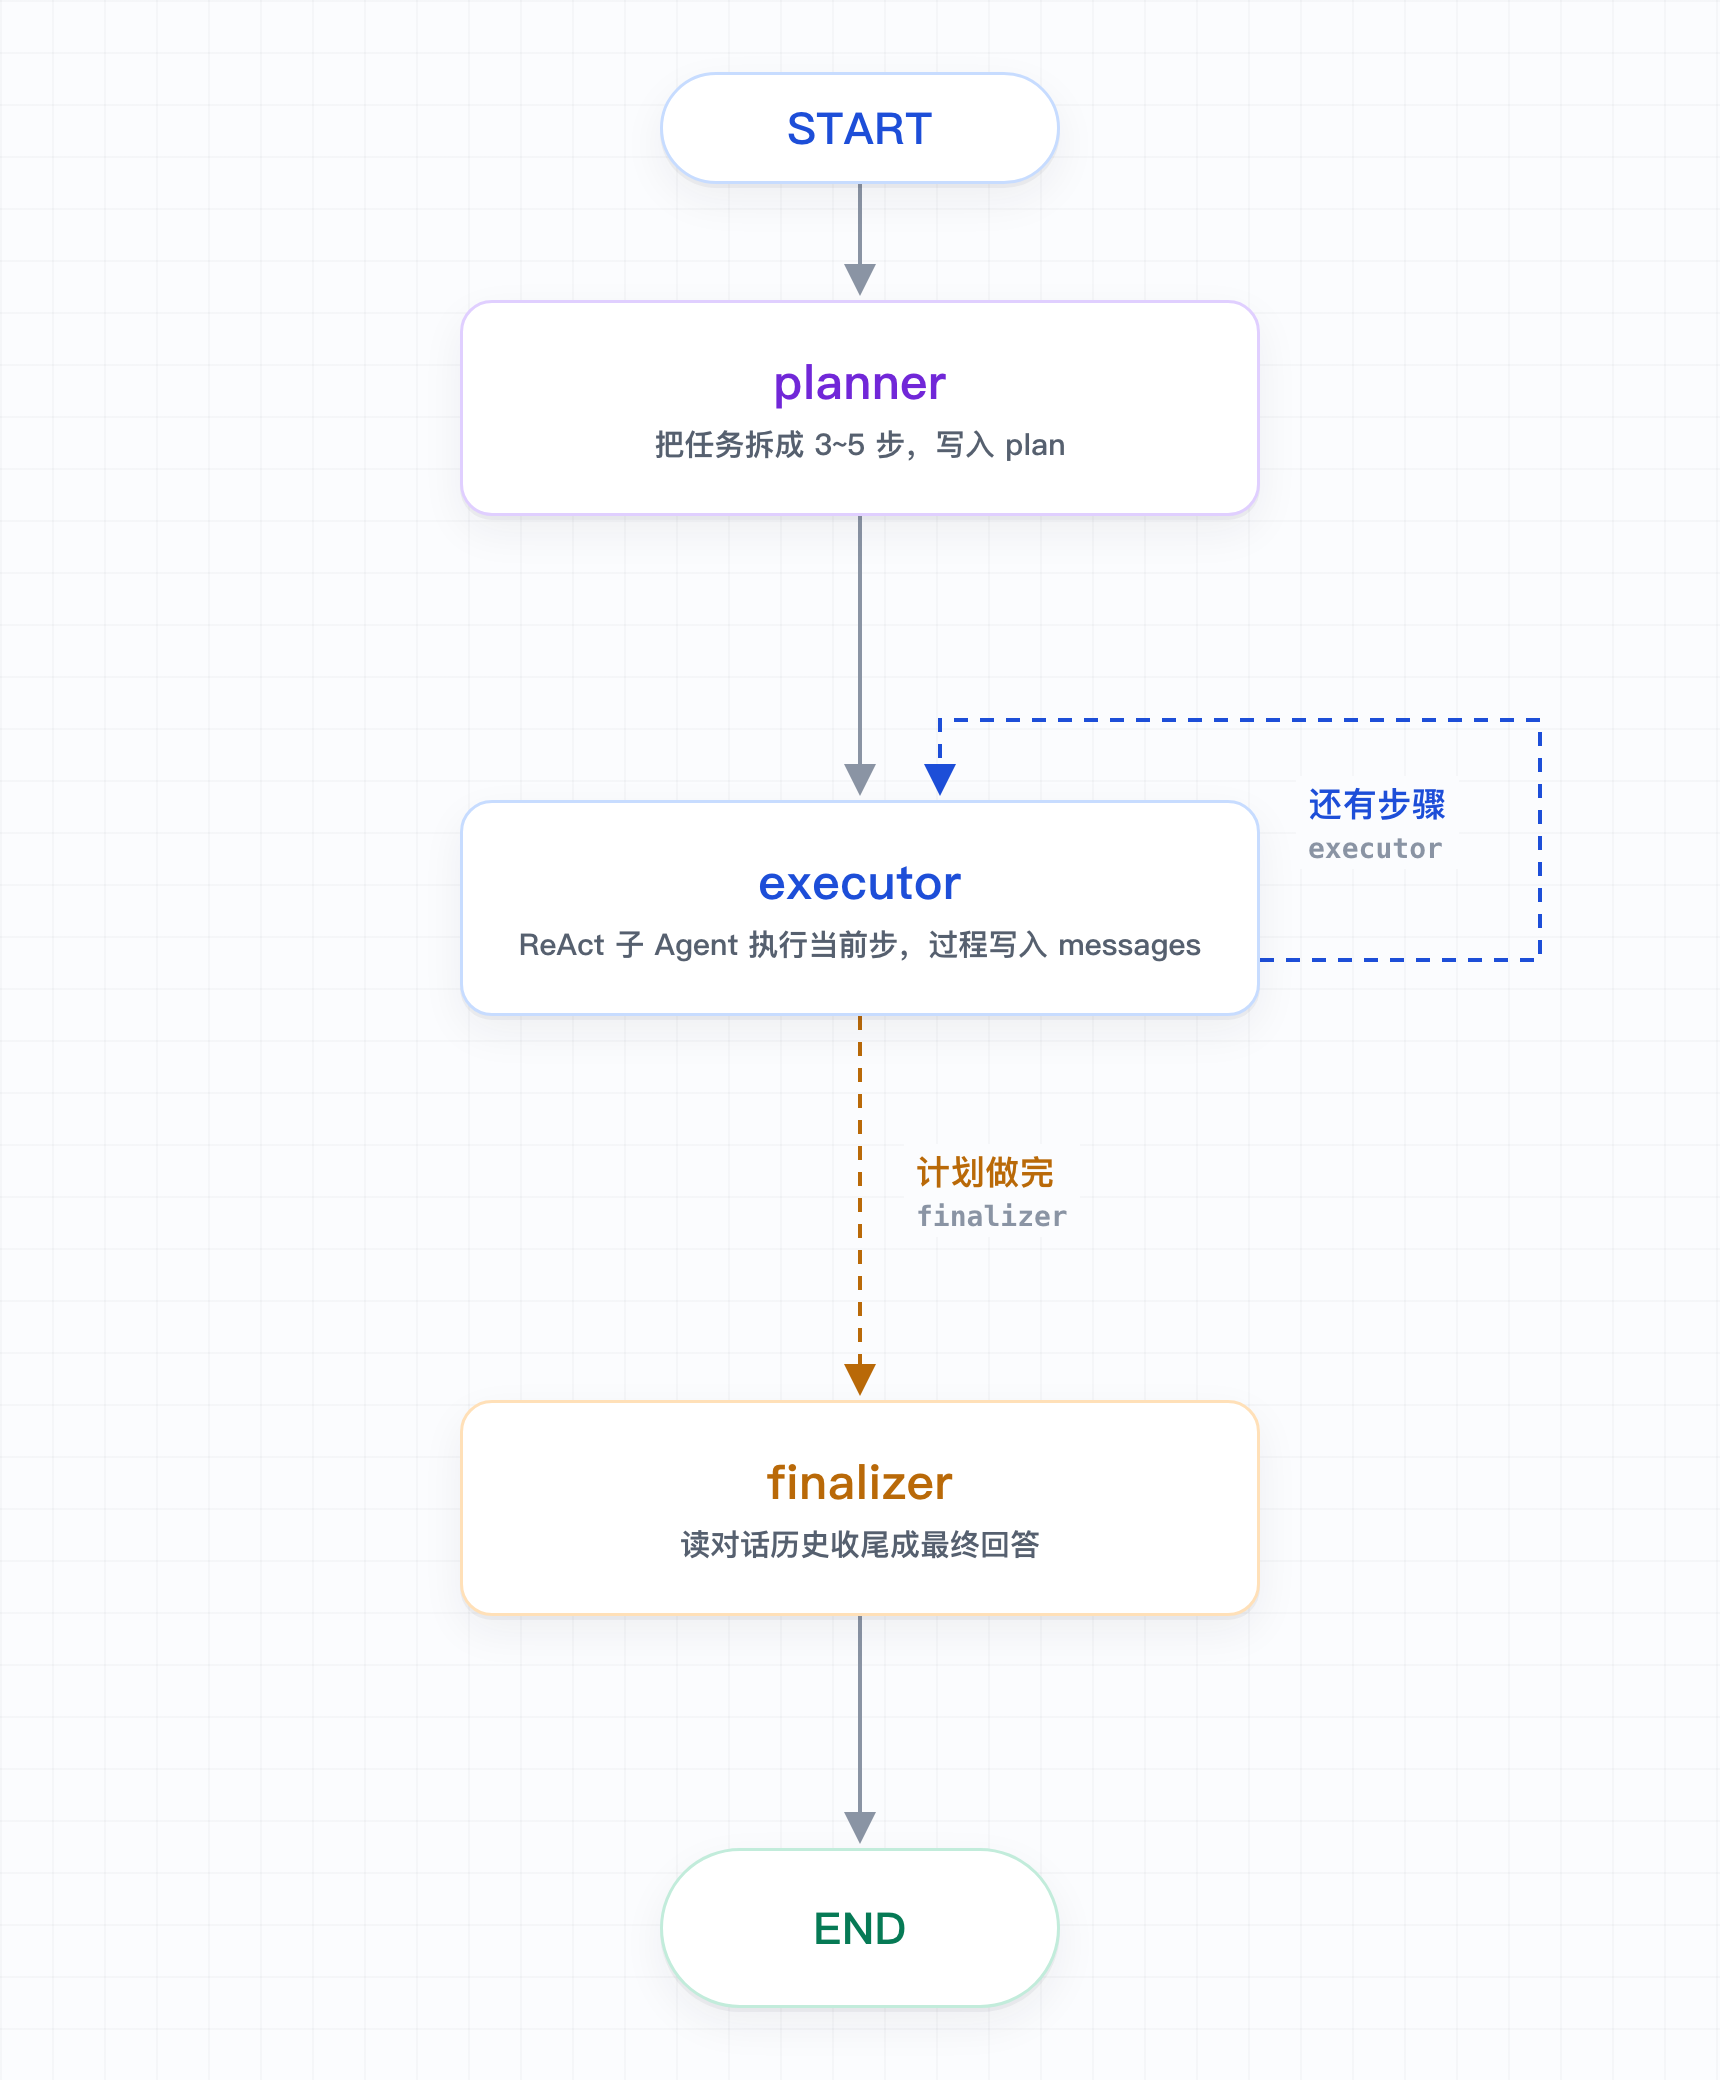
我们先来看Plan-And-Execute如何实现。
Step1: 定义State
from typing import Annotated, List
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class PlanExecuteState(TypedDict):
    messages: Annotated[list, add_messages]
    task: str
    plan: List[str]
    current_step: int
Step2: 创建节点
import json
import re
from langchain_core.messages import HumanMessage
from langchain_core.tools import tool
from langgraph.prebuilt import create_react_agent

def planner(state: PlanExecuteState) -> dict:
    prompt = f"Break into 3-5 steps (JSON array): {state['task']}"
    response = llm.invoke([HumanMessage(content=prompt)])

    # Parse JSON
    try:
        plan = json.loads(re.search(r'\[.*?\]', response.content, re.DOTALL).group())
    except:
        plan = [response.content]

    return {"plan": plan, "current_step": 0}

# executor 内部是一个自带 ReAct 循环的子 Agent:
# 执行每一步可能要查资料、调工具、多轮推理,而不是一问一答就结束。
@tool
def search_web(query: str) -> str:
    """搜索网页获取执行某一步所需的信息。"""
    return f"关于「{query}」的检索结果:……(此处为示例返回)"

execution_agent = create_react_agent(
    llm,
    tools=[search_web],
    prompt="你是执行器,负责把交给你的这一个步骤真正做完。可以调用工具,必要时多轮推理,最后给出该步骤的执行结果。"
)

def executor(state: PlanExecuteState) -> dict:
    if state["current_step"] >= len(state["plan"]):
        return {}

    step = state["plan"][state["current_step"]]

    # 把 state 里除 messages 外的「工作状态」组装成一段上下文:
    # 总任务、完整计划、当前进行到第几步。
    # 前面各步的执行过程和结论不用在这里重复——它们已经在对话历史 messages 里了。
    plan_text = "\n".join(
        f"{i + 1}. {p}" + ("  ← 当前步" if i == state["current_step"] else "")
        for i, p in enumerate(state["plan"])
    )
    working_state = (
        f"总任务:{state['task']}\n"
        f"完整计划:\n{plan_text}\n"
        f"当前要执行第 {state['current_step'] + 1} 步:{step}\n"
        f"(前面各步的执行过程与结论见上方对话历史)"
    )

    # 上下文组装三段式:系统提示词(在 create_react_agent 的 prompt 里)
    #   -> 对话历史 state["messages"] -> 工作状态 working_state
    agent_result = execution_agent.invoke(
        {"messages": state["messages"] + [HumanMessage(content=working_state)]}
    )
    return {
        # 把这一步的执行过程追加进共享 messages(add_messages 会按消息 ID 自动去重)
        "messages": agent_result["messages"],
        "current_step": state["current_step"] + 1
    }

def finalizer(state: PlanExecuteState) -> dict:
    # 直接基于对话历史做收尾:所有步骤的过程和结论都在 messages 里
    prompt = f"根据上面的执行过程,为「{state['task']}」给出最终完整回答。"
    response = llm.invoke(state["messages"] + [HumanMessage(content=prompt)])

    # 最终回答也追加进 messages,不再单独开 response 字段
    return {"messages": [response]}
Step4:定义条件函数
def should_continue(state: PlanExecuteState) -> str:
    if state["current_step"] < len(state["plan"]):
        return "executor"  # More steps
    return "finalizer"     # All done
Step5: 构建Graph
from langgraph.graph import StateGraph, START, END

workflow = StateGraph(PlanExecuteState)

workflow.add_node("planner", planner)
workflow.add_node("executor", executor)
workflow.add_node("finalizer", finalizer)

workflow.add_edge(START, "planner")
workflow.add_edge("planner", "executor")
workflow.add_conditional_edges(
    "executor",
    should_continue,
    {"executor": "executor", "finalizer": "finalizer"}
)
workflow.add_edge("finalizer", END)

graph = workflow.compile()
Step6: 运行Plan-And-Excute
result = graph.invoke({
    "task": "Explain 3 benefits of Python",
    "messages": [],
    "plan": [],
    "current_step": 0,
})

print(result["messages"][-1].content)
三、Reflection
我们再来看Reflection架构模式。
在模块6中,我们将Reflection的时候,定义了三个角色:生成器、评估器、修改器,这里我们简化一下,把生成器和修改器合并在了一起。
GENERATOR_PROMPT = """You are a skilled writer.
If this is the first draft, write a complete response.
If you have critique, revise your draft to address the feedback."""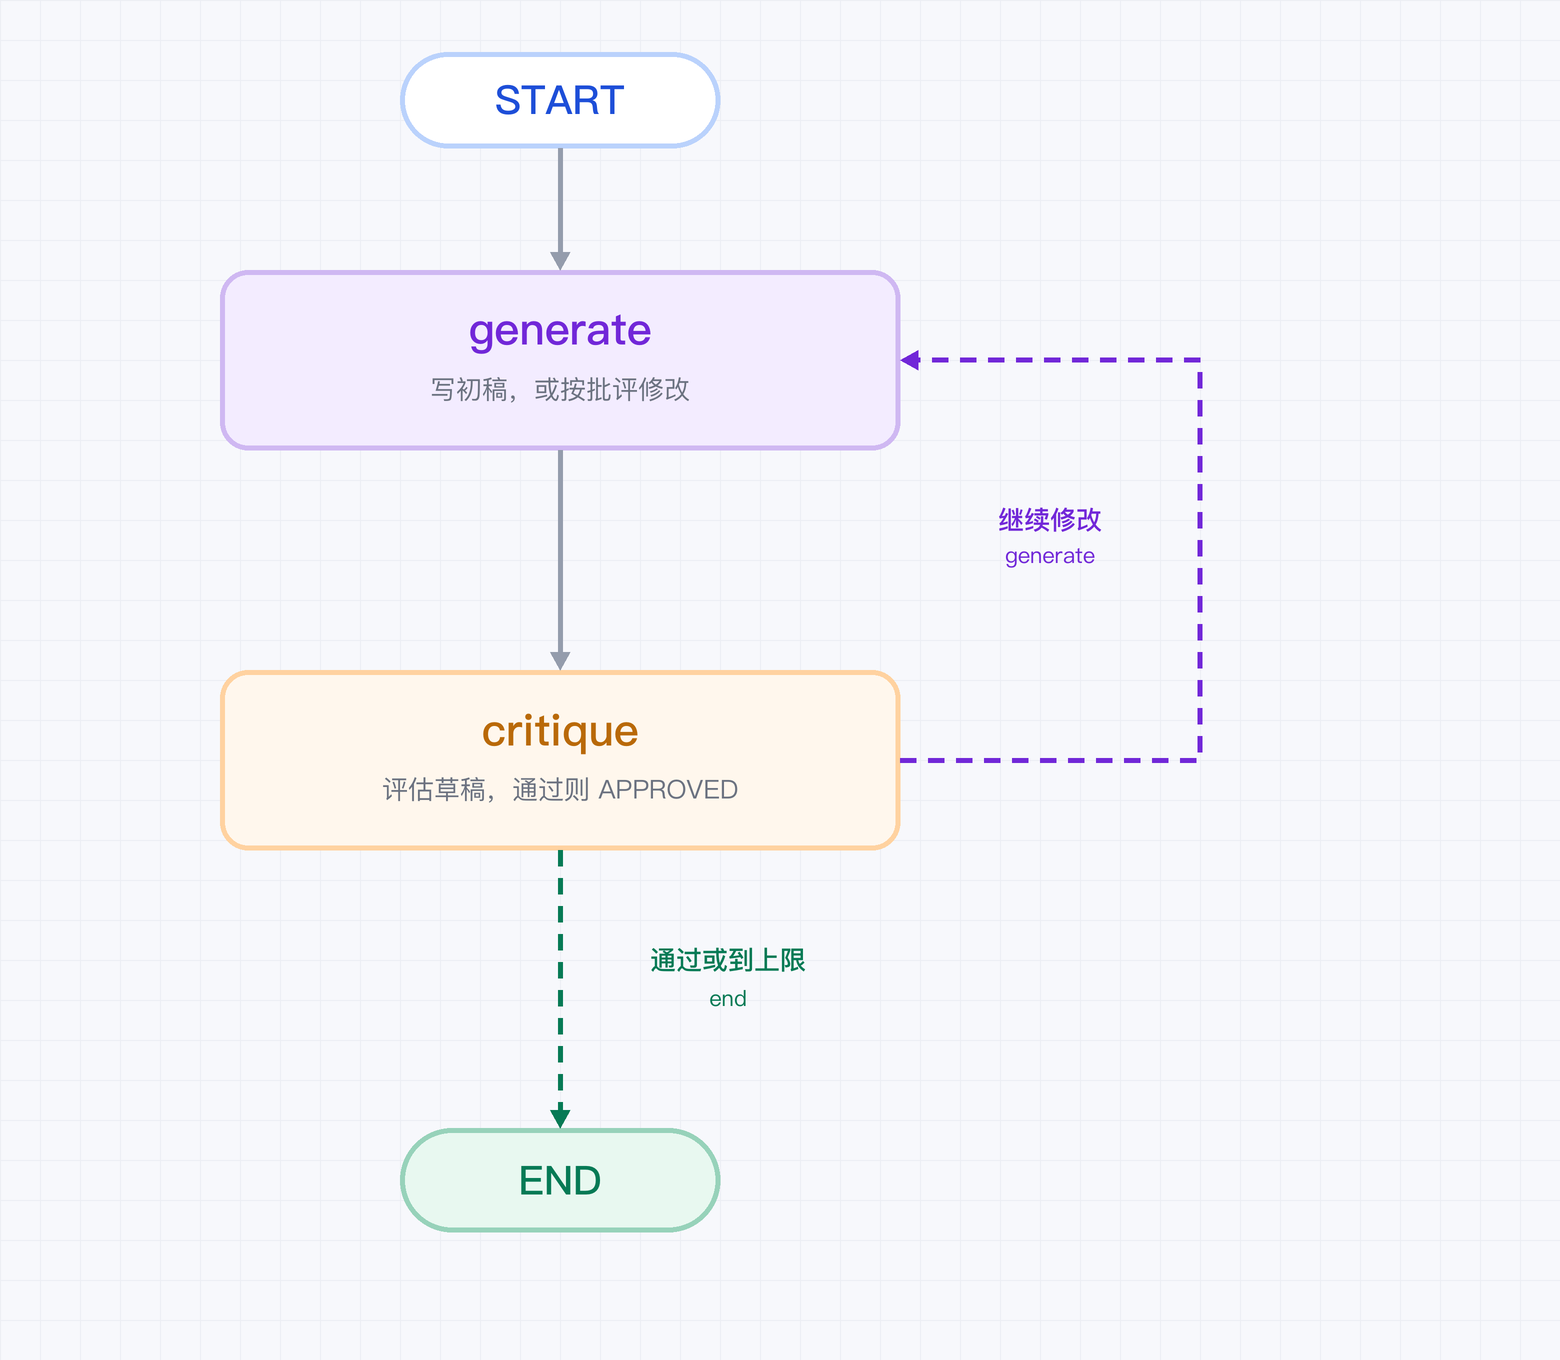
Step 1: 定义 State
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class ReflectionState(TypedDict):
    messages: Annotated[list, add_messages]
    task: str
    draft: str
    critique: str
    iteration: int
Step 2: 创建 Generator Node
from langchain_core.messages import HumanMessage, SystemMessage

GENERATOR_PROMPT = """You are a skilled writer.
If this is the first draft, write a complete response.
If you have critique, revise your draft to address the feedback."""

def generate_node(state: ReflectionState) -> dict:
    iteration = state.get("iteration", 0)

    if iteration == 0:
        prompt = f"Write a response: {state['task']}"
    else:
        prompt = f"Revise based on critique:\nDraft: {state['draft']}\nCritique: {state['critique']}"

    response = llm.invoke([
        SystemMessage(content=GENERATOR_PROMPT),
        HumanMessage(content=prompt)
    ])

    return {
        "draft": response.content,
        "iteration": iteration + 1
    }
Step 3: 创建 Critique Node
CRITIQUE_PROMPT = """You are a thoughtful editor.
If the draft is excellent, respond with exactly: "APPROVED"
Otherwise, provide specific feedback for improvement."""

def critique_node(state: ReflectionState) -> dict:
    prompt = f"Critique this draft:\n{state['draft']}"

    response = llm.invoke([
        SystemMessage(content=CRITIQUE_PROMPT),
        HumanMessage(content=prompt)
    ])

    return {"critique": response.content}
Step 4: 定义条件函数
MAX_ITERATIONS = 3

def should_continue(state: ReflectionState) -> str:
    if "APPROVED" in state.get("critique", "").upper():
        return "end"
    if state["iteration"] >= MAX_ITERATIONS:
        return "end"
    return "generate"
Step 5: 构建 Graph
from langgraph.graph import StateGraph, START, END

workflow = StateGraph(ReflectionState)

workflow.add_node("generate", generate_node)
workflow.add_node("critique", critique_node)

workflow.add_edge(START, "generate")
workflow.add_edge("generate", "critique")
workflow.add_conditional_edges(
    "critique",
    should_continue,
    {"generate": "generate", "end": END}
)

graph = workflow.compile()
Step 6: 运行 Reflection
result = graph.invoke({
    "task": "Explain LangGraph in 2 sentences.",
    "messages": [],
    "draft": "",
    "critique": "",
    "iteration": 0
})

print(result["draft"])  # Final, refined output
四、Multi-Agent
我们现在来看Multi-Agent如何使用LangGraph来实现。
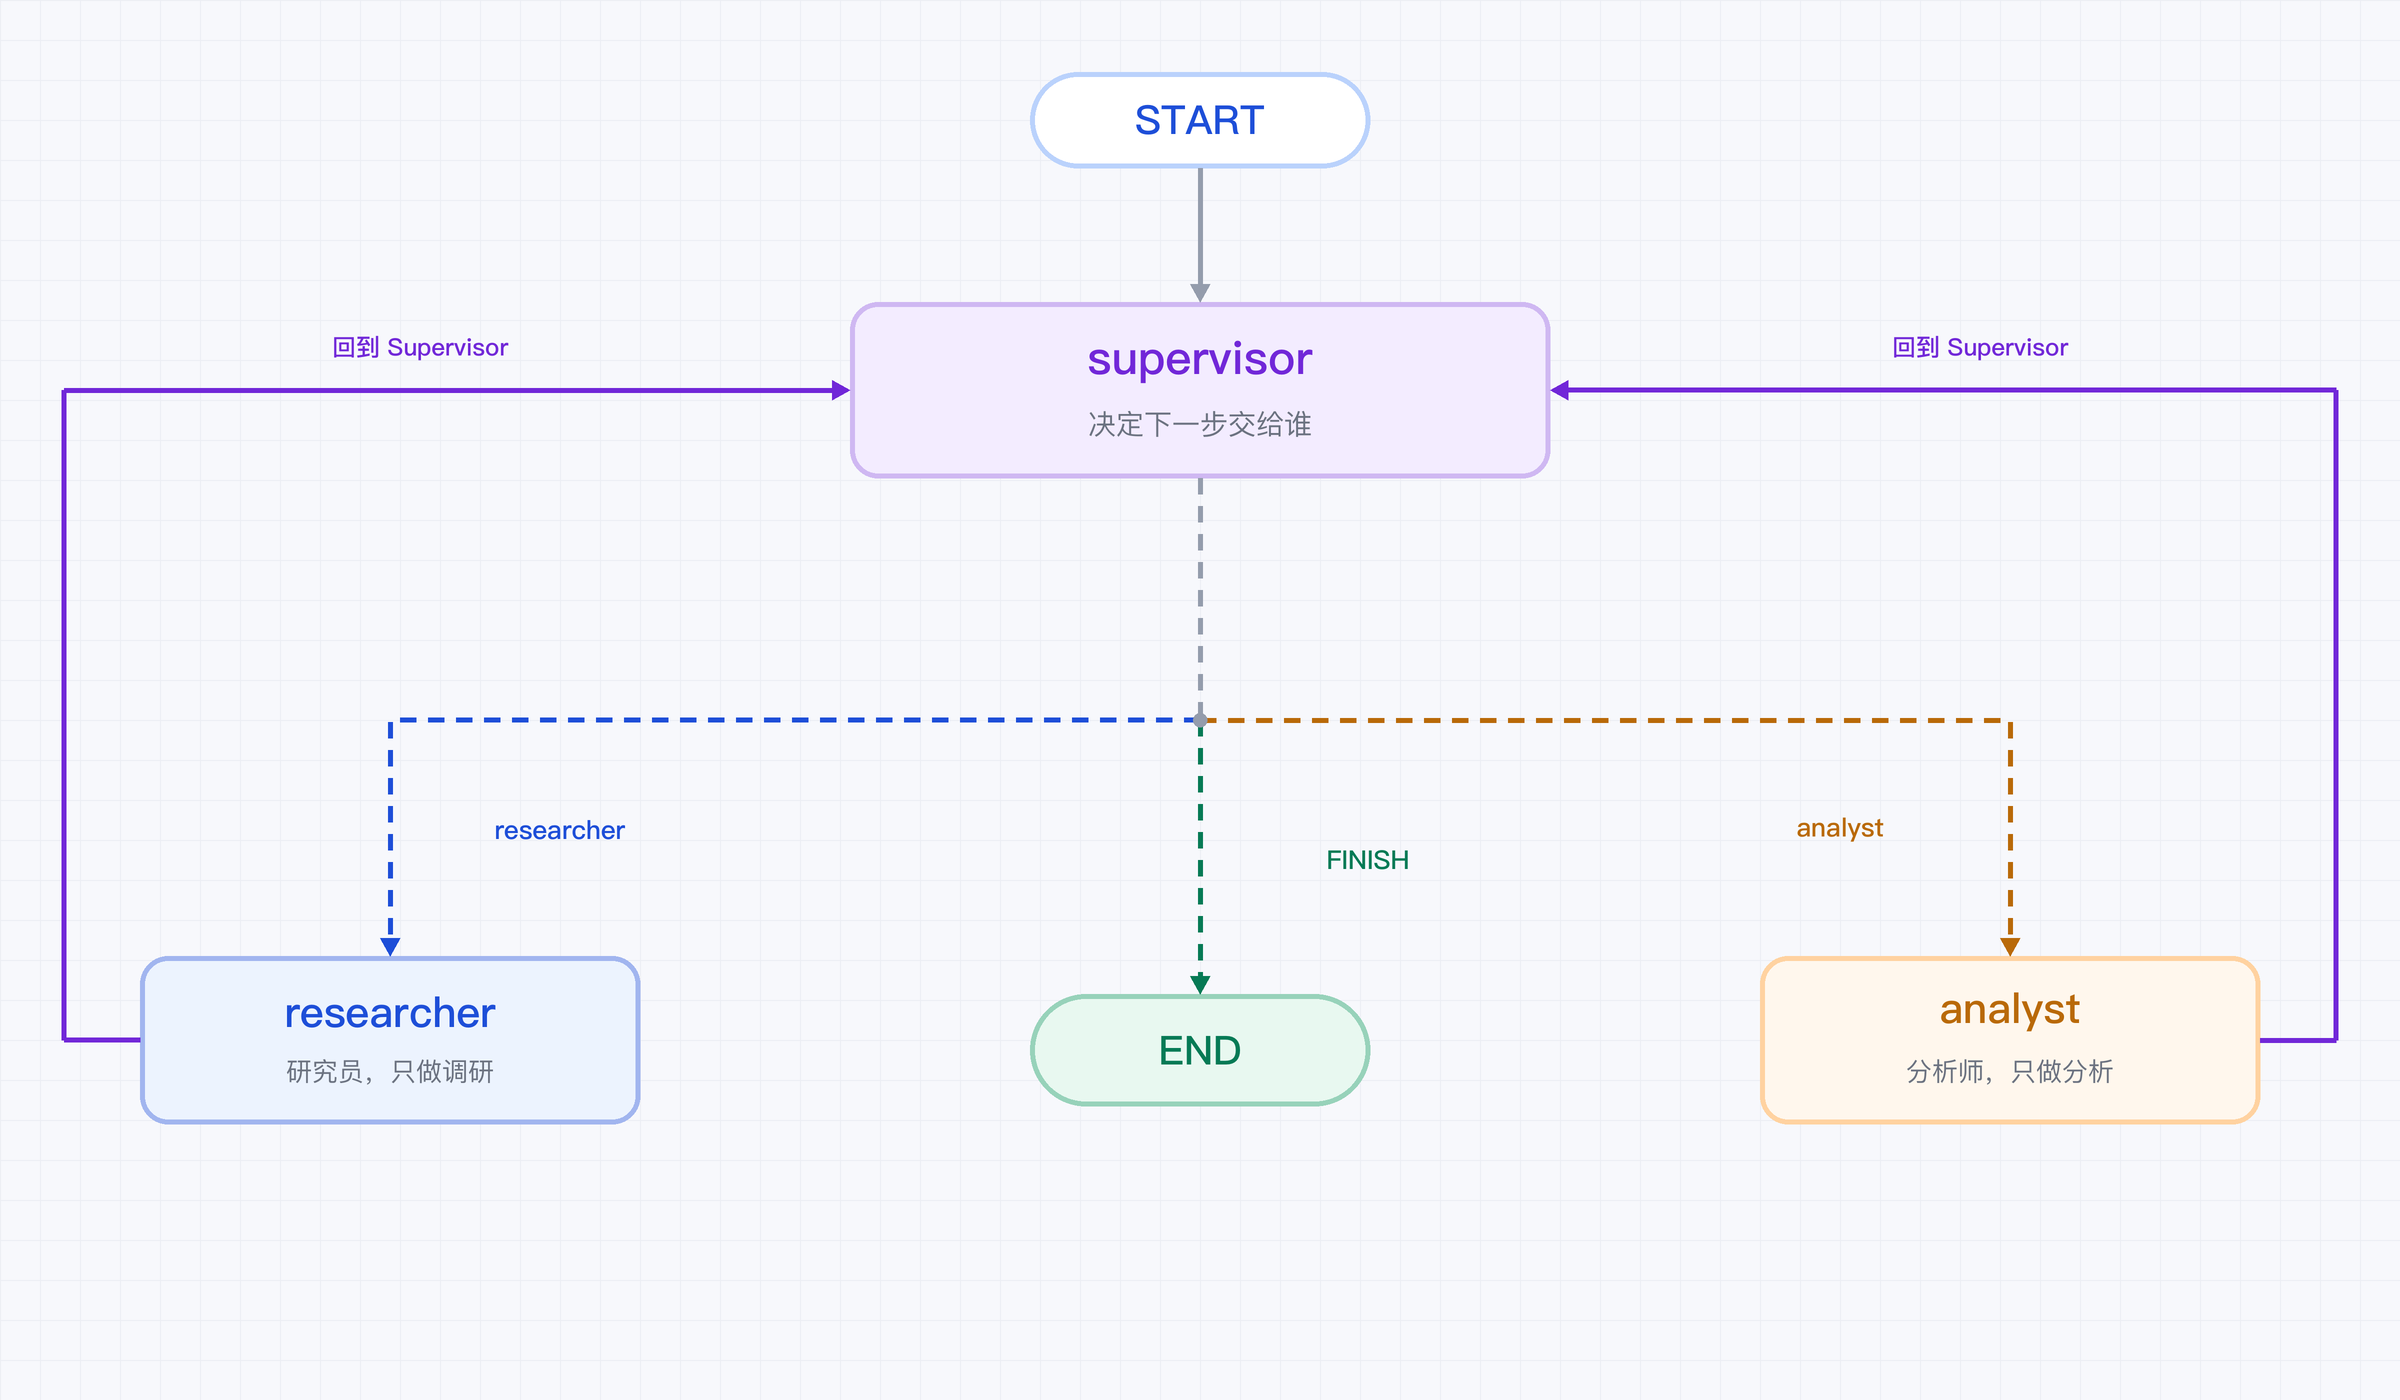
在模块六中,我们讲过 Multi-Agent 有 Supervisor、Handoff、Ensemble 三种拓扑,其中最常用的是 Supervisor(主 Agent 拆任务、分派、汇总,子 Agent 之间不直接对话)。这里我们就用 LangGraph 把那个「研究员 + 分析师」的 Supervisor 例子实现一遍。
核心对应关系要先记住:对主 Agent 来说,一个子 Agent 就是图里的一个节点,而这个节点内部自己带了一个完整的 ReAct 循环和一块独立的上下文。 所以在 LangGraph 里,每个 Worker 我们直接用 create_react_agent 做成一个自带循环的子 Agent,再把它包成 Supervisor 图上的一个节点。
Step 1: 定义 State
Supervisor 结构里,除了共享的 messages,还需要一个字段来记录「Supervisor 决定下一步交给谁」。
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class MultiAgentState(TypedDict):
    # 所有 Agent 共享的对话轨迹,worker 的结论也追加到这里
    messages: Annotated[list, add_messages]
    # Supervisor 的分派结果:下一个该由谁处理,或 FINISH
    next: str
Step 2: 创建 Worker(子 Agent)
每个 Worker 都是一个独立的子 Agent:有自己的角色、自己的工具、自己的上下文循环。我们用 create_react_agent 直接把它们建出来。
from langchain.chat_models import init_chat_model
from langchain_core.tools import tool
from langgraph.prebuilt import create_react_agent

llm = init_chat_model("gpt-5.6", model_provider="openai")

@tool
def search_web(query: str) -> str:
    """搜索网页获取产品信息。"""
    return f"关于「{query}」的搜索结果:该产品在2026年市场份额23%,同比增长15%。"

@tool
def analyze_data(data: str) -> str:
    """对数据进行分析并给出结论。"""
    return f"分析结论:{data} 数据显示增长势头良好,建议加大投入。"

# 研究员子 Agent:只挂搜索工具
researcher_agent = create_react_agent(
    llm, tools=[search_web],
    prompt="你是研究员,负责搜集产品信息和市场数据。只做调研,不做分析。"
)

# 分析师子 Agent:只挂分析工具
analyst_agent = create_react_agent(
    llm, tools=[analyze_data],
    prompt="你是分析师,负责基于已有资料做分析并给出结论。"
)
注意两个子 Agent 挂的是不同的工具,这正是模块六讲的「按职能拆分工具集」:研究员只会搜索,分析师只会分析,各自工具集更小,选错的概率更低。
Step 3: 把子 Agent 包成节点
子 Agent 在自己的窗口里可能跑了好几轮工具调用,产生一堆中间过程。但我们只把它最后那条结论回传到共享 messages 里,中间过程留在子 Agent 内部——这就是上下文隔离。
from langchain_core.messages import HumanMessage

def researcher_node(state: MultiAgentState) -> dict:
    # 子 Agent 内部自己跑完完整 ReAct 循环
    result = researcher_agent.invoke({"messages": state["messages"]})
    # 只把干净的结论回传,用 name 标明这是谁的产出
    return {"messages": [HumanMessage(content=result["messages"][-1].content, name="researcher")]}

def analyst_node(state: MultiAgentState) -> dict:
    result = analyst_agent.invoke({"messages": state["messages"]})
    return {"messages": [HumanMessage(content=result["messages"][-1].content, name="analyst")]}
Step 4: 创建 Supervisor 节点
Supervisor 负责看当前进展、决定下一步交给谁,任务完成就返回 FINISH。为了让它的输出可以被程序化路由,我们用结构化输出把它约束成固定的几个选项。
from typing import Literal
from pydantic import BaseModel
from langchain_core.messages import SystemMessage

members = ["researcher", "analyst"]

class Route(BaseModel):
    """Supervisor 的分派决定。"""
    next: Literal["researcher", "analyst", "FINISH"]

SUPERVISOR_PROMPT = f"""你是一个任务调度器,管理以下 Worker:{members}。
根据对话进展,决定下一步应该由谁来处理:
- 还没有调研资料,就交给 researcher;
- 已经有资料但还没分析,就交给 analyst;
- 分析已经完成、足以回答用户,就返回 FINISH。
每次只指派一个 Worker。"""

def supervisor_node(state: MultiAgentState) -> dict:
    messages = [SystemMessage(content=SUPERVISOR_PROMPT)] + state["messages"]
    response = llm.with_structured_output(Route).invoke(messages)
    return {"next": response.next}
Step 5: 定义路由函数
def route(state: MultiAgentState) -> str:
    # 直接把 Supervisor 写进 state 的 next 作为路由标签
    return state["next"]
Step 6: 构建 Graph
关键在于:每个 Worker 做完都回到 Supervisor,由 Supervisor 再决定下一步。这样就形成了「Supervisor 分派 → Worker 执行 → 回到 Supervisor」的中心化循环。
from langgraph.graph import StateGraph, START, END

builder = StateGraph(MultiAgentState)

builder.add_node("supervisor", supervisor_node)
builder.add_node("researcher", researcher_node)
builder.add_node("analyst", analyst_node)

# 入口先进 Supervisor
builder.add_edge(START, "supervisor")

# Worker 执行完都回到 Supervisor,交出控制权
builder.add_edge("researcher", "supervisor")
builder.add_edge("analyst", "supervisor")

# Supervisor 按 next 字段分派,FINISH 则结束
builder.add_conditional_edges(
    "supervisor",
    route,
    {"researcher": "researcher", "analyst": "analyst", "FINISH": END},
)

graph = builder.compile()
Step 7: 运行 Multi-Agent
from langchain_core.messages import HumanMessage

result = graph.invoke({
    "messages": [HumanMessage(
        content="分析一下某国产大模型在2026年的市场表现,并给出是否值得投资的建议。"
    )],
    "next": "",
})

# 典型执行轨迹:
# supervisor -> researcher(搜资料)-> supervisor
#            -> analyst(做分析)-> supervisor -> FINISH
print(result["messages"][-1].content)
对照模块六里那段从零手写的 Supervisor 代码,你会发现骨架完全一样:Supervisor 分派、Worker 执行、彼此不直接通信、全部通过中心节点中转。区别只是 LangGraph 把「分派—执行—回到中心」这套控制流用图画了出来,并且顺带把每个 Worker 升级成了自带 ReAct 循环的子 Agent。
本篇小结