02 | 大模型调用
02 | 大模型调用
05-第一次调用大模型
现在可以说是百模大战,但真正有竞争力的也就那么几家。国外三巨头:GPT 系列(OpenAI)、Claude 系列(Anthropic)、Gemini 系列(Google)。国内四小龙:DeepSeek(深度求索)、Qwen(阿里)、GLM(智谱)、Kimi(月之暗面)。
每家的能力都不太一样。这一篇我们把它们放在一起比一比,看看各自擅长什么、做不了什么,以及做技术选型时到底该关注哪几个指标。
先说明一件事:模型迭代极快,下面所有具体型号、参数和价格都核验于 2026 年 8 月 ,来自各家官方文档。等你读到这篇时,型号很可能又换了一轮。所以真正要记住的不是这些数字,而是该看哪些指标,这套方法不会过期。
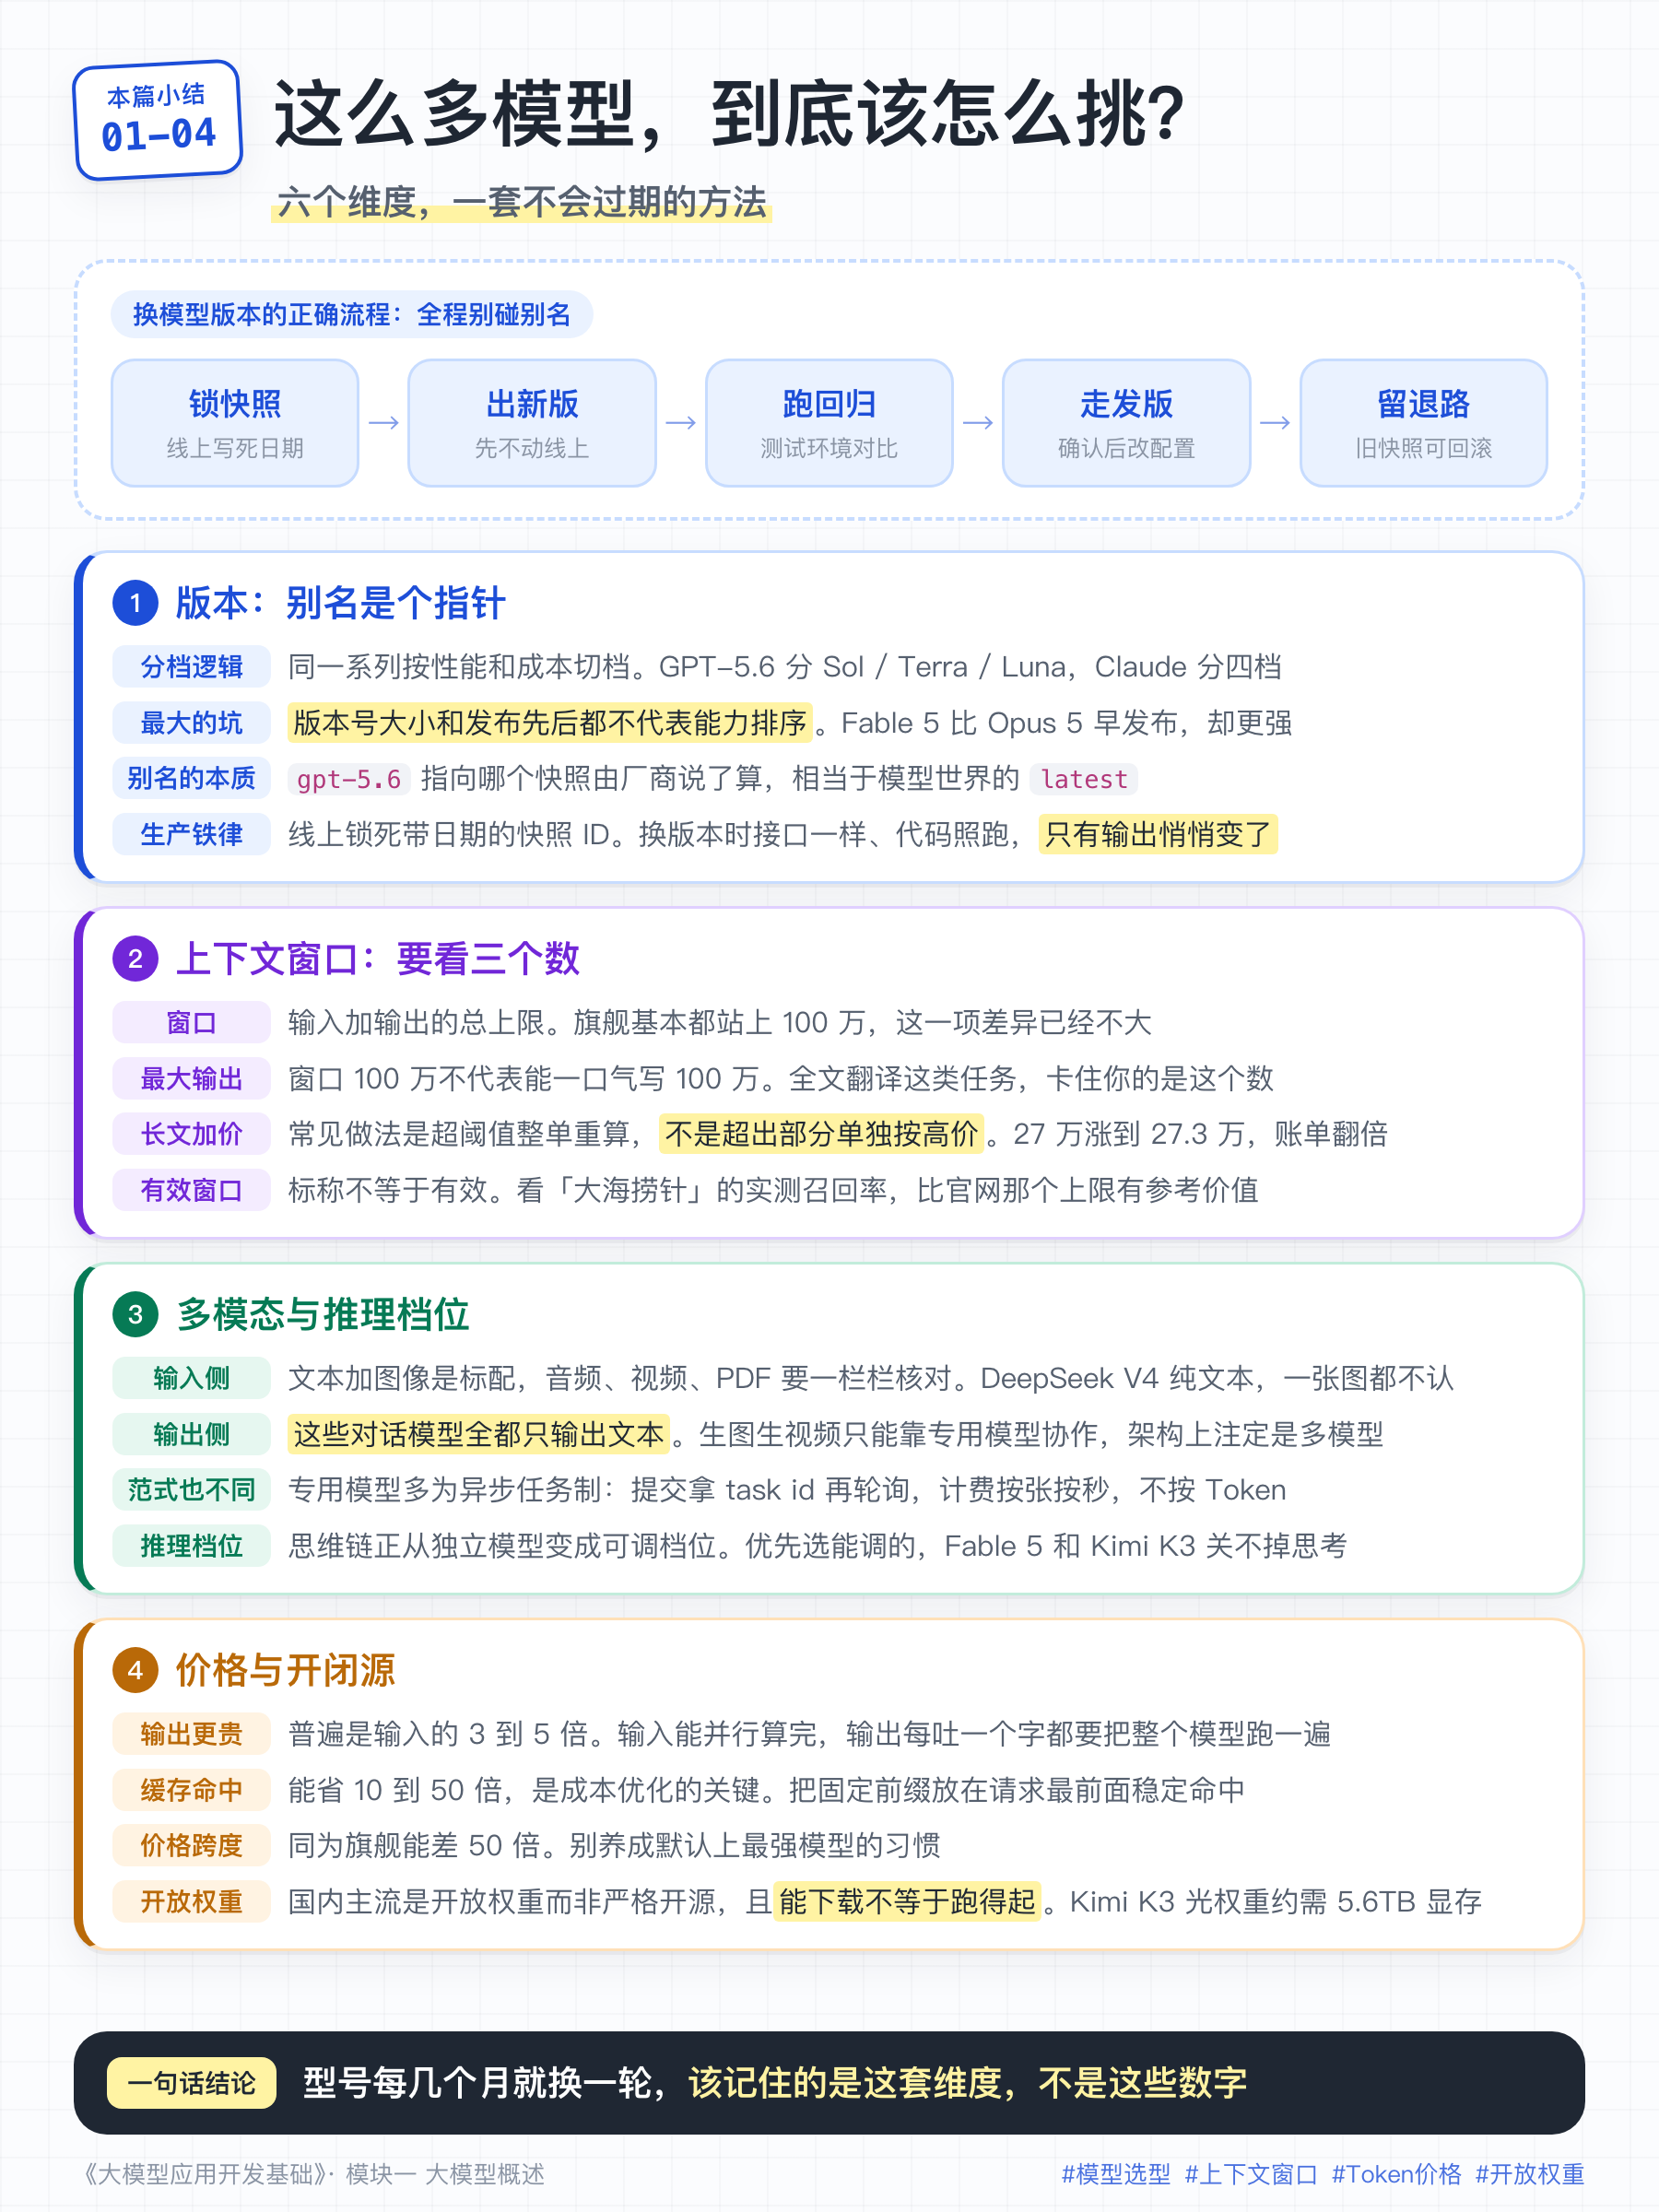
一、大模型版本
同一个系列里,往往同时存在好几个版本。为什么不做一个最强的就好了?
因为用户的需求本来就不一样:有人要极限性能不在乎贵,有人要海量调用必须便宜,有人要低延迟。所以,厂商按不同档位划分出多个版本,分别提供。
以 GPT 系列为例。它的命名经历了几代演变:早期按数字迭代(GPT-1、GPT-2、GPT-3、GPT-3.5),从 GPT-4 开始逐渐复杂化。目前最新的 GPT-5.6 分三档:
- GPT-5.6 Sol(旗舰版):性能最强,主打复杂推理、编程和知识工作这类高难度任务。
- GPT-5.6 Terra(均衡版):兼顾能力与成本,日常任务的标准选择。
- GPT-5.6 Luna(高效版):追求最快速度和最低成本,适合成本敏感或高并发的场景。
Claude 这边分得更细,目前是四档:Fable 5(最强)、Opus 5(Fable 5高性价比平替版)、Sonnet 5(速度与智能的最佳平衡)、Haiku 4.5(最快)。
这里有一个特别值得注意的问题。Fable 5 发布于 2026 年 6 月 9 日,Opus 5 到 7 月才发布,你可能以为「Opus 5 比 Fable 5 新,所以更强」。恰恰相反, Anthropic 官方至今仍把 Fable 5 描述为能力最强的通用模型,Opus 5 只是价格更低的次一档。Haiku 更是还停在 4.5。
所以请记住一条:版本号大小和发布时间先后,都不代表能力排序。 每家的命名逻辑都是自己定的,唯一可靠的办法是去官网的模型页查看:
- OpenAI:
developers.openai.com/api/docs/models - Anthropic:
platform.claude.com/docs/en/about-claude/models/overview
调用模型时,你要在 model 参数里传一个字符串指定用哪个模型。
claude-haiku-4-5-20251001   ← 快照 ID:带日期,永远指向同一个模型版本
claude-opus-5               ← 别名:不带日期,指向哪个快照由厂商决定
gpt-5.6                     ← 别名:当前指向 gpt-5.6-sol
别名(Alias)本质上是个指针。 它自己不是任何一个具体的模型,只是记着「当前该用哪个快照」,而指向哪里由厂商说了算。厂商像软件公司发版一样,在已有的版本上做迭代,然后,不断发布新的版本。他们发布新版本时,会把这个指针指向新快照。
这和你平时管依赖版本是一回事:pom.xml 里写死 1.0.3,还是写 1.0-SNAPSHOT;Docker 里拉 nginx:1.25.3,还是拉 nginx:latest。别名就是模型世界的 latest。
不过,软件版本号承诺向后兼容,模型没有任何这类承诺:软件依赖升级出问题,通常会以编译错误、接口不兼容的形式当场报错;模型换版本却是接口完全一致、参数没有变化、代码照常运行,只有输出发生了改变。
所以生产环境别用别名。你精心调好的提示词、依赖的输出格式,全都建立在某一个具体模型的行为之上。厂商一旦把指针指向新快照,输出就可能改变,即便你的代码一行都没改。
所以,正确的做法是:
- 线上始终锁定某个快照 ID,比如
claude-haiku-4-5-20251001。 - 厂商发布新快照时,先不动线上。
- 在测试环境用新快照跑一遍你的回归用例集,对比输出质量、格式合规率、延迟和成本。
- 确认没问题,再改配置、走发版流程,把
model换成新快照 ID。 - 万一线上有问题,旧快照还在,随时能切回去。
不过写死版本也不是一劳永逸:版本会退役。 各家都会公布退役时间,比如 Anthropic 明确写了 Claude Haiku 4.5 的退役不早于 2026 年 10 月 15 日。所以你还得定期关注这些公告,赶在退役前升级新版本。
二、上下文窗口
上上一篇讲过上下文窗口是什么。这里先回答一个问题:为什么这两年各家都在不断把这个数值往上提升?
因为它是模型的工作记忆上限,能不能一次读完整份合同而不切块(一切块就会丢掉跨块的关联,比如第 5 页的定义和第 200 页的条款相互冲突,分开看永远发现不了)、多轮对话进行到多少轮后开始丢失早期信息、RAG 能放入几段检索结果,都得受上线文窗口大小的限制。
除此之外,Agent应用的发展,也势必要求上下文窗口的提升!Agent 的每一步思考、每一次工具调用、每一份返回的文件内容和命令输出,全都要累积进上下文,几十轮下来轻松几十万 Token。2023 年做的是聊天应用,8K 就够用了;今天做的是 Agent,8K 连一个文件都读不完。
回到选型。其实,光看上下文窗口这一个数不够,我们要关注三个相关的数字
| 模型 | 上下文窗口 | 最大输出 |
|---|---|---|
| GPT-5.6 Sol / Terra | ~105 万 | 12.8 万 |
| Claude Fable 5 / Opus 5 / Sonnet 5 | 100 万 | 12.8 万 |
| Gemini 3.7 Flash | ~105 万 | 6.5 万 |
| DeepSeek V4 | 100 万 | 38.4 万 |
| Qwen3.8-Max / Kimi K3 / GLM-5.3 | 100 万 | 因型号而异 |
第一个数是上下文窗口,也就是输入加输出的总上限。可以看到每个模型的旗舰版本基本都达到 100 万,差异已经不大了。
第二个数是最大输出,这是很多人容易忽略的。上下文窗口 100 万,不代表它能一口气给你输出 100 万 Token 的内容。Claude 和 GPT 的上限是 12.8 万,Gemini 3.7 Flash 和 Haiku 只有 6.4 万左右。比如你要把一份几十万字的产品手册整篇翻译成英文:输入塞进 100 万的窗口绰绰有余,可输出到 12.8 万就被截断了。这类「输出量和输入量差不多」的任务,比如全文翻译、批量改写,卡住你的都是最大输出这个数,只能自己切块、分多次调用再把结果拼起来。
第三个数最容易出错:长上下文要不要加价。 各家做法不一样,大致分三类。
第一类是设一个阈值,超过就整单涨价。 OpenAI 是输入超过 27.2 万 Token,整个请求按 2 倍输入价、1.5 倍输出价计费;
第二类是按输入长度分档。 阿里百炼的 Qwen 系列是典型,以 Qwen3-Max 为例:32K 以内输入 ¥2.5/百万,32K–128K 跳到 ¥4,128K–256K 再跳到 ¥7,输出价同步上浮。
这两类有一个共同的问题:不是「超出的那部分」按高价,而是整个请求都按落入的那一档重算。 你的请求从 27 万 Token 涨到 27.3 万,账单不是多 1%,而是直接翻倍。做长文档处理的应用,一定要留意这一点。
第三类干脆不分档。 DeepSeek V4 和 Kimi K3 都是全长度统一单价,多长都一个价。
还有一件事必须提醒:标称窗口不等于有效窗口。 厂商写 100 万,不代表这 100 万里每个位置的信息它都用得一样好。这就是上上一篇提过的 Lost in the Middle问题,夹在中间的内容最容易被忽略,表现就是明明在提示词写清楚了要求,模型却不按照要求来输出。
业界验证有效长度的办法叫「大海捞针」(needle in a haystack):在超长文本的随机位置藏一句特定的话,再问模型这句话是什么,统计不同长度、不同位置下的召回率。比如 Gemini 3.7 Flash 官方给出的 128K 长度检索准确率是 97.0%,这个数比标称的 105 万更有参考价值。
所以还是那句话:窗口是上限,不是目标。 塞太满不但容易漏信息,钱还多花。
三、多模态支持
假设产品经理提了个需求:做一个售后助手,用户可以拍张照片问「这个零件怎么装」,也可以直接发一段语音描述,最后助手要生成一张标好步骤的安装示意图发回去。
你打开模型官网,看到「原生多模态」四个字,心想这下没问题了。真正动手做时才发现,这个需求里有一半这个模型做不了。
选型时你必须把输入侧和输出侧拆开看,这两边的成熟度根本不在一个层级。
输入侧已经相当好了。文本加图像基本是标配,GPT-5.6 全系、Claude 全系都支持。再往上就开始分化,音频、视频、PDF 得一个个查:Gemini 3.7 Flash 覆盖得最全,文本、图像、音频、视频、PDF 全都能直接处理;国内 Kimi K3 和 Qwen3.8-Max 支持图文视频;而 DeepSeek V4 系列是纯文本,不支持任何图像输入。所以上面那个需求里,「看照片」和「收语音」是能做的,只要模型挑对。
输出侧几乎零支持:前面提到的所有模型,输出全都只有文本。 包括 Gemini 3.7 Flash,它输入能收一整段视频,输出照样只有文字。
也就是说,「生成一张安装示意图」这件事,对话模型根本做不到。生图、生视频、合成语音,靠的从来不是这些模型,而是各领域的专用模型。所以但凡你的应用要产出文本以外的东西,架构上就注定是多个模型协作:对话模型负责理解意图和编排,专用模型负责生成。
专用模型都有哪些?按你要产出的东西分,大致有这几类:
| 要产出什么 | 常见选择 |
|---|---|
| 图像(文生图、图像编辑) | GPT Image 2(OpenAI)、Nano Banana 2 / Pro(Google)、Seedream 5.0(字节即梦)、通义万相(阿里) |
| 视频(文生视频、图生视频) | Veo 3.1(Google)、Sora 2(OpenAI)、可灵 Kling(快手)、Seedance(字节)、Wan(阿里) |
| 语音合成 TTS | ElevenLabs、豆包语音(字节)、CosyVoice(阿里) |
| 语音识别 ASR | Whisper(OpenAI)、Scribe v2(ElevenLabs)、Paraformer(阿里) |
接入这些专用模型,需要注意:它们的调用范式和对话模型不一样。 生成一张图要几秒,生成一段视频动辄几十秒到几分钟,所以这类接口大多是异步任务制:你提交任务拿到一个 task id,再轮询状态或者等回调,而不是像调 chat 接口那样同步等一个响应。计费单位也换了,不再按 Token,而是按张、按秒、按字符算。这意味着你的应用里会同时跑着两套调用范式和两套成本模型,日志、重试、超时、账单统计都得分开做。
四、推理模型
上上一篇讲过思维链是什么。这一节要说的是它在工程上发生的一个变化。
倒回 2024 年,假如你要做一个应用,里面既有「把这段话翻成英文」这种简单任务,也有「分析这份财报找出异常」这种复杂任务。那时候你只能维护两套:简单的走普通模型,复杂的走推理模型(o 系列、DeepSeek-R1)。
厂商显然也觉得这样不方便。于是这两年的主流做法变成了:推理不再是一类单独的模型,而是同一个模型上一个可调的档位。
- GPT-5.6 全系支持
reasoning.effort参数,六个档位:none、low、medium(默认)、high、xhigh、max。 - Claude Sonnet 5 / Opus 5 是自适应思考,同时开放 effort 参数供你调节。
- Gemini 3.7 Flash 提供
LOW、MEDIUM、HIGH三档思考等级。 - DeepSeek V4 支持思考/非思考模式切换。
要注意,这个档位调的不只是效果,更是账单和延迟。因为思考过程本身就是模型吐出来的 Token,通常按输出价计费,而输出价往往是输入价的 5 倍。同一个问题从 low 调到 max,答案可能只好一点点,Token 却能翻好几倍。
也正因为如此,有两个模型得特别留意:Claude Fable 5 的思考是常开的,Kimi K3 同样始终开启,都关不掉。 你要是拿它们去跑「判断这条评论是不是差评」这种又简单又高频的分类任务,它同样会进行一大段思考,最后只给出一个「是」,但那段思考你得照价付钱。
所以这里有条很实在的建议:优先选能调档的模型。 一个模型覆盖简单和复杂两类任务,简单的把 effort 设置为 none 或 low,复杂的再开高档,比维护两套模型省心得多。而这恰恰就是厂商把推理做成档位想帮你解决的问题。
五、Token 价格
很多团队就是这样出问题的:demo 阶段随手挑了个最强的模型,效果不错就直接上线,一个月后收到账单,发现光模型调用就占用了大半预算。
下表单位是每百万 Token(核验于 2026-08,当你看到这篇文章时,价格可能已经有变动了):
| 模型 | 输入 | 缓存命中输入 | 输出 |
|---|---|---|---|
| Claude Fable 5 | $10 | — | $50 |
| Claude Opus 5 | $5 | — | $25 |
| GPT-5.6 Sol | $4 | $0.40 | $20 |
| Claude Sonnet 5 | $2 | — | $10 |
| GPT-5.6 Terra | $2 | $0.20 | $12 |
| Claude Haiku 4.5 | $1 | — | $5 |
| Gemini 3.7 Flash | $0.75 | — | $3.75 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| Kimi K3 | ¥20 | ¥2 | ¥100 |
| Qwen3.8-Max | ~¥14 | ~¥1.75 | ~¥43 |
| DeepSeek V4-Pro | ¥3 | ¥0.025 | ¥6 |
| DeepSeek V4-Flash | ¥1 | ¥0.02 | ¥2 |
从表中,我们发现输出比输入贵得多,多数在 5 倍上下,区间大致在 2 到 6 倍。这不是厂商乱定价,因为成本结构本来就是这样的:输入的那一大段可以一次性并行算完,输出却必须一个 Token 一个 Token 地生成,每吐一个字都要把整个模型完整跑一遍。
从表中,我们还发现一个缓存命中价。 GPT-5.6 Sol 命中 0.40、未命中4,差 10 倍;DeepSeek V4-Flash 差距更大,¥0.02 对 ¥1,差 50 倍。这意味着能不能复用固定前缀,是成本优化的关键:把 System Prompt、少样本示例这些每次都一样的内容固定放在请求最前面,让它们稳定命中缓存,能有效减少成本。
从表中,我们还发现价格跨度也很大。 拿最贵的 Kimi K3(输出 ¥100/百万)和最便宜的 DeepSeek V4-Flash(输出 ¥2/百万)一比,差 50 倍。所以千万别养成「默认上最强模型」的习惯,否则成本会高得离谱。
除此之外,对于有些模型,价格还可能和调用时间有关。DeepSeek 就采用了峰谷计价:北京时间周一到周五的 9:00–12:00 和 14:00–18:00 算高峰,其余时间算空闲,空闲价是高峰价的一半。那些能容忍延迟的离线任务,比如批量数据清洗、跑评测集,放到夜里或周末运行,成本可以直接减半。
六、开源还是闭源
这是个很常见的场景:领导拍板说「客户数据绝对不能出内网,用开源模型自己部署吧,DeepSeek、Kimi 不都开源了吗」。
听着天经地义,当我们真去做时,才发现,这句话里藏着两个误会。
第一个误会:这个「开源」不是你熟悉的那个开源。 国内常说的开源模型,准确讲绝大多数是开放权重(Open Weights)。厂商把训练好的权重文件公开给你下载和商用,所谓权重就是上一篇讲的那几千亿个参数值,但训练数据和完整训练代码通常不公开。换句话说,你拿到的是编译好的成品,而不是源码。
眼下的格局是:国外三巨头全部闭源,GPT、Claude、Gemini 只能调 API;国内主力大多开放权重,DeepSeek V4 系列以 MIT 协议开源,Kimi K3 在 2026 年 7 月开源,Qwen 和 GLM 也都有开放权重版本。
第二个误会更致命:能下载不等于跑得起。 用上上一篇的显存估算算笔账。Kimi K3 总参数 2.8T,光装权重就要约 5.6TB 显存;Qwen3.8-Max 的 2.4T参数 约需 4.8TB显存。这已经不是买两张卡的事,是要搭一个集群,而且还没算 KV Cache 的开销。真想自己部署,实际点的选择是那些参数量适中的小模型。
所以对业务开发者来说,真正要做的决策从来不是「开源还是闭源」,而是在下面三条路里做选型:
- 调厂商 API:最省事,按量付费,零运维,但数据有隐私问题,价格和可用性都受制于人。
- 调第三方托管的开放权重模型:云厂商替你托管 DeepSeek、Qwen 这些,你还是调 API,价格通常更低,但机器成本高!
- 自己部署:完全可控,但硬件、运维、调优的成本全得自己来搞定。
对于绝大多数业务场景,第一条路就已经足够了。除非数据合规上绝对不能出内网;调用量大到 API 账单显著超过机器成本;需要用自己的数据做微调,这个时候才考虑另外两条路线。
本篇小结
06-消息角色与多轮对话
上一篇我们留了个问题没回答:messages 为什么是个数组,而不是一段字符串?
毕竟在那个最小调用里,数组里只有一条消息,却仍要标注 "role": "user"。只有用户发言时,这个身份字段看起来也是多余的。
答案在你再往下做一步的时候才会显现。你想把那段代码改造成一个能连续聊天的助手,只把用户的当前问题发过去,是不行的。第一轮你告诉它"我的项目用的是 Java 17",模型给出简短回复;第二轮你问"那该选哪个 Spring Boot 版本",它完全想不起来你说过 Java 17。
messages 数组就是模型能看到的全部世界。 它自己不存任何东西,你这次给它什么,它就只知道什么。所以这个数组必须能装下多条消息,不然上一轮的内容没地方放;也必须标清楚每条是谁说的,不然模型分不出哪句是你问的、哪句是它自己上轮答的。
这一篇我们就把 messages 这个数组讲清楚:三种角色分别管什么、多轮对话到底怎么"记住"上文等等。
一、三种消息角色:System、User、Assistant
messages 数组不是一组普通字符串,而是一个个带"身份"的对象,每个对象有 role(角色)和 content(内容)两个字段。角色只有三种,各司其职。
- 系统提示词(System):给模型设定"人设"和规则的地方。你是谁、说话什么风格、能做什么不能做什么、输出格式要求,都写在这里。它在整段对话里持续生效。
- 用户消息(User):用户说的话,也就是真正的问题或指令。
- 助手消息(Assistant):模型自己的回复,你把它原样放回数组里。
一个最简单的多轮对话,messages 长这样:
messages = [
    {"role": "system", "content": "你是一个只用一句话回答的地理老师。"},
    {"role": "user", "content": "中国的首都是哪?"},
    {"role": "assistant", "content": "北京。"},
    {"role": "user", "content": "那它的人口大概多少?"},
]
模型看到最后那句"它的人口",能正确理解"它"指北京,因为整个数组作为上下文一起发了过去。这就是多轮对话的核心机制,后面详细讲。
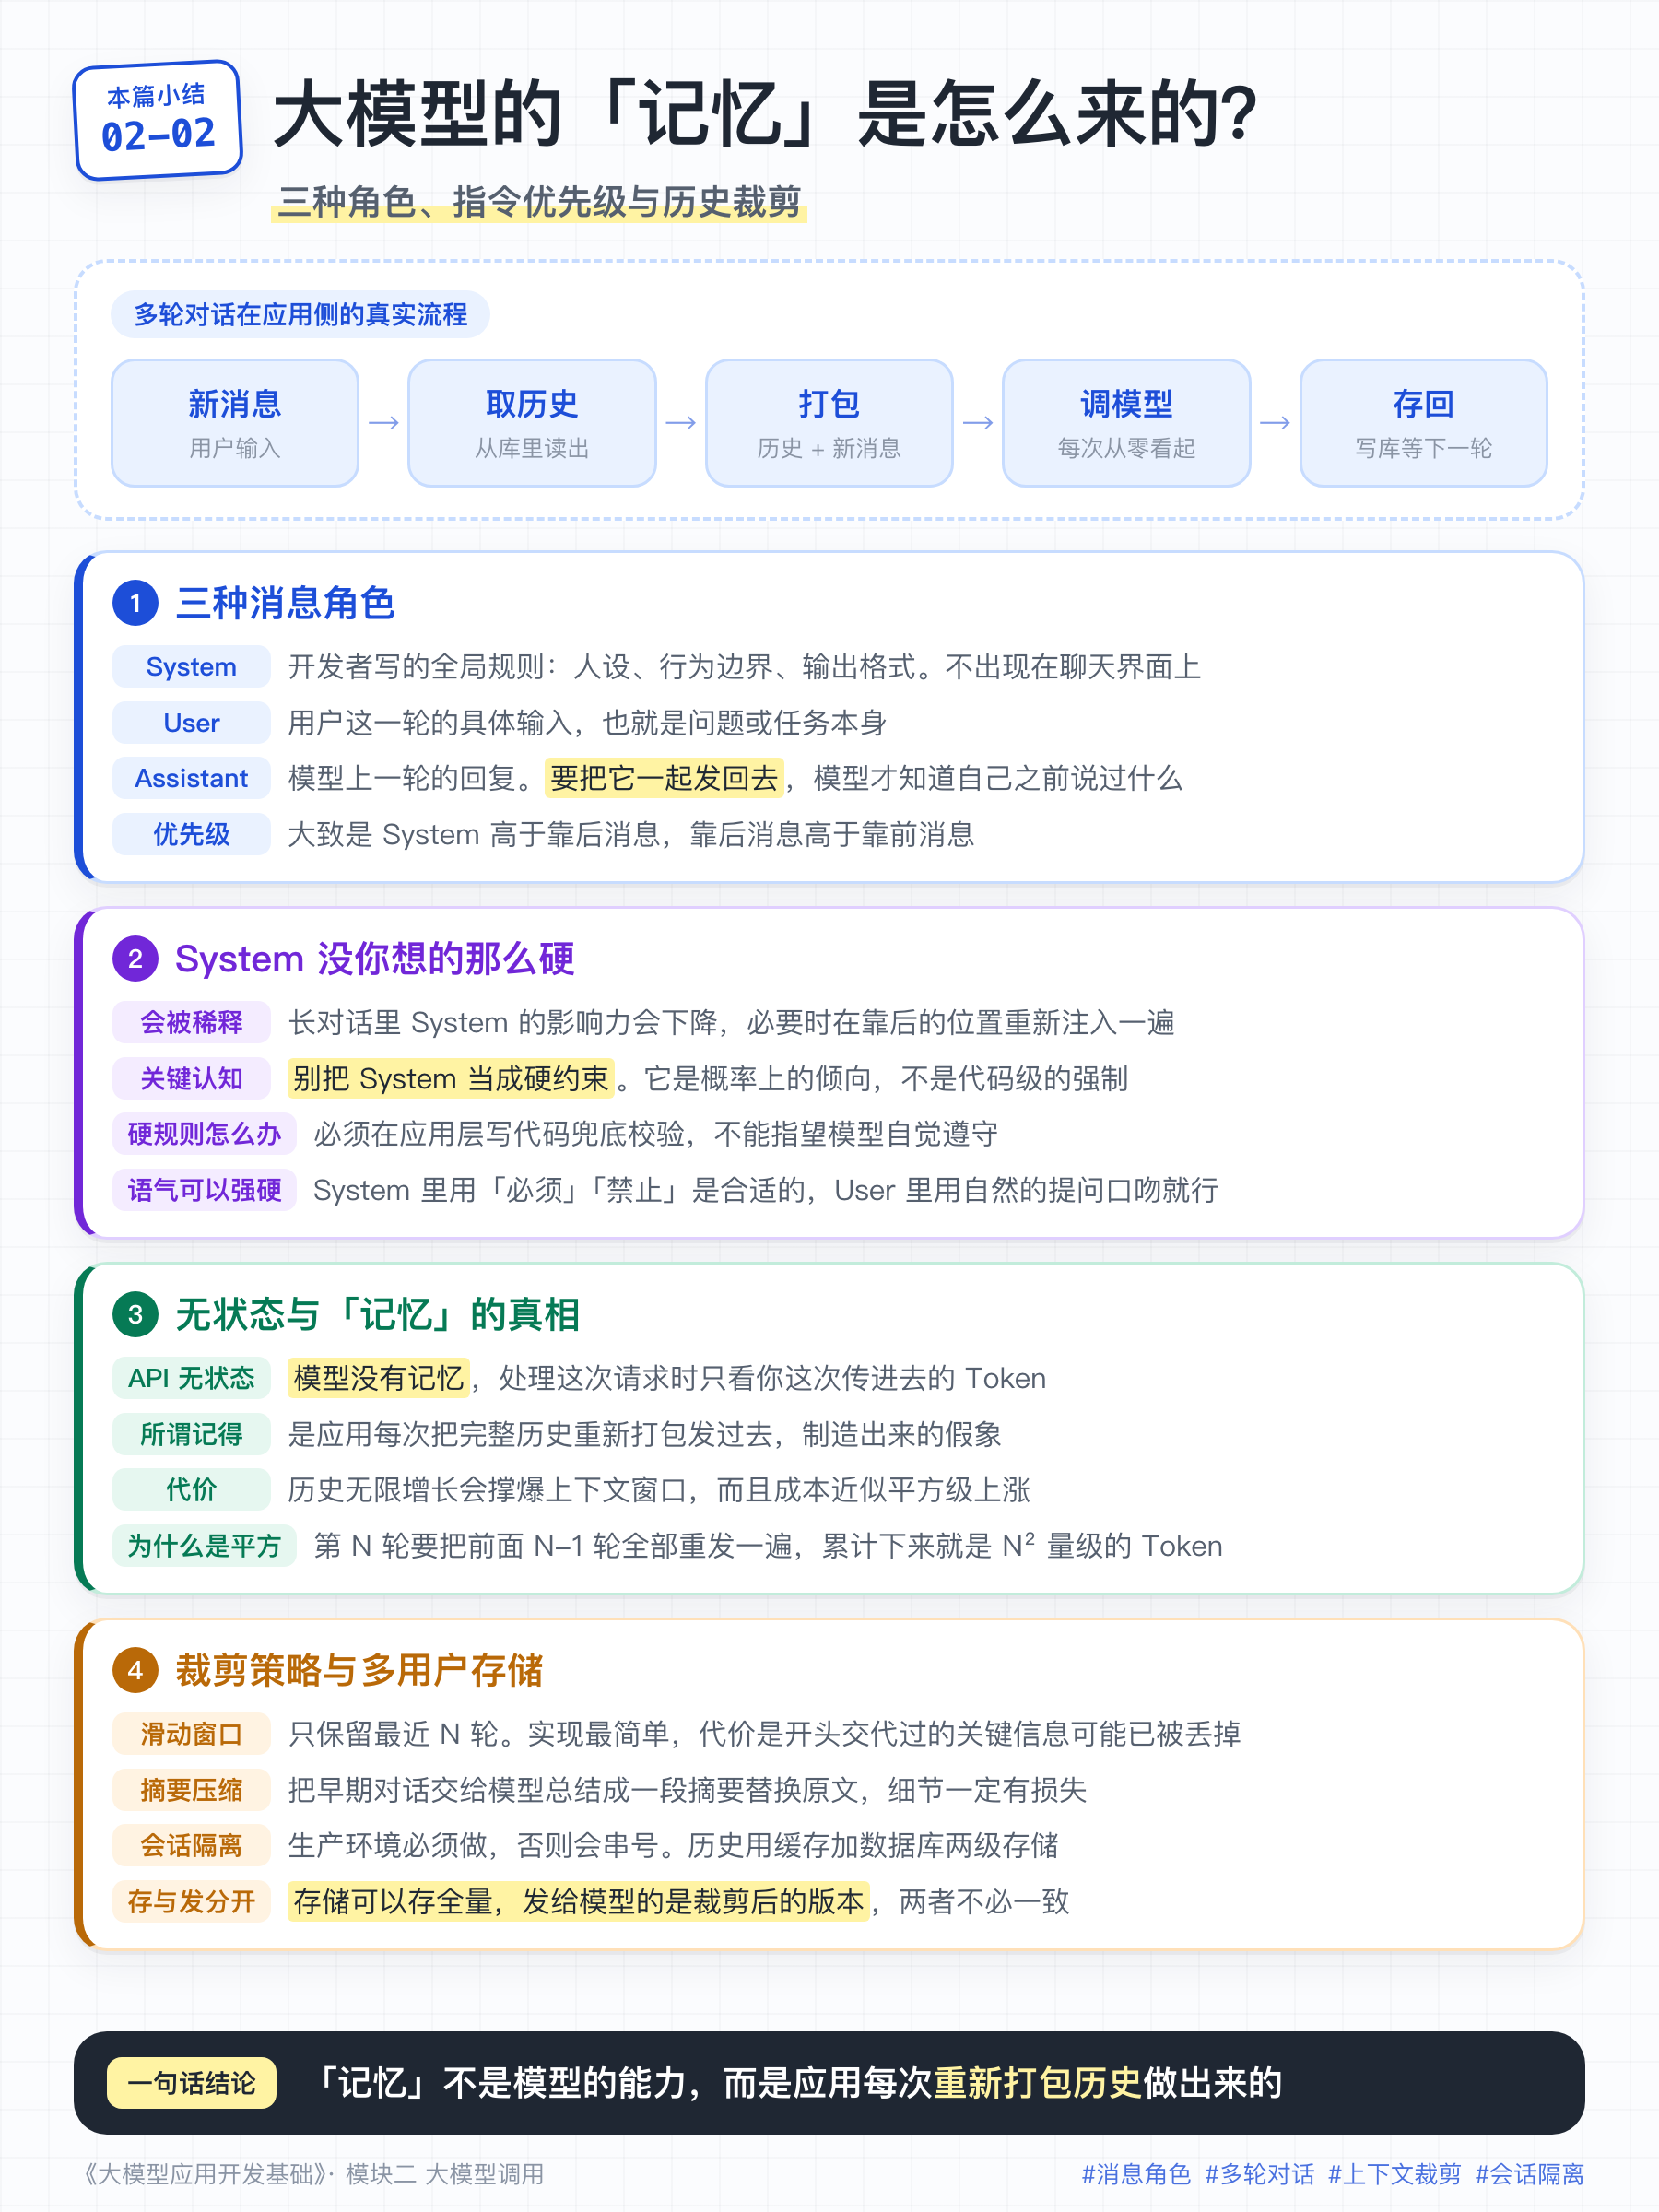
这里要纠正一个常见误解:很多人把 System 当成"更高级、约束力更强"的指令,以为写在这里模型就一定照做,不是的。 System 只是优先级更高的一段文本,本质还是被拼进上下文、一并发给模型。你写"绝对不能透露你是 AI",经过几轮诱导仍可能被绕过。System 是"强烈建议",不是强制约束。真正的硬约束(比如不能返回某些内容)要靠你在应用层做后置校验,而不能只靠一句 System 就认为约束已经生效。
二、消息顺序与指令优先级
既然 System、User 都是文本,那它们冲突时听谁的?这就涉及优先级。
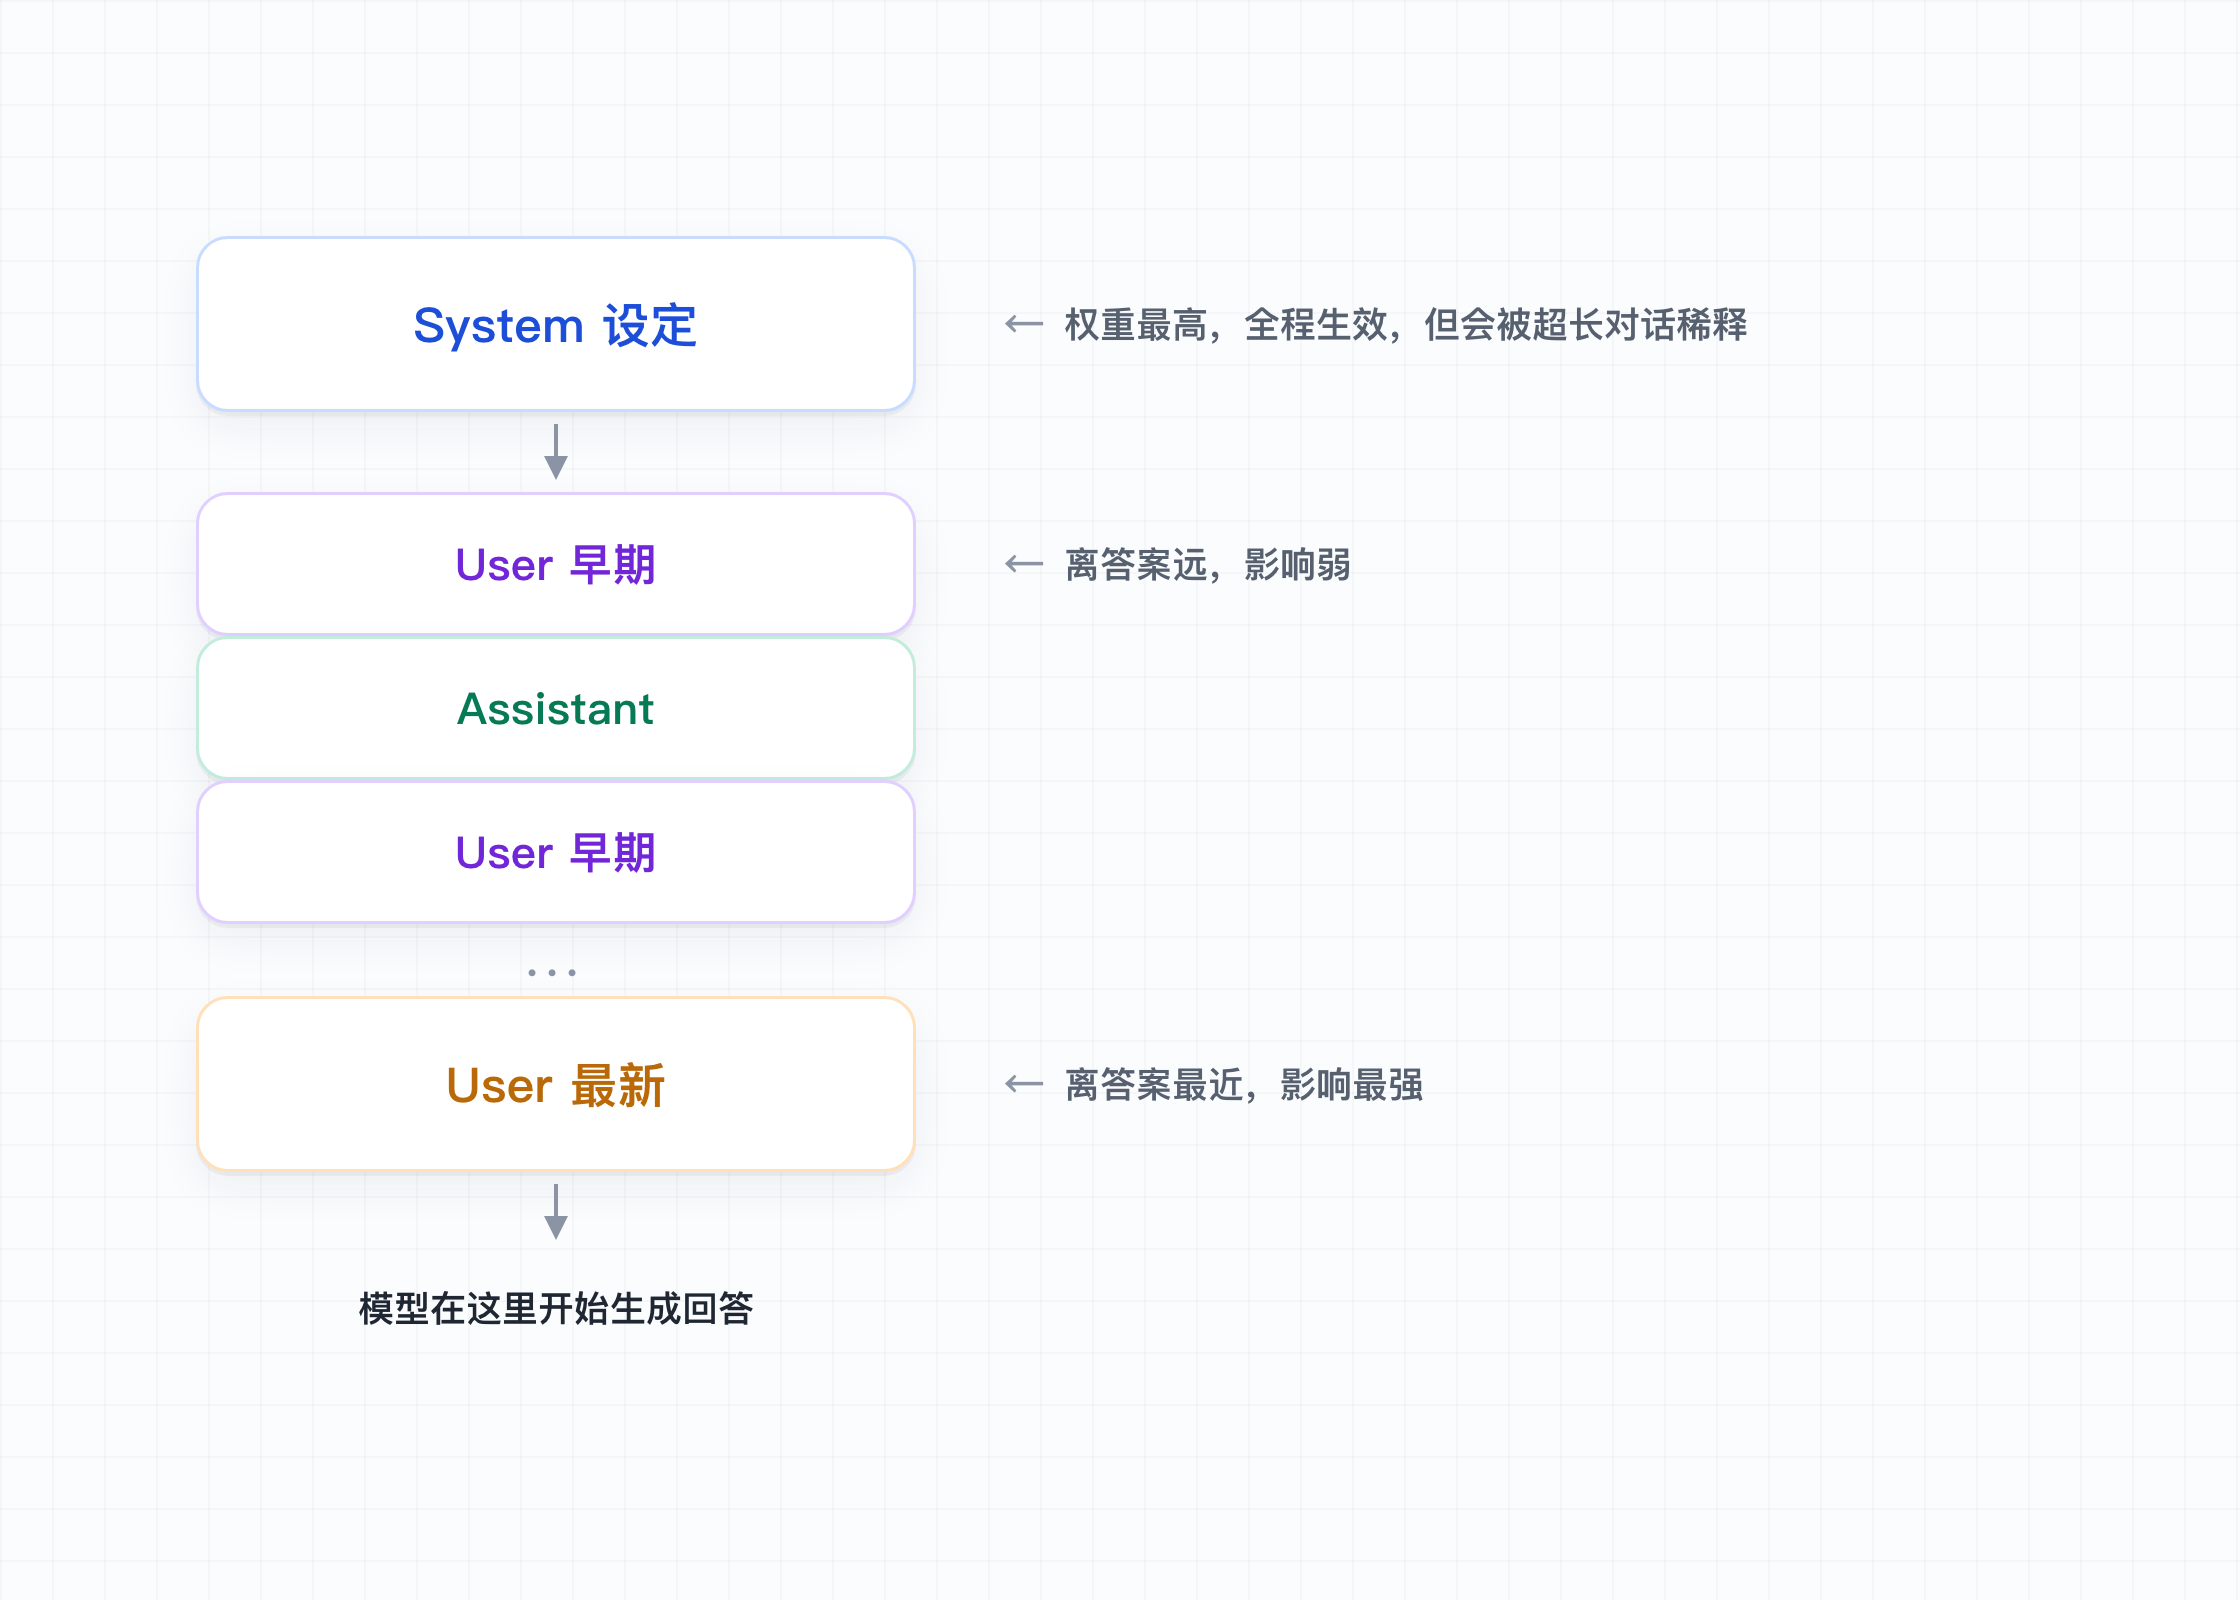
主流模型的大致优先级是:System > 靠后的消息 > 靠前的消息。也就是说,System 整体权重最高;而在同类消息里,越靠近末尾的内容,模型越倾向于遵从,因为那是"最新的指令",离它要生成的答案最近。
这带来两个非常实用的工程结论。
第一,把最重要的约束放 System,把当前这轮最具体的要求放在 User 消息末尾。 比如 System 规定"永远用 JSON 回答",而某一轮用户临时说"这次用自然语言解释一下",模型大概率会顺从后者。如果你不希望被覆盖,就得在 System 里把约束写得更明确、不允许例外,或者在应用层拦截。
第二,警惕"后文覆盖前文"带来的指令漂移。 对话很长时,早期 System 设定的风格会被后面几十轮的对话稀释、偏离原设定。比如,客服机器人聊到第 20 轮,突然不按规范话术说话了。原因往往就是早期 System 权重被大量后续内容冲淡。工程上的应对办法是:在关键轮次重新注入或强调 System 指令,比如每隔若干轮,或在检测到偏离既定风格时,把核心规则再拼一遍到上下文靠后的位置。
用一张图理解模型"读"上下文的顺序和注意力倾向:
三、无状态 API 与"记忆"的真相
现在讲最反直觉、也最重要的点。
你可能会觉得,我和模型聊了好几轮,服务器那边肯定存着我们的对话吧?恰恰相反。大模型的 API 是无状态的(Stateless)。每一次调用都是全新的、独立的、没有任何记忆的。 大模型不会帮你保存上一轮说了什么。这次请求结束,它不会保留任何上一轮状态。
那对话为什么能连续?因为 "记忆"是由应用(对话助手)自己构造的 。每次调用时,应用把你从头到现在的所有历史消息,重新放入 messages 数组一起发过去。模型看到的从来不是"第 5 轮",而是"这 5 轮的完整文本"。它不是记得,它是每次都重新读了一遍全部历史对话。
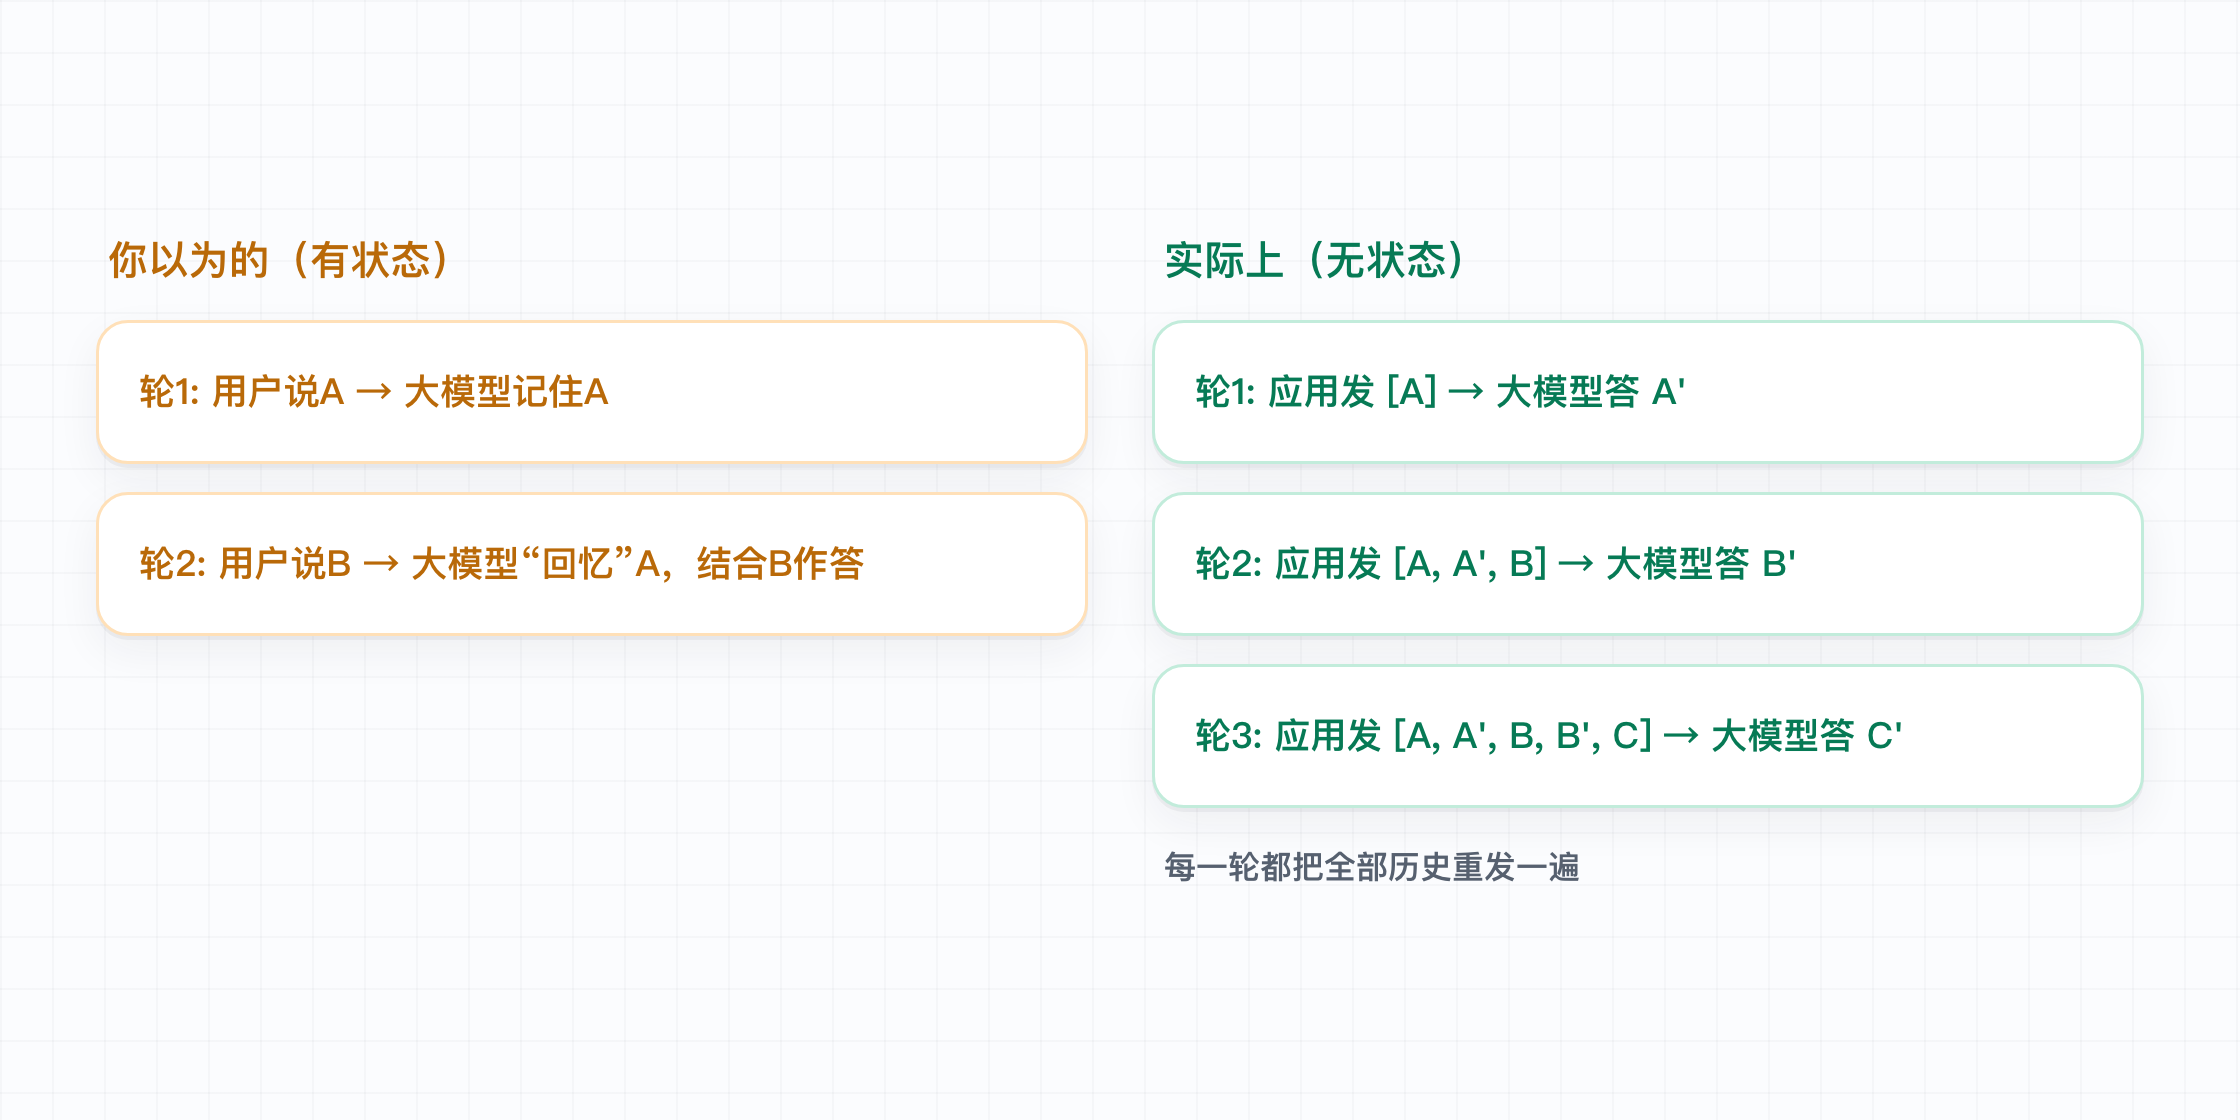
理解了这点,很多现象就能解释清楚:为什么对话越长响应越慢、越贵(因为每次都在重发全部历史);为什么同一个用户换个设备还能接着聊(因为历史存在应用的数据库里,不在模型那里)。
下面是一个实现"记忆"的示例代码:
from openai import OpenAI

client = OpenAI()

# history就是一个不断追加的数组,由你的应用维护
history = [
    {"role": "system", "content": "你是简洁的助手。"},
]

def chat(user_input: str) -> str:
    # 1. 把用户这轮的话追加进history
    history.append({"role": "user", "content": user_input})
    # 2. 把【完整历史】一起发出去——这就是"记忆"的来源
    resp = client.chat.completions.create(
        model="gpt-5.6",
        messages=history,
    )
    answer = resp.choices[0].message.content
    # 3. 关键:把模型的回复也追加回history,下一轮它才"记得"自己说过什么
    history.append({"role": "assistant", "content": answer})
    return answer

chat("我叫小王")
print(chat("我叫什么?"))  # 能答对,因为上一轮的信息被重发了
四、历史对话过长的应对策略
无状态机制有个严重副作用:历史只会越来越长。 前面的章节中讲过上下文窗口(Context Window),即模型单次能处理的 Token 是有上限的。历史无限追加,迟早会超限报错;就算没超,成本也会明显上升。
这里要算一笔账,也是面试常被追问的点:为什么对话成本不是线性的,而是接近平方级增长?
因为按 Token 计费,而你每一轮都要把前面所有历史重发。第 N 轮发送的 Token 约等于前 N-1 轮的累加。十几轮的闲聊成本差异还不明显,但客服、Agent 这类动辄几十上百轮的场景,Token 消耗会上升得很快。这就是为什么"管理历史"不是可选项,而是生产系统的必要工作。
常见的应对策略一般有两种,各有取舍。
策略一:滑动窗口,即只保留最近 N 轮。 最简单,实现只需要几行代码。缺点是"失忆":用户开头说的关键信息(比如"我是 VIP 用户")一旦滑出窗口就丢了。
def trim_by_turns(history, keep_rounds=6):
    system = [m for m in history if m["role"] == "system"]
    others = [m for m in history if m["role"] != "system"]
    # 一轮 = user + assistant 两条,保留最近 keep_rounds 轮
    kept = others[-keep_rounds * 2:]
return system + kept注意上面这个细节:System 消息必须单独取出并始终保留,不能被一起截掉。
策略二:摘要压缩(Summarization)。 当历史过长时,先调用一次模型,把早期对话压缩成一段简短摘要,用这段摘要替换掉那批原始消息。这样既省 Token,又保住了关键信息。代价是多一次模型调用,而且摘要可能丢细节。工程上常用"摘要 + 最近若干轮原文"的组合:远期用摘要,近期用原文。
拼出来的 messages 是这样的,注意摘要是数组里独立的一条,不要和其他内容写在同一个 content 里:
messages = [
    {"role": "system",    "content": "你是XX电商的客服助手,规则..."},   # 静态人设
    {"role": "system",    "content": "对话摘要:用户是VIP,咨询过退款,已确认订单号12345"},
    {"role": "user",      "content": "..."},        # 以下是最近 3 轮原文
    {"role": "assistant", "content": "..."},
    {"role": "user",      "content": "..."},
    {"role": "assistant", "content": "..."},
    {"role": "user",      "content": "本轮问题"},
]
摘要的角色为什么是 System 而不是 User?因为它是应用注入的状态,不是任何一方真说过的话。放 System 语义最准,优先级也高,不容易被后面的对话稀释;要是当成 user 消息写进去,模型会以为这些话是用户说的,有时会顺着去"回应"摘要本身。
这里还有个容易忽略的细节:摘要要另起一条 System,别拼进原来那条。 因为 Prompt Caching 是按前缀匹配的,静态人设每轮都一样、能稳定命中缓存,而摘要每次压缩都会变。拼成一条,摘要一变整个 System 的缓存就会失效;拆成两条,前面那条静态的仍然能稳定命中缓存。
要提醒的是,这个写法是 OpenAI 风格的。Anthropic 的 system 是顶层参数、不在 messages 数组里,也只能是一个字符串,没法追加第二条,因此,摘要只能拼进 system 字符串(牺牲缓存),或者当成带显式标记的 user 消息发。
这里只是针对对话这个场景,给你展示了如何进行历史消息过长的处理,后面,我们在讲到Agent开发的时候,还会有专门的一个专题:上下文工程,来讲如何在有限的上下文窗口内,放置最有价值的信息。
五、多用户与长期历史存储
前面 history 用的是全局变量,只是为了演示而简化代码。真实应用有成千上万用户同时在聊,你必须解决两个问题。
第一,会话隔离。 每个用户、甚至同一用户的每个会话,都要有独立的历史,绝不能互相混用。踩过的坑是把历史存成全局或单例,结果 A 用户看到了 B 用户的对话。这是严重的隐私事故。正确做法是用 session_id(或 user_id + conversation_id)作为 key,分别存储。
第二,历史存哪。 只存在内存里并不可靠,服务一重启历史会全部丢失,多实例部署时请求还可能被负载均衡路由到不同实例。因此,生产方案通常是:
- 热数据放缓存(如 Redis),读写快,适合正在进行的会话,可设过期时间自动清理;
- 全量/长期历史落数据库(如 MySQL、MongoDB),持久、可追溯、支持跨设备续聊。
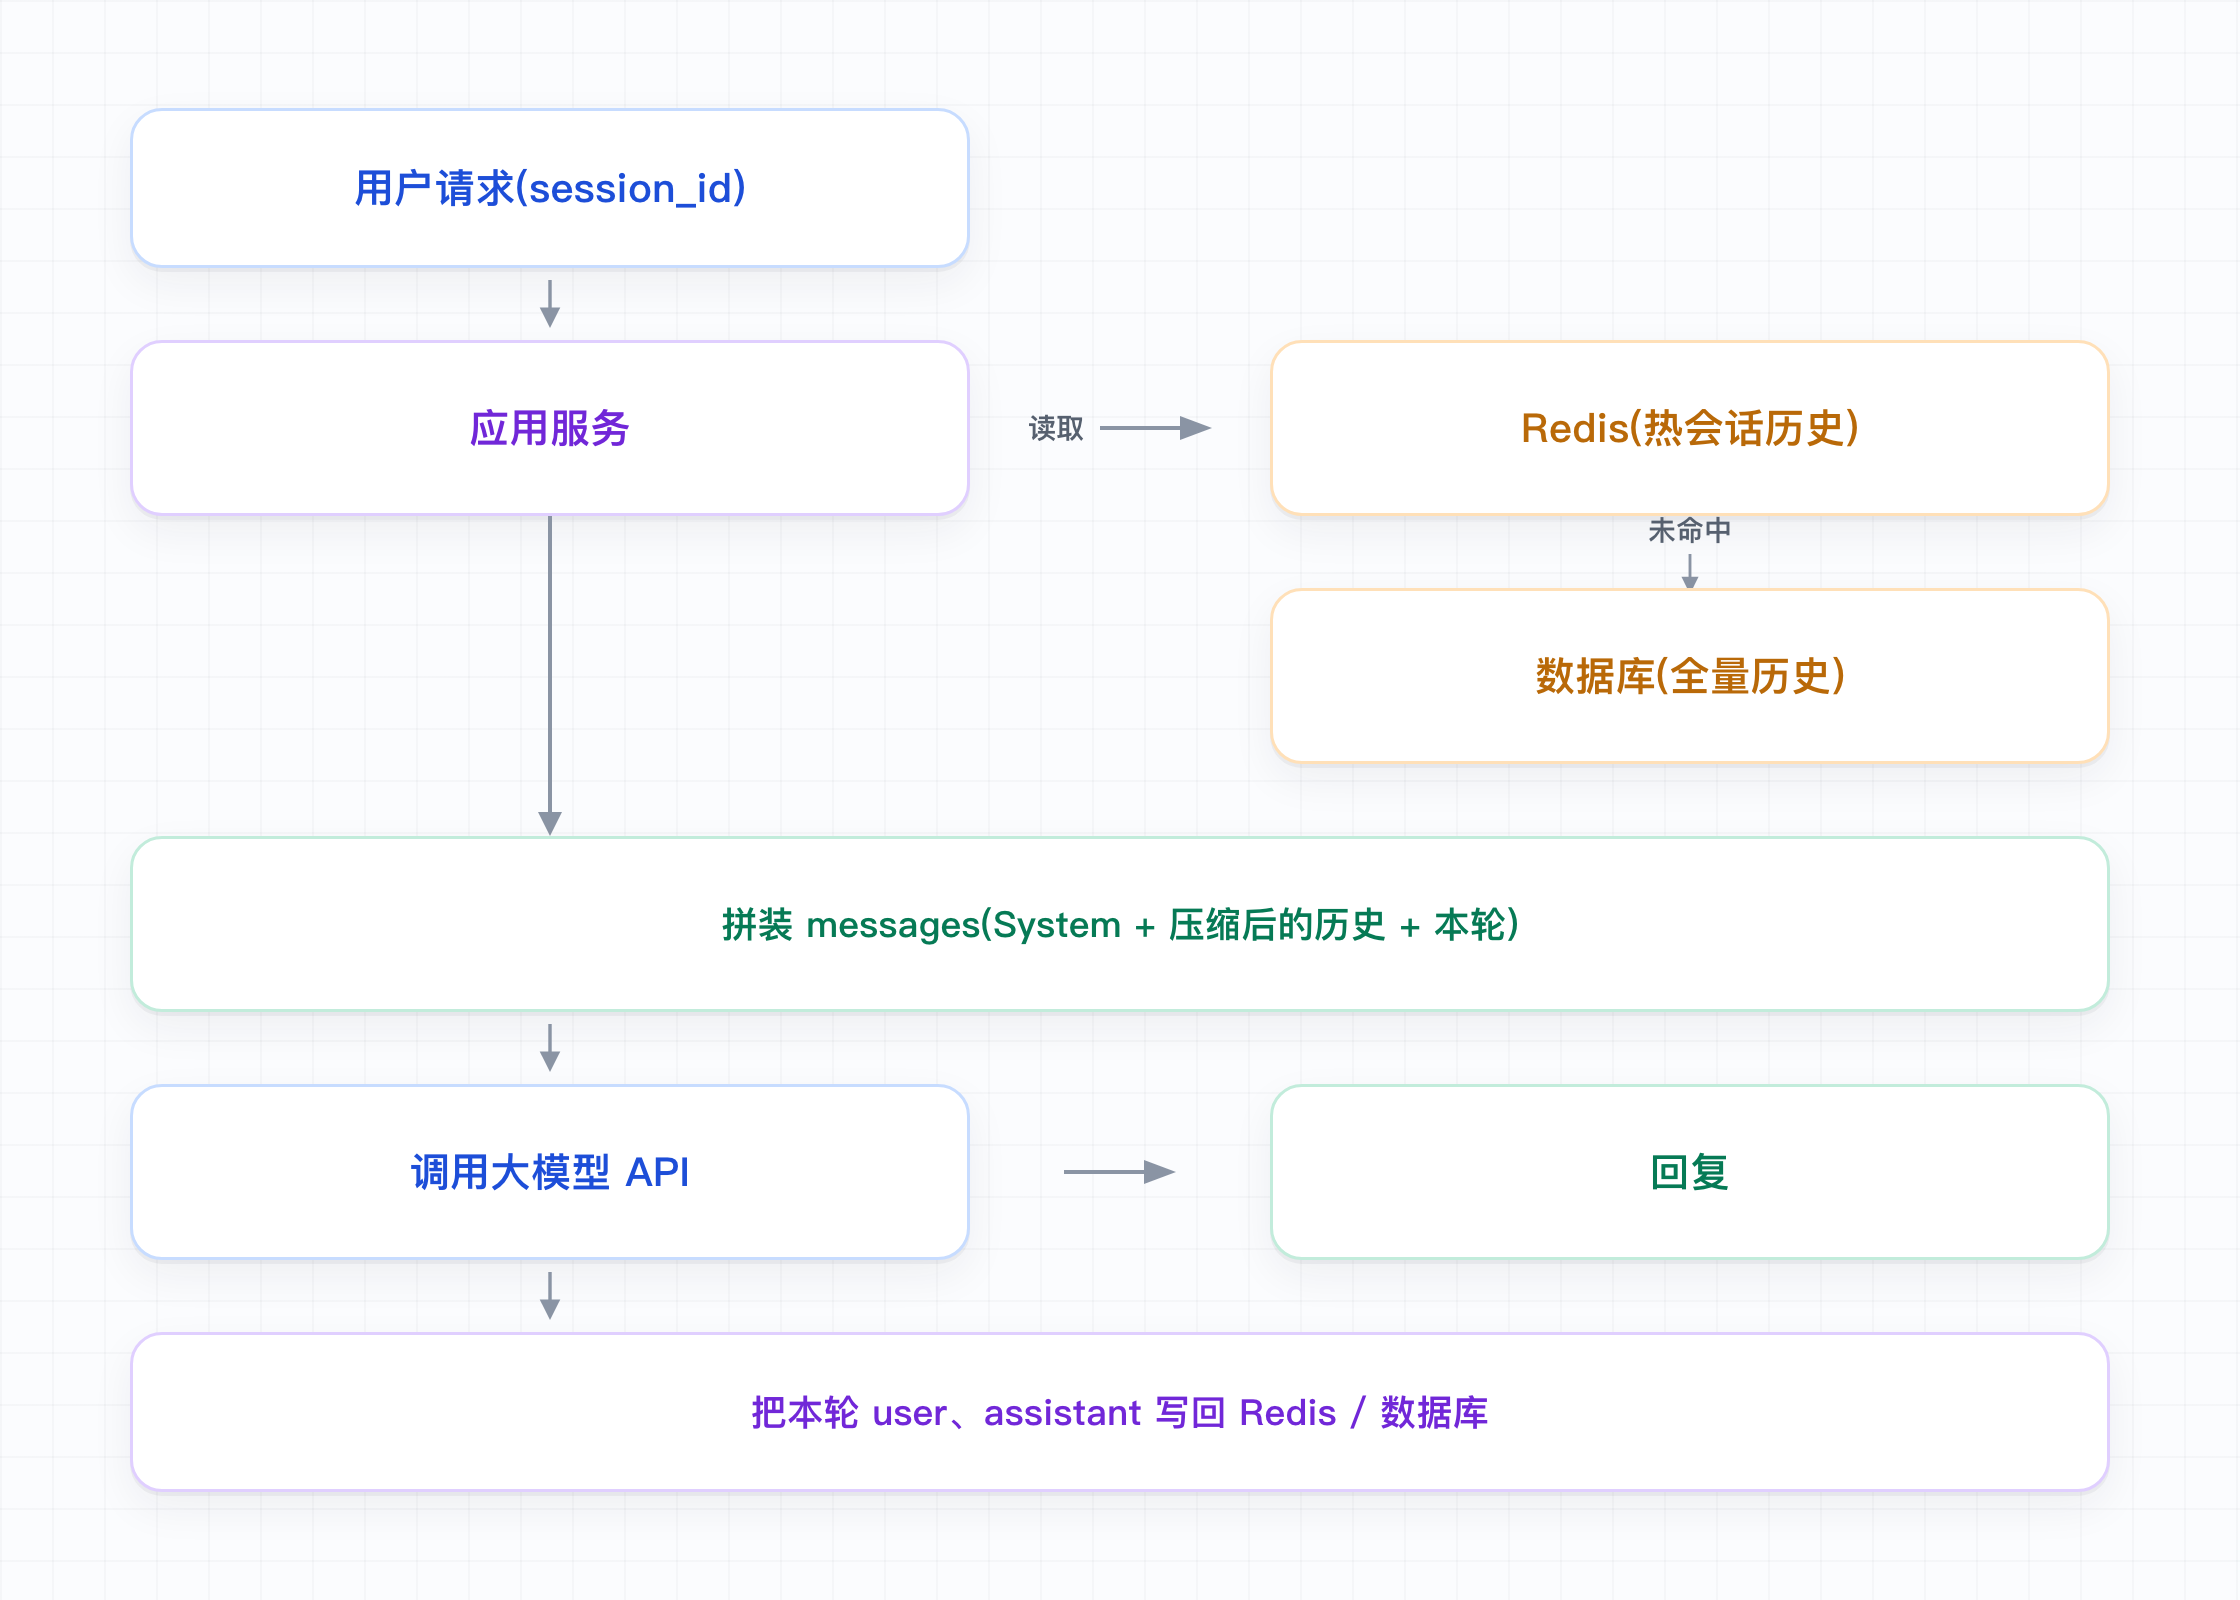
存储的可以是完整历史,每次真正发给模型的,是经过裁剪/摘要后的版本。 你库里存全量便于审计和回溯,发给模型的则是精挑细选、控制在预算内的那一份。两者分离,才能兼顾成本与可靠。
同样,这里也只是简单讲了对话这个场景如何记录历史消息,在后面讲到的 Agent 的时候,我们还会详细讲解 Agent 的状态管理和记忆系统,会复杂得多。
本篇小结
07-控制模型输出的关键参数
上一篇我们把 messages 数组讲清楚了,知道了怎么组织消息、怎么实现多轮对话。但真正用起来,你很快会碰到一个难以预期的现象。
同样一段代码、同样一句提问,今天模型答得规规矩矩,明天突然就发散了,格式也偏离了预期。甚至同一次运行连着调两遍,结果都能不一样。
这不是 bug,是feature。模块一讲原理的时候说过:模型每生成一个 Token,都是在一批候选词上按概率抽样,而抽样这个动作本身就带随机性。
那既然随机性来自抽样,能不能在调用的时候调几个参数,让它该稳定时稳定、该多样时多样?
能。这些参数叫采样参数(Sampling Parameters),是你作为开发者控制模型输出最直接的手段。这一篇我们就把它们一个个讲清楚。
一、模型是怎么「选下一个词」的
要讲清楚这些参数到底在调什么,得先回到生成的那一瞬间。
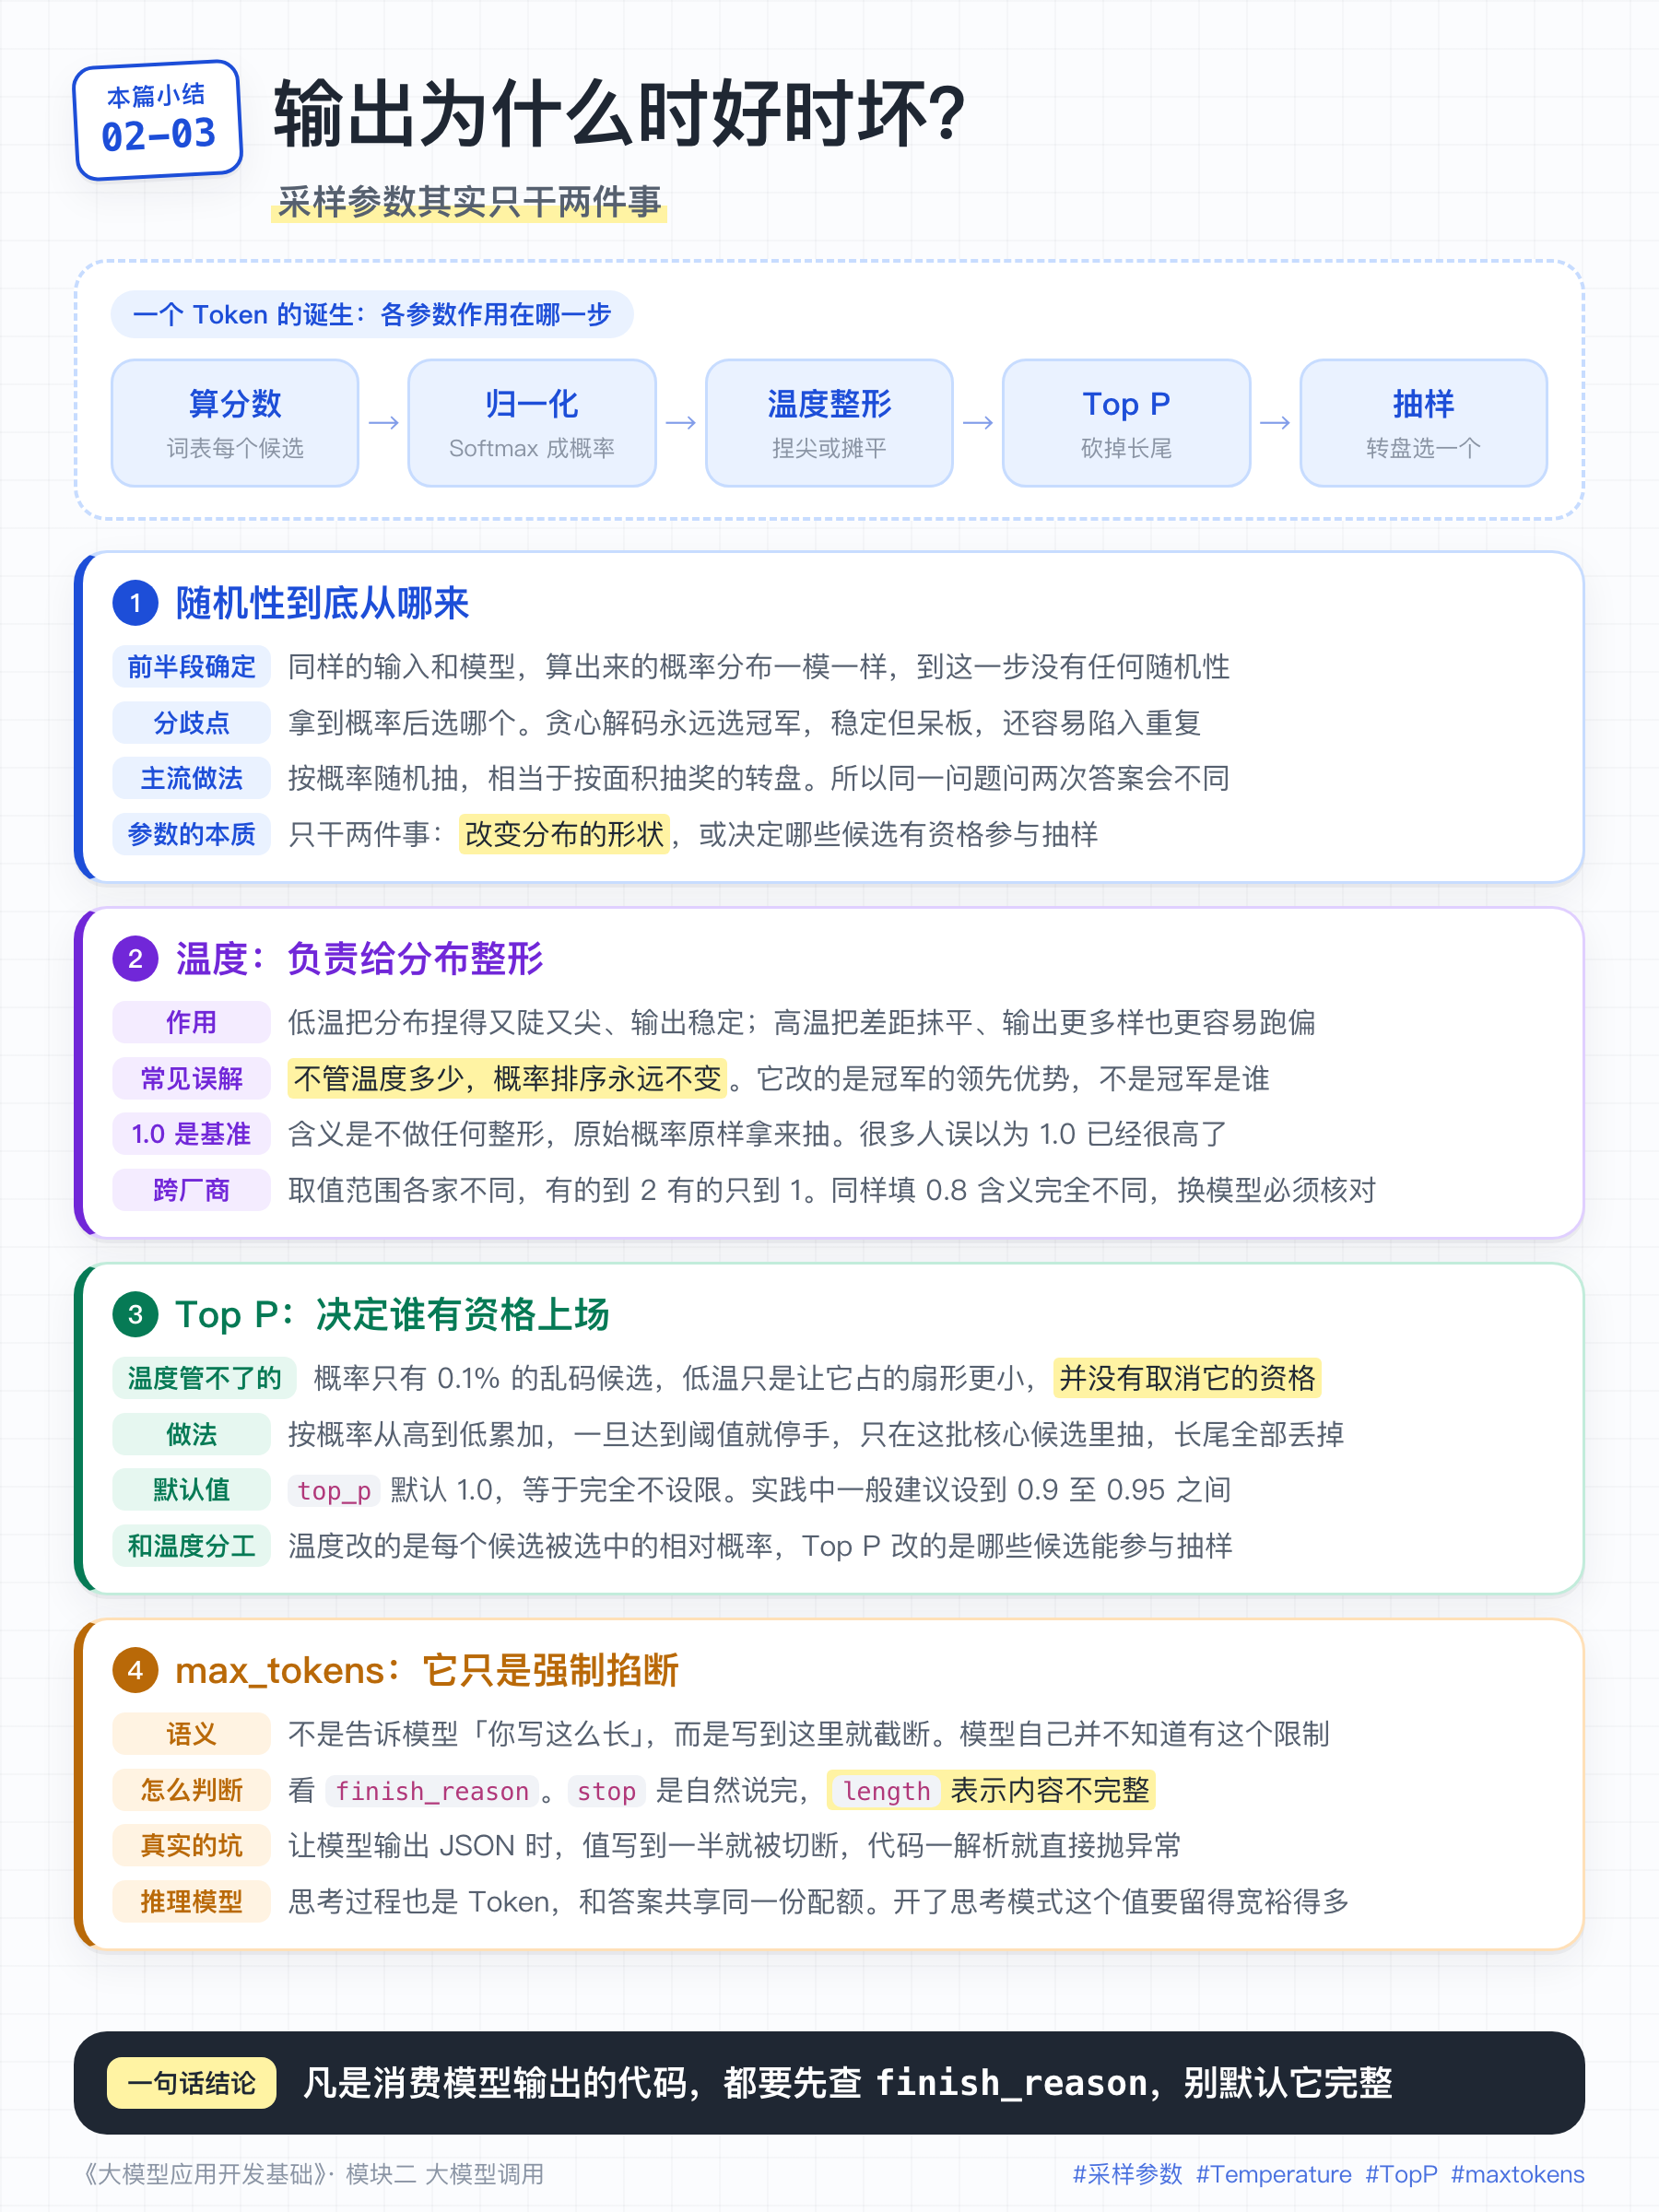
模型每生成一个 Token,会先给词表里每个候选词算一个分数,再用一个叫 Softmax 的函数把它们归一化成一组概率。比如你输入「今天天气」,模型算出来可能是这样:
很    40%
不    25%
真    15%
挺     8%
...   剩下的分散在长长的尾巴上
到这一步为止,一切都是确定的。同样的输入、同样的模型,算出来的概率分布一模一样。
真正的分歧发生在下一步:拿到这组概率,到底选哪个?
一种做法是永远选概率最高的那个,也就是「很」。这叫贪心解码(Greedy)。好处是稳定,同样的输入永远给出同样的输出;坏处是呆板,而且特别容易陷入重复,写着写着开始反复重复同一句话。
另一种做法是按概率随机抽一个。你可以把这组概率想象成一个抽奖转盘:「很」占了转盘 40% 的面积,「不」占 25%,「真」占 15%,剩下几千个词挤在最后那一点点扇形里。模型转一下指针,落到谁头上就选谁。这样输出灵活、有变化,但偶尔会抽到一个奇怪的词,然后顺着那个词一路偏离上下文。
主流模型默认走的是第二条路。所以开头说的「同一个问题问两次,答案不一样」,根源就在此。
采样参数要解决的,就是在这两个极端之间找平衡。说到底它们只干两件事:
一是微调这组候选的概率值,二是决定哪些候选有资格参加抽样。
具体怎么做,我们接着往下看!
二、温度 Temperature
温度是最常用的一个参数。它干的事情,用一句话说就是给概率分布整形:把它拉得更尖,或者摊得更平。
温度调低,高概率的词会被进一步拉高,低概率的词被压得更低,整个分布变得又陡又尖。模型几乎每次都选中那个最可能的词,输出稳定、保守。温度调高则相反,词与词之间的差距被抹平,原本概率很低的词被选中的机会也变大了,输出更多样,当然也更容易偏离预期。
这里有个关键点必须先说清楚,很多人会搞错:不管温度调到多少,Token 的概率排序永远不变。 冠军还是冠军,亚军还是亚军。温度改变的是「冠军的领先优势有多大」,而不是「冠军是谁」。
回到转盘的比喻:温度不换转盘上的选手,只调整每个人占多大的扇形。
拿前面那组概率举例,不同温度整形之后大致是这样(数字仅为示意):
T = 0      很 100%                        强制选冠军,等价于贪心解码
T = 0.2    很 85%   不 10%   真  3%        极度拉尖,几乎只出冠军
T = 0.7    很 60%   不 25%   真 10%        适度拉尖,偶尔冒出亚军
T = 1.0    很 40%   不 25%   真 15%        原始分布,不做任何整形
T = 1.3    很 33%   不 26%   真 20%        明显抹平,亚军季军机会大增
T = 1.8 很 28% 不 24% 真 21% 接近平均分配,输出连贯性明显下降在这张表里,温度 1.0 是基准线,意思是不做任何整形,原始概率原样拿来抽奖。 低于 1 是拉尖,高于 1 是抹平。不少人以为 1.0 已经很高了,其实它只是「什么都没做」,也正因为如此,它是大多数厂商的默认值,很适合当调参的起点。
再看最后一行。温度到了 1.8,前三名的概率几乎持平,近似均匀抽取。这时候模型说出来的话往往语法还通顺,但逻辑急剧下降,偏离主题、前后矛盾都很常见。
# 低温:连着跑几次,措辞高度相似
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-5.6",
    "messages": [{"role": "user", "content": "用一句话形容大海"}],
    "temperature": 0.2
  }'

# 高温:连着跑几次,每次都不太一样
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-5.6",
    "messages": [{"role": "user", "content": "用一句话形容大海"}],
    "temperature": 1.3
}'这里得提醒一下:温度这个数字,在不同厂商那里不是一回事。
首先是取值范围。OpenAI 和 DeepSeek 都是 0 ~ 2、默认 1,但也有厂商只开放 0 ~ 1。同样填 0.8,在前者那里只是偏高一点点,在后者那里已经接近上限了。顺带一提,虽然上限给到 2,OpenAI 的建议是在 0 ~ 1 之间调最有效,越过 1 之后输出质量下滑得很快,这和上面那张表的观察是一致的。
三、核采样 Top P
温度解决了「分布多陡」的问题,但它只负责整形,不负责筛选。
什么意思呢?哪怕你把温度压到 0.3,那些概率本来就只有 0.1% 的垃圾候选,比如乱码字符、莫名其妙的标点、毫不相关的生僻字,依然待在转盘上,只是占的扇形更小了而已。
但「更小」不等于「没有」。只要它还占着一小块面积,理论上就有被抽中的可能。万一某次运气不好,指针恰好落在上面,模型就会生成一个莫名其妙的符号,然后顺着这个错误一路写下去,整段回答会明显偏离,后续内容也跟着错下去。这种偶发的异常输出,在生产环境里不可接受。
所以我们需要另一个参数,来干一件温度干不了的事:把那些概率极低的候选直接从转盘上去掉,让它们连参与抽奖的资格都没有。 这就是 Top P,学名核采样(Nucleus Sampling)。
它的做法是:先把候选词按概率从高到低排好队,从头开始累加,累计概率一旦达到 P 就停止,只让选中的这批词参与抽样,后面长长的尾巴全部扔掉。
还是刚才那组概率,把后面的尾巴也列出来,假设 Top P 设成 0.9:
很    40%    累计 40%    ✓ 入选
不    25%    累计 65%    ✓ 入选
真    15%    累计 80%    ✓ 入选
挺     8%    累计 88%    ✓ 入选
凉     5%    累计 93%    ✓ 入选  ← 累计首次越过 90%,到此为止
──────────────────────────────────────
。     3%                ✗ 出局
啊     2%                ✗ 出局
呢     1%                ✗ 出局
后面几千个词(含各种乱码)   ✗ 出局
候选池只剩前五个,那些 3%、2%、1% 的偏门 Token 连上转盘的资格都没有了。这样既保留了灵活性,又把明显不合理的词排除在外。
反过来,Top P = 1.0 等于完全不设限,所有 Token 都能参与抽奖,而这恰恰是大多数 API 的默认值。实践中一般建议设到 0.9 到 0.95 之间,既能滤掉乱码,又不至于把候选池压得太死、让模型可选词过少,输出过于单一。
两者的区别,一句话总结一下:温度改的是「每个候选被选中的相对概率」,Top P 改的是「哪些候选有资格参与抽样」。
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-5.6",
    "messages": [
      {"role": "system", "content": "你是一个资深的 Python 工程师。"},
      {"role": "user", "content": "帮我写一个快速排序算法"}
    ],
    "temperature": 0.2,
    "top_p": 0.9,
    "max_tokens": 1000
  }'
四、最大输出长度 max tokens
max_tokens(有些厂商叫 max_output_tokens)限制的是模型这一次最多能生成多少 Token。
要特别注意它的语义:它不是告诉模型「你写这么长」,而是「写到这里就强制掐断」。模型自己并不知道有这个限制,它只是写着写着,突然被中途截断。
它有两个用途。一是控制成本,输出 Token 通常比输入贵好几倍;二是防止模型输出过长、没有止境。
那怎么知道是不是被截断了?看响应里的 finish_reason 字段:
stop:模型自然说完了,正常结束。length:超过了长度上限被截断,内容不完整。
我们故意把 max_tokens 设小,看看会发生什么:
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-5.6",
    "messages": [{"role": "user", "content": "详细解释一下什么是数据库事务"}],
    "max_tokens": 30
  }'
返回是这样的(省略了无关字段):
{
  "choices": [
    {
      "index": 0,
      "message": {
        "role": "assistant",
        "content": "数据库事务(Transaction)是指作为一个整体来执行的一组数据库操作,这组操作要么全部成功"
      },
      "finish_reason": "length"
    }
  ],
  "usage": { "prompt_tokens": 18, "completion_tokens": 30, "total_tokens": 48 }
}注意两点:content 在「要么全部成功」这里戛然而止,后半句没了;而 finish_reason 是 length,这就是它在告诉你「我没说完,是被掐断的」。
说个真实会踩的坑: 让模型输出 JSON。max_tokens 设小了,模型写到 {"name": "张三", "age": 就被切断,你的代码一解析就直接抛异常。
所以凡是消费模型输出的地方,先检查 finish_reason,是 length 就报警或者重试,别默认它一定完整。
还有一个容易忽略的点。用推理模型的时候,思考过程也算 Token,和最终答案共享同一份 max_tokens 配额。所以开了思考模式,这个值要比平时留得宽裕得多,否则很容易出现「思考过程已经消耗了大量 Token,答案还没开始写就没配额了」的尴尬情况。
本篇小结
08-结构化输出与数据校验
做大模型应用时,你很快会发现:模型默认输出自然语言,程序要的却是数据。
比如做一个简历解析功能。用户上传简历,你要把姓名、电话、工作年限写进数据库。你问模型「提取这份简历的关键信息」,它可能回你:
这位候选人叫张三,联系电话是 138xxxx,有大约 5 年 Java 开发经验……
人看是没问题,但代码怎么办?用正则提取电话、工作年限?输出稍微一改变,你的正则立刻失效。
程序真正想要的,是下面这样 JSON 格式的数据:
{"name": "张三", "phone": "138xxxxxxxx", "years_of_experience": 5}代码不用处理句子,按字段取值就行。这种「字段固定、类型明确、程序能直接读」的格式,开发里最常用的就是 JSON。
让模型按这种约定来输出,而不是自由发挥写一段话,就叫结构化输出(Structured Output)。
这一篇我们就讲:怎么让大模型稳定输出符合你约定的结构化数据。
一、提示词约束
最简单的办法是在提示词里把输出格式写清楚,比如「只返回 JSON,字段长什么样...等」。这叫提示词约束。
它不依赖任何特殊接口参数,本质就是在提示词里约定输出规则。
一份写得比较完整的提示词,会把 JSON 的格式直接嵌进去,而不是只列出几个字段名:
从下面的简历里抽取信息,只返回 JSON,不要任何解释、前后缀或代码块。

JSON 格式如下:
{
  "name": "字符串,候选人姓名",
  "phone": "字符串,11 位手机号",
  "years_of_experience": "整数,工作年限,只填阿拉伯数字"
}

简历:
张三,13800138000,Java 开发 5 年,可独立负责模块。
你希望拿到的是一段可直接解析的 JSON,但实际经常拿到的是这些:
好的,这是结果:
{"Name": "张三", "years": "五年", "phone": "13800138000"}

(外面还包了一层 markdown 代码块)
```
{"name": "张三", "phone": "13800138000"}
```
为什么模型不严格遵守?因为它不是规则引擎,提示词也不是编译器里的类型声明。
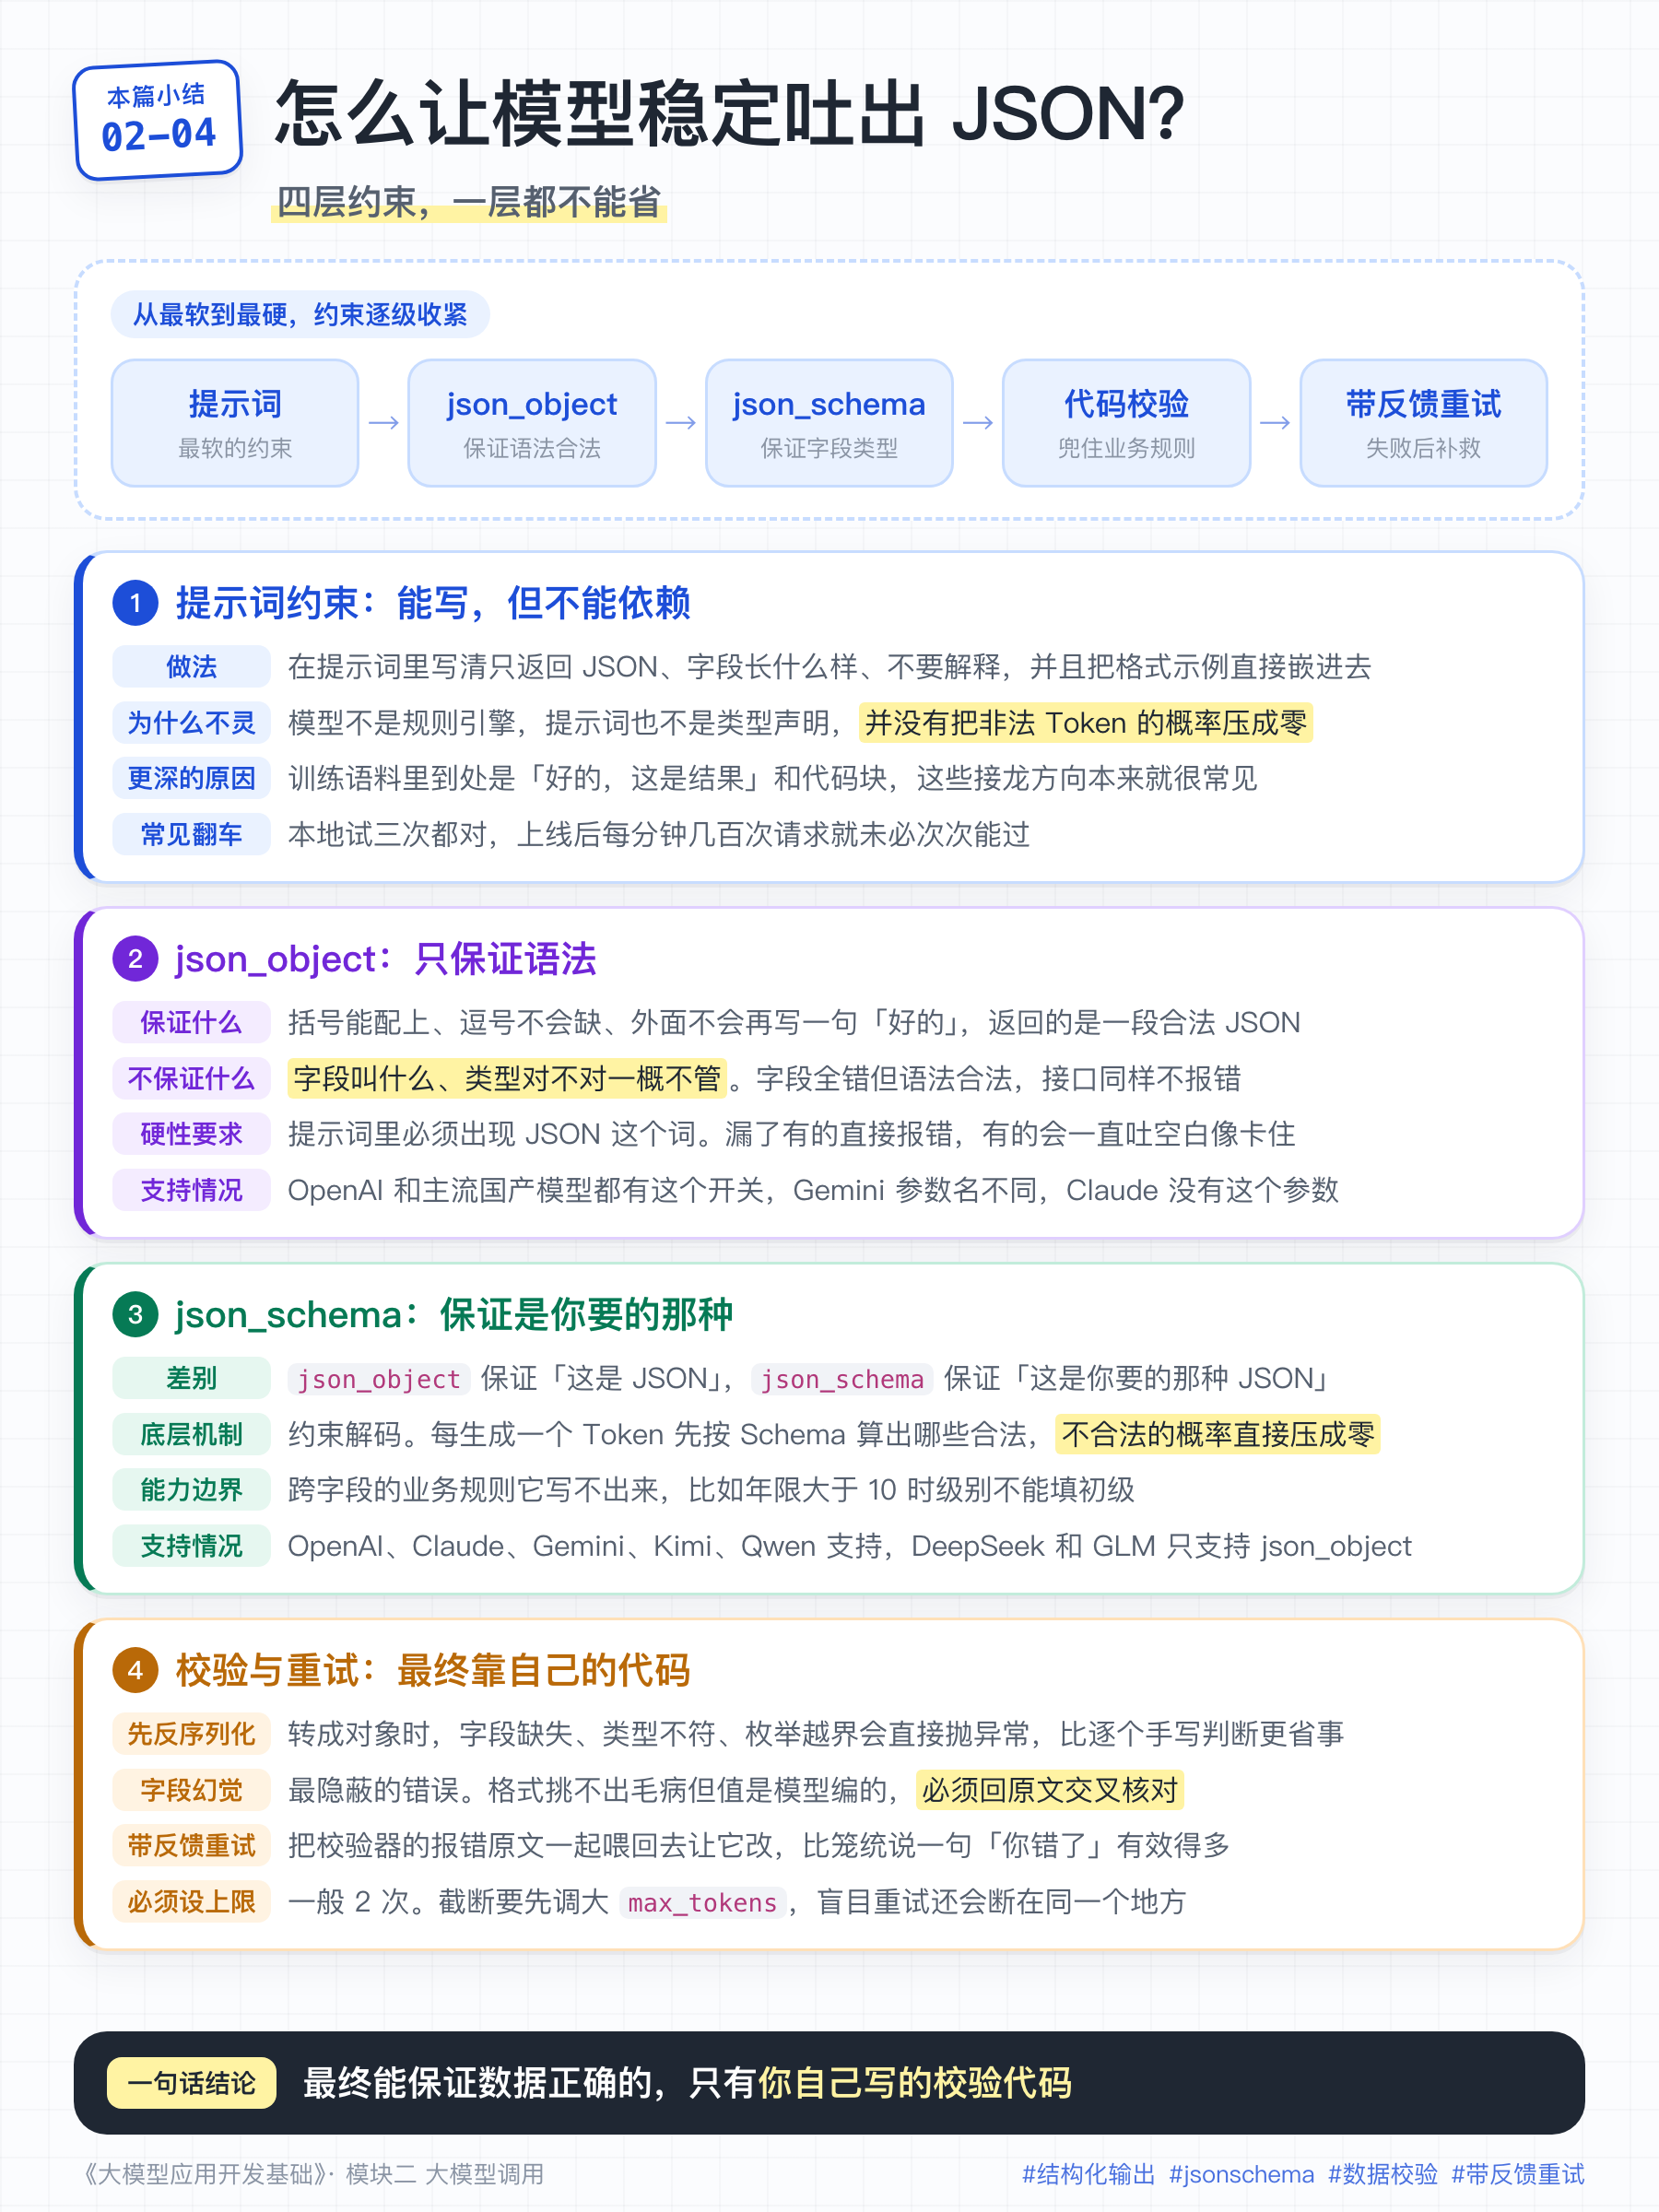
模块一讲过:模型每一步只是在算「下一个 Token 更可能是什么」。你写的「只返回 JSON,不要解释」,对它来说只是上下文里多了几句话,并没有把非法 Token 的概率压成零。训练语料里又到处都是「好的,这是结果」和 markdown 代码块,这些接龙方向本来就很常见。抽样时只要「好的」的概率比 { 高那么一点,就会先输出解释性前缀。
所以,生产环境单单靠提示词约束是行不通的。
你在本地试了三次都对,不代表上了线,每分钟几百次请求还能次次过。一次解析失败,轻则这条工单卡住,重则整条流水线报异常。
提示词只能把模型往正确方向引导,但不能当保证。要保证,得靠接口层禁止不合法输出。这就是下面两节 json_object 和 json_schema 要做的事情。
二、json_object
提示词约束太松,厂商就提供了更硬一点的开关:JSON Mode。你在请求里加上 response_format: {"type": "json_object"},接口保证返回的是一段合法 JSON:括号能配上、逗号不会缺、不会在外面再写一句「好的」。
它保证的是JSON语法,不是输出字段要求。字段叫 name 还是 Name,年限是 5 还是 "五年",它不管。
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "system",
        "content": "把简历抽成 JSON。示例:{\"name\":\"张三\",\"phone\":\"13800138000\",\"years_of_experience\":5}"
      },
      {"role": "user", "content": "张三,13800138000,Java 开发 5 年,可独立负责模块。"}
    ],
    "response_format": {"type": "json_object"}
  }'
返回通常已经能直接当 JSON 解析了。但下面这种也算「合法 JSON」,语法对了,字段全错了,接口不会报错:
{"姓名": "张三", "年限": "五年", "备注": "表现不错"}需要注意的是,使用 json_object 时,提示词里必须出现 JSON 这个词。 OpenAI、DeepSeek、Qwen 都这么要求。如果漏了的话,有的接口直接报错,有的会一直输出空白字符直到写满 max_tokens,看起来像卡住了。官方还建议你在提示词里给一个 JSON 示例,这样字段名才不容易偏离约定。
思考模式是另一个容易踩坑的地方。有的模型开了深度思考之后,根本不允许传 json_object,你传了就报错。更麻烦的是另一种,静默失效,即接口会接受该参数,请求也成功了,但最终回答并不保证是合法 JSON。有时,思考过程与正文混在一起,或者思考把输出配额占满,JSON 只生成了一部分。
除此之外,并不是所有模型都支持json_object。OpenAI 的 gpt-5.6、DeepSeek 的 deepseek-v4-flash、Qwen 的 qwen3.8-max、Kimi 的 kimi-k3,以及glm-5.3,都提供 json_object 这个开关。Gemini 能力接近,只是参数不叫这个名字,要把 responseMimeType 设成 application/json。Claude 没有这个参数,想约束格式得走下一节的 JSON Schema。
三、json_schema
JSON Mode 只管语法是否合法,而你真正要的是一份规范:有哪些字段、什么类型、哪些必填、枚举只能取哪几个值。这份规范的业界写法叫 JSON Schema。
{
  "type": "object",
  "properties": {
    "name": {"type": "string"},
    "years_of_experience": {"type": "integer"},
    "level": {"type": "string", "enum": ["初级", "中级", "高级"]}
  },
  "required": ["name", "years_of_experience", "level"],
  "additionalProperties": false
}
它和 JSON Mode 的差别是:json_object 保证「这是 JSON」;json_schema 保证「这是你要的那种数据格式」。
json_schema 底层靠的是约束解码(Constrained Decoding):每生成一个 Token,系统先根据 Schema 算出此刻哪些词合法,不合法的概率直接压成零。
curl https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-5.6",
    "messages": [
      {"role": "system", "content": "从简历文本中抽取结构化信息。"},
      {"role": "user", "content": "张三,13800138000,Java 开发 5 年,可独立负责模块。"}
    ],
    "response_format": {
      "type": "json_schema",
      "json_schema": {
        "name": "resume",
        "strict": true,
        "schema": {
          "type": "object",
          "properties": {
            "name": {"type": "string"},
            "years_of_experience": {"type": "integer"},
            "level": {"type": "string", "enum": ["初级", "中级", "高级"]}
          },
          "required": ["name", "years_of_experience", "level"],
          "additionalProperties": false
        }
      }
    }
  }'
Gemini 也支持json_schema ,但不走 response_format,而是 responseMimeType 设置为 responseJsonSchema。
Claude 也支持json_schema ,但参数名不同:
curl https://api.anthropic.com/v1/messages \
  -H "Content-Type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-sonnet-5",
    "max_tokens": 256,
    "messages": [
      {"role": "user", "content": "从这段简历抽取姓名、年限和级别:张三,Java 开发 5 年,可独立负责模块。"}
    ],
    "output_config": {
      "format": {
        "type": "json_schema",
        "schema": {
          "type": "object",
          "properties": {
            "name": {"type": "string"},
            "years_of_experience": {"type": "integer"},
            "level": {"type": "string", "enum": ["初级", "中级", "高级"]}
          },
          "required": ["name", "years_of_experience", "level"],
          "additionalProperties": false
        }
      }
    }
}'国产模型中kimi-k3和qwen3.8-max 均支持 json_schema,DeepSeek、GLM不支持 json_schema,只支持 json_object。
四、程序化校验
到这里你可能会想:既然 json_schema 已经能给出格式完全正确的输出了,是不是就完美解决了结构数据这个问题了呢?
不行。不管是用提示词约束,还是 json_object,又或者是 json_schema,代码校验这一步,都不能省。
用 gpt-5.6、kimi-k3 这类支持 json_schema 的模型,格式错误确实会少很多,但少不等于没有;而 DeepSeek、GLM 这类只有 json_object 的,根本没有强约束,全靠提示词请模型「按格式来」,前面反复讲过,模型对提示词的遵从性并不稳定。这两种情况,最后都得由你的代码来兜底。
更关键的是,就算模型百分百听话,json_schema 本身的表达能力也是有限的。它能规定「level 只能取三个枚举值之一」,但下面这些约束它无法实现:
years_of_experience大于 10 时,level不能是「初级」;status为null时,reason字段必填;- 抽出来的技能标签数组,不能少于 3 个。
这类跨字段、带业务含义的规则,Schema 表达不了,只能写进提示词,而提示词又不可靠。因此,最终能保证数据对的,只有你自己的代码。
代码拿到返回的 JSON 后,第一步是反序列化成对象,比如Java 用 Jackson,Python 用 pydantic。这一步会把字段级错误全部检测出来:少了必填字段、类型对不上、枚举越界,反序列化直接失败抛异常,比手写一组 if (!data.containsKey("name")) 又全又省事。
from pydantic import BaseModel
from enum import Enum

class Level(str, Enum):
    JUNIOR = "初级"
    MIDDLE = "中级"
    SENIOR = "高级"

class Resume(BaseModel):
    name: str
    years_of_experience: int
    level: Level

raw = {"name": "张三", "years_of_experience": "5", "level": "高级"}
resume = Resume.model_validate(raw) # "5" 会被自动转成整数 5字段和类型都对了,第二步才是业务规则校验:拿反序列化出来的对象,用代码把上面那些跨字段约束一条条查一遍。这一步没有捷径,只能逐条用 if 检查。
这里还要留意一类最隐蔽的错误:字段幻觉。格式挑不出毛病,值却是模型编的。比如让它从发票里抽金额,原文根本没写,它给你填了一个表面上合理的数字。对这种字段,校验不能只看「格式对不对」,还得回到原文交叉核对,或者走业务规则(身份证号验校验位、金额对总账)。
五、带反馈的重试
如果代码校验失败,那么,该怎么办?
最省事的做法是原样再调一次。但模型是无状态的,你把一模一样的请求再发一遍,它很可能犯一模一样的错,只会浪费一次调用。
更聪明的办法是带反馈的重试:把模型这次的错误输出、以及代码校验报的具体错误,一并写回对话,让模型根据具体错误再生成一版。这本质上就是一次多轮对话,上一轮的 assistant 消息留着,再追加一条带错误信息的 user 消息。
import json, re
from pydantic import ValidationError

def extract_json(text: str) -> str:
    text = re.sub(r"```(?:json)?", "", text).strip()
    start, end = text.find("{"), text.rfind("}")
    return text[start:end + 1]

def call_with_repair(prompt: str, max_retries: int = 2):
    messages = [{"role": "user", "content": prompt}]
    for attempt in range(max_retries + 1):
        resp = call_model(messages)
        try:
            data = json.loads(extract_json(resp))
            return Resume.model_validate(data)
        except (json.JSONDecodeError, ValidationError) as e:
            if attempt == max_retries:
                raise                        # 到上限还不对,抛出去交给上层兜底
            messages.append({"role": "assistant", "content": resp})
            messages.append({
                "role": "user",
                "content": f"上次输出校验失败:{e}。请只返回合法 JSON,不要任何解释。"
            })
这里有几点需要注意:
- 重试上限必须设置。 模型可能一错再错,没有上限的重试就是没有上限的账单。一般 2 次足够,还不行说明提示词或 Schema 本身有问题,该改的是它们。
- 反馈要具体到错在哪。 直接把代码校验的报错作为下一轮输入,比笼统说一句「你错了」有效得多。模型看到
level 不在枚举内,才知道该改哪个字段。 - 截断不要靠重试勉强应付。 如果
finish_reason是length,那是被max_tokens截断了,重试还会断在同一个地方。正确做法是调大输出上限或精简 Schema。别忘了推理模型的思考过程也占这份配额。 - 重试是兜底,不是常规流程。 能上
json_schema就不要把这套循环当主要手段。它主要用于「提示词约束 +json_object」这类弱约束场景的补救。
如果不想因为重试而导致Token翻倍增加,我们还有一个优化的手段。假设十个字段里九个都对,只有 priority 越界了,没必要整段重来。只针对那一个字段,配上原文重新问一次,既省 Token 又更准,因为这次模型的注意力全在这一个问题上。
本篇小结
09-同步、流式与异步调用
前面几篇我们已经学会了发消息、控制输出、得到结构化结果,但你有没有发现一个问题:只要模型输出稍微长一点,程序就"卡"在那里几秒甚至十几秒,什么都不返回,直到最后一次性全部返回。做离线任务无所谓,可一旦是面向C端用户的产品,这种长时间忙等就是无法接受的。
这一篇我们就来讲模型调用的几种方式:同步、流式、异步。
一、同步调用
我们从第 1 篇开始写的所有代码,其实都是同步调用(Synchronous Call)。你发一个 HTTP 请求过去,然后线程就停在那里等,一直等到模型把全部内容生成完,服务端一次性把完整结果打包返回,你的代码才继续执行。
# 示意代码,接口以官方文档为准
from openai import OpenAI

client = OpenAI()
resp = client.chat.completions.create(
    model="gpt-5.6",
    messages=[{"role": "user", "content": "用三百字介绍一下杭州"}],
)
# 在拿到完整回复前,这一行会一直阻塞
print(resp.choices[0].message.content)
这段代码简单、可靠、好调试,返回的对象里 usage(token 用量)、finish_reason(结束原因)一应俱全,写批处理脚本、内部工具、简单任务(响应比较快)时它就是首选。
但它有个绕不开的问题:对于输出较长的请求,用户要长时间等待。这里要先回顾模块一讲过的一个关键事实:大模型是逐 Token 生成的,它不是一下子想好整段话,而是一个词一个词地逐个生成,前一个 token 是后一个 token 的输入。所以输出越长,生成耗时越久。
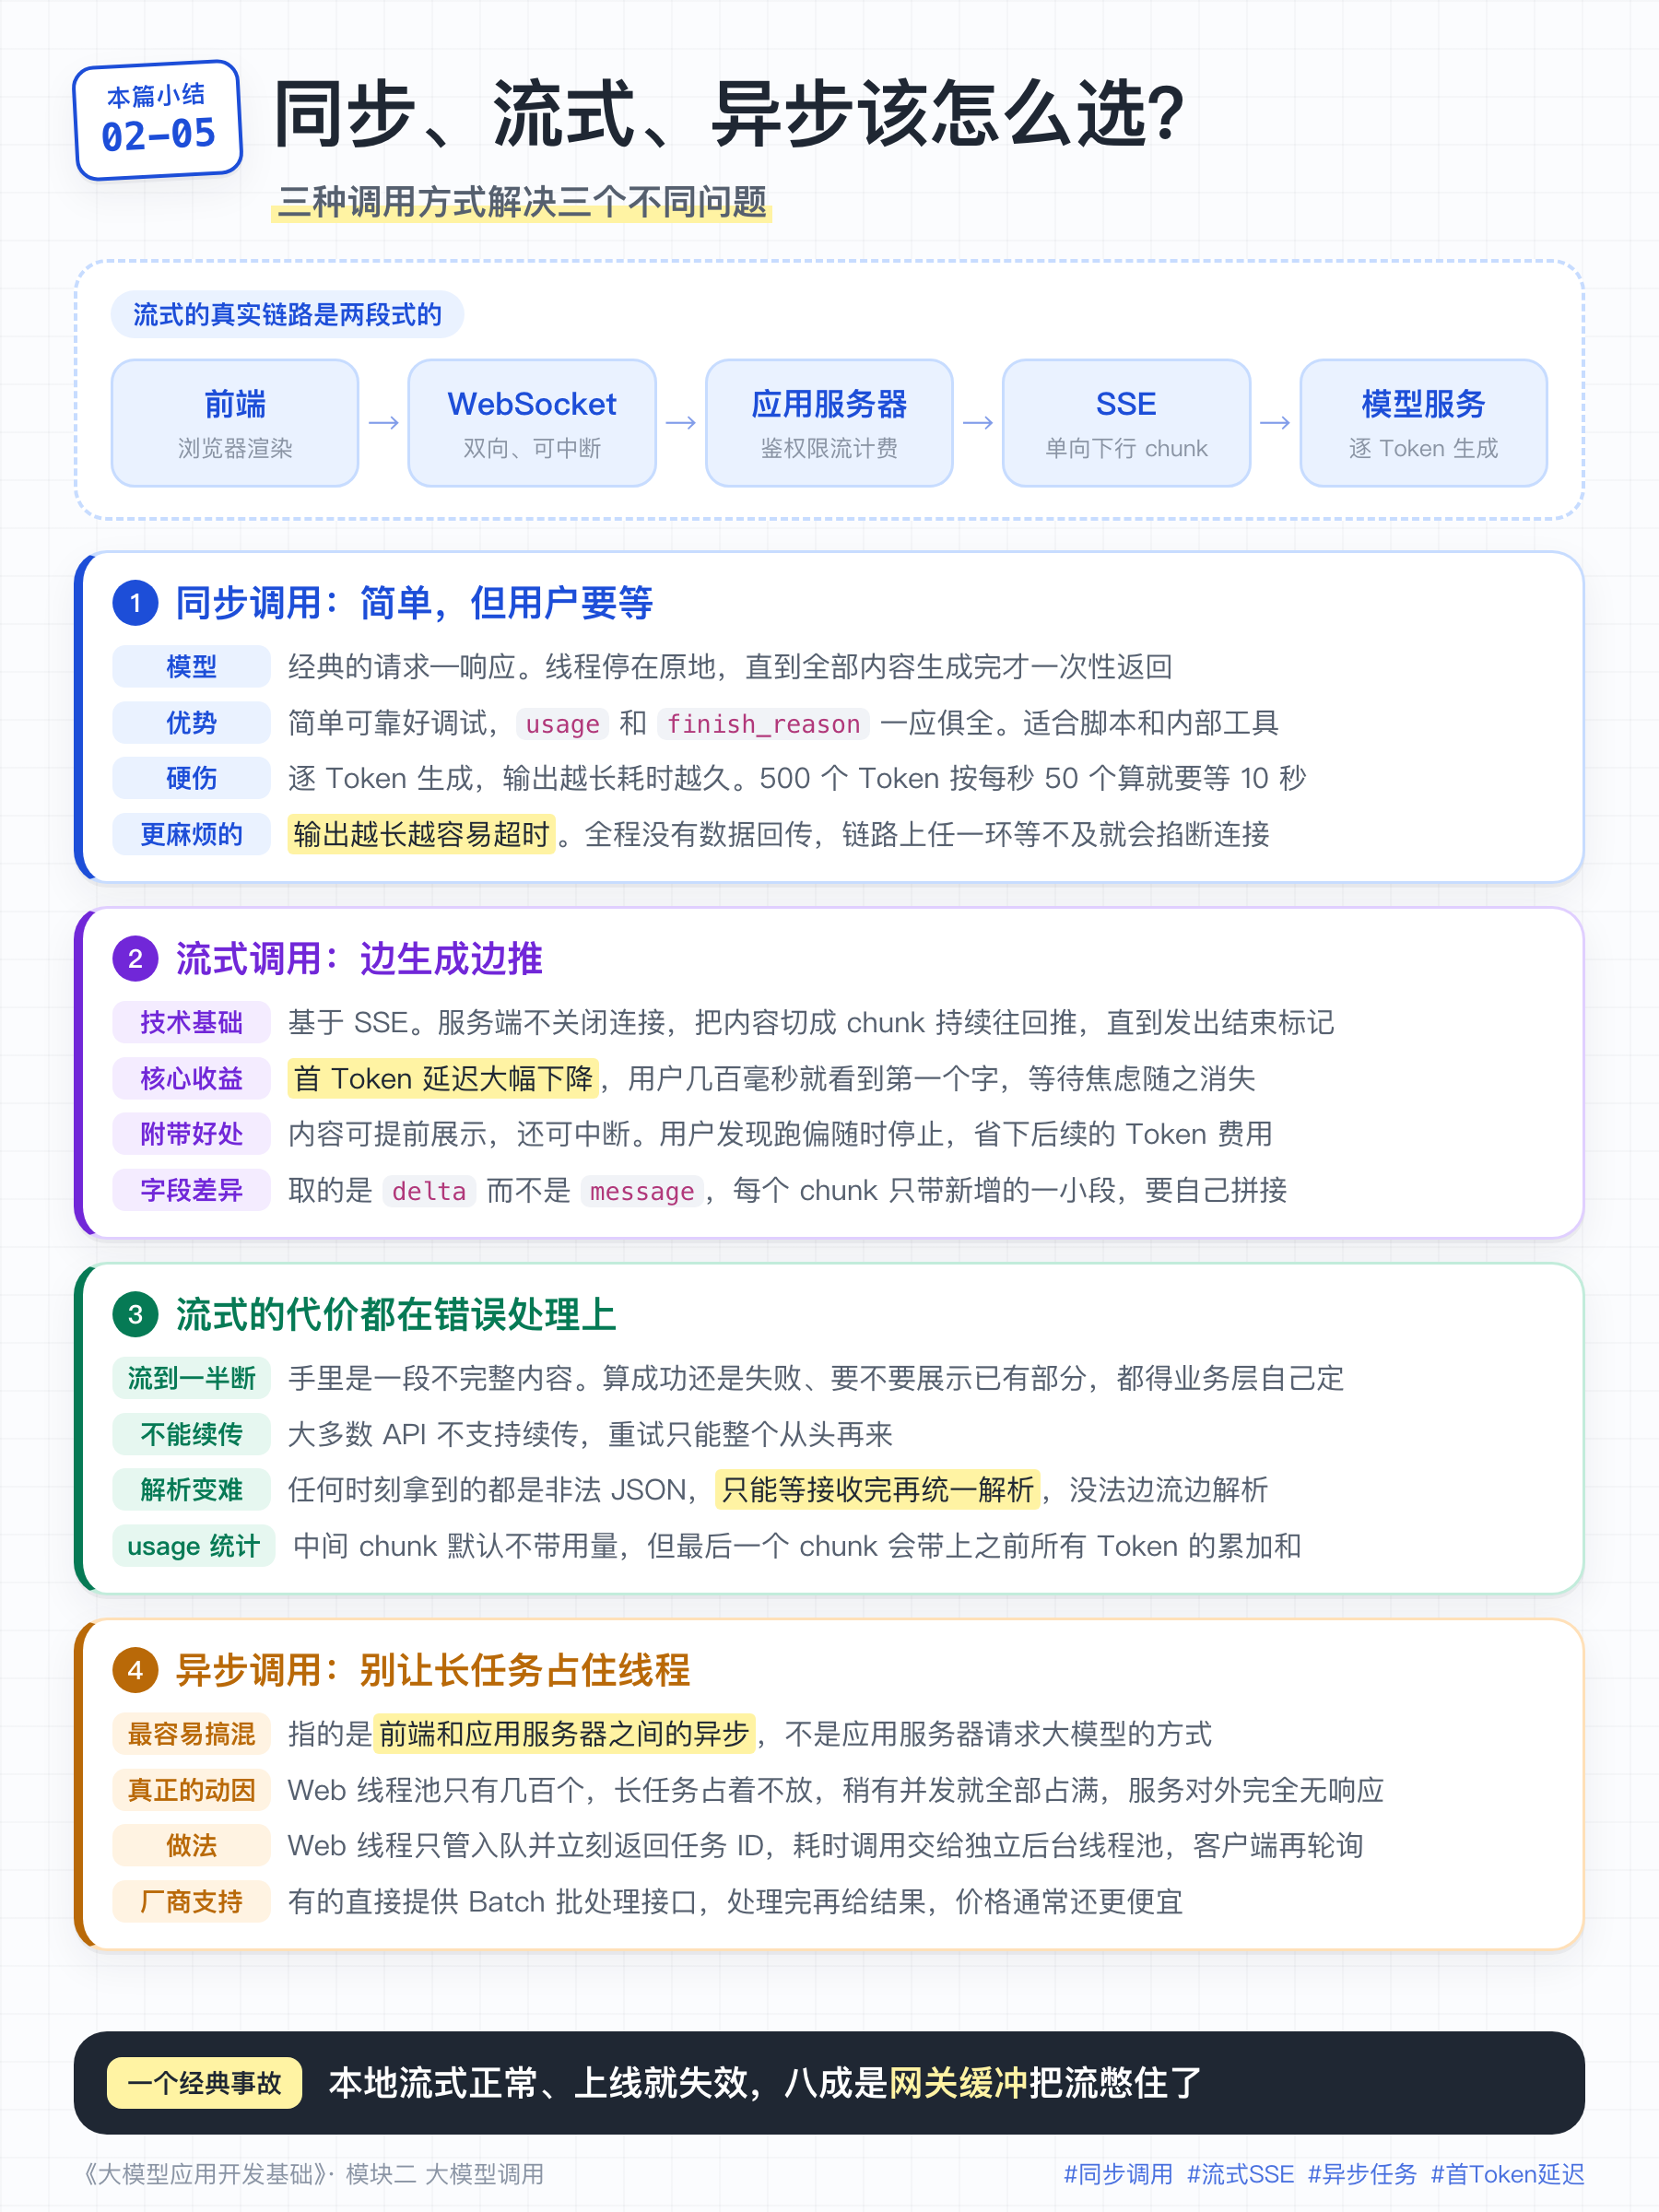
假设模型每秒生成 50 个 token,一段 500 token 的回答,光生成就要 10 秒。同步模式下,用户盯着一个转圈的图标看整整 10 秒,屏幕上什么都没有。这 10 秒里内容其实早就一段段生成出来了,只是被服务端攒着暂时没返回。
而且更糟的是:输出越长,越容易超时。同步调用是一个从头到尾都不回传数据的长连接,中间一直没有任何数据往回传。可这条链路上多处存在超时限制:你代码里 HTTP 客户端的默认超时、中间的反向代理(如 Nginx)、网关、负载均衡器,很多默认就是 30 秒或 60 秒超时。
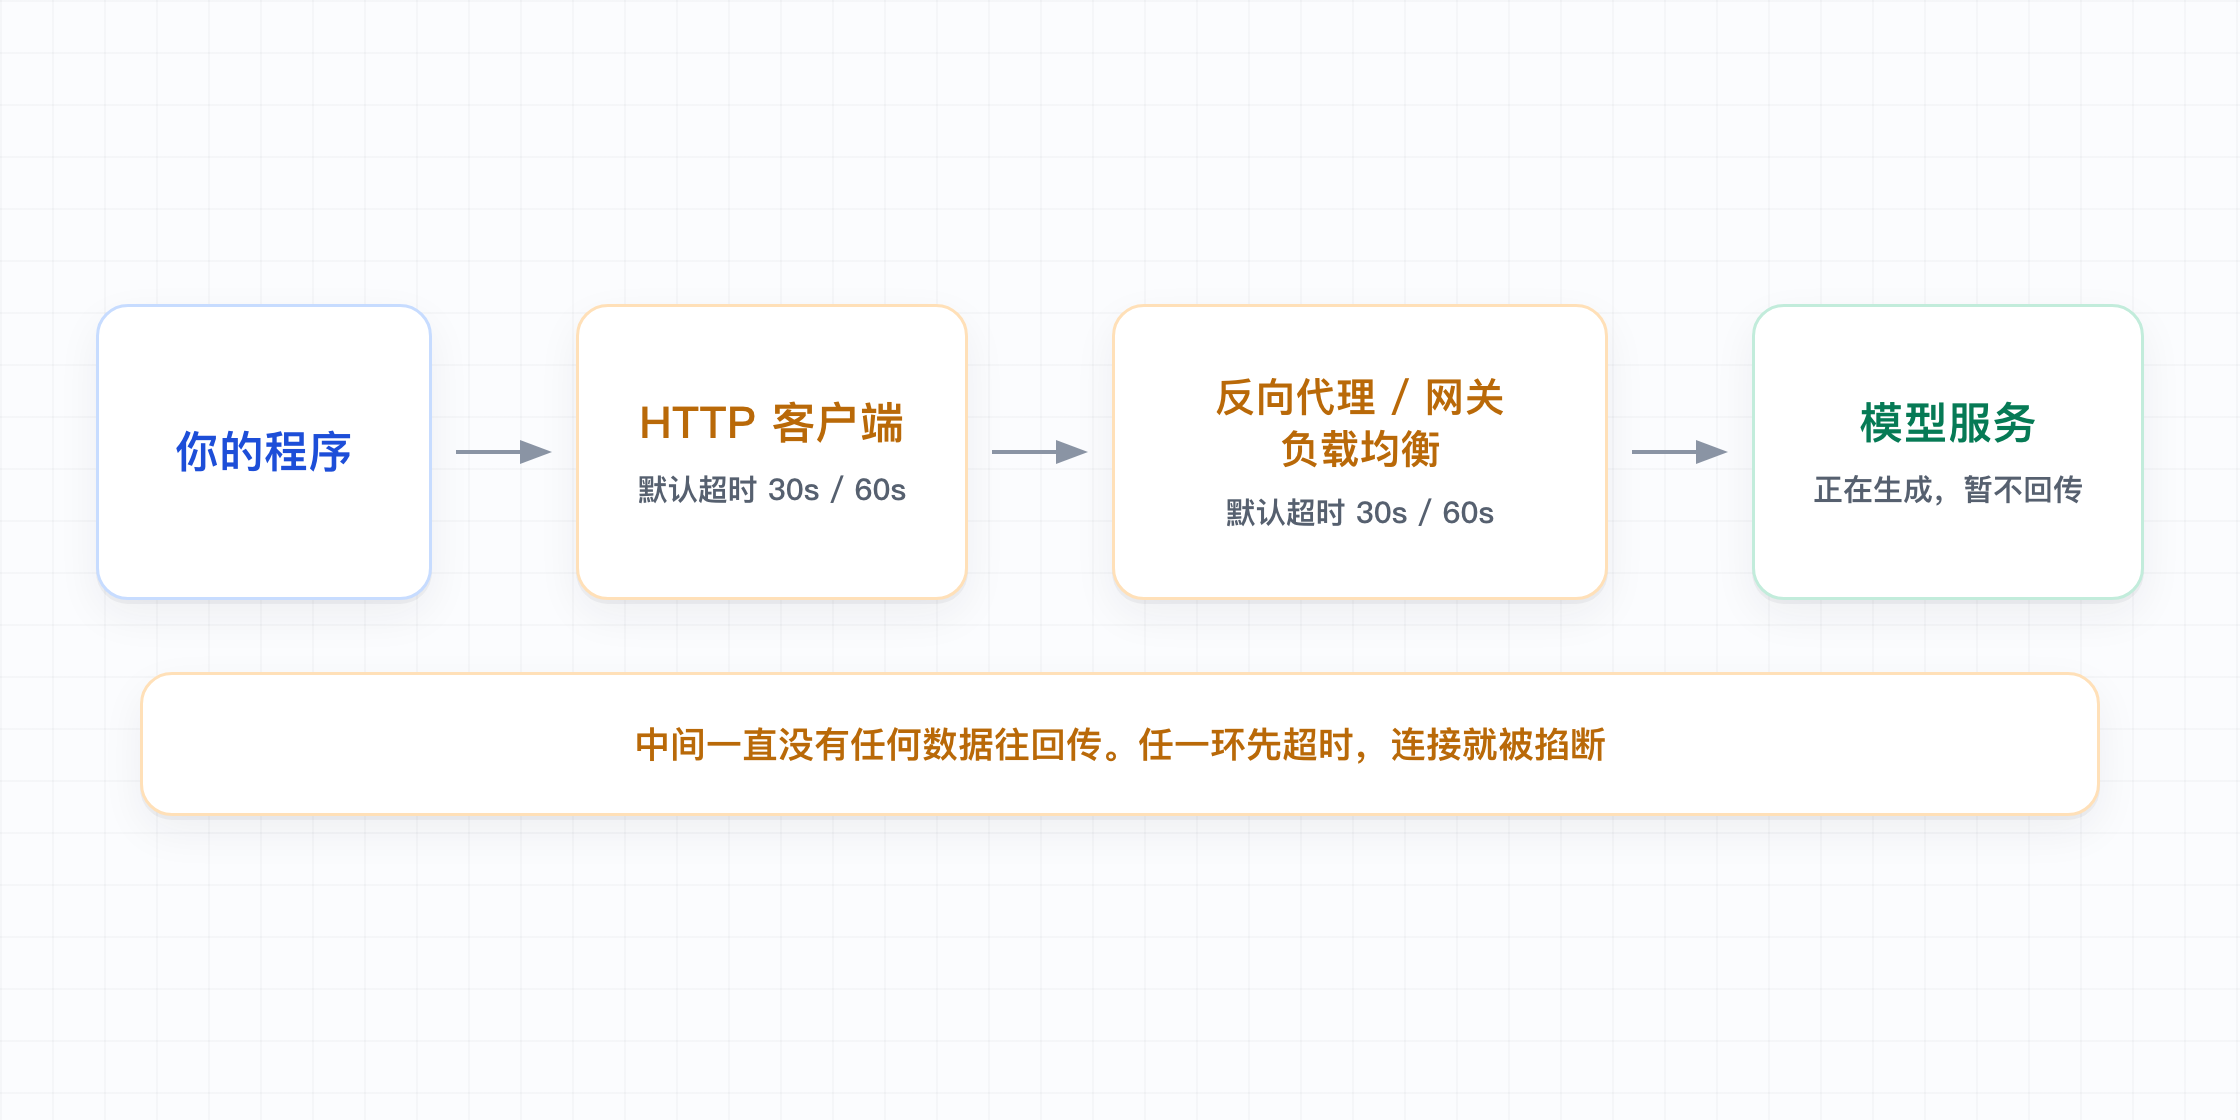
一旦模型要生成一篇长文,几十秒才生成完,链路上任何一环等不及先掐断连接,你这边就直接报超时错误,前面已经生成好的内容也全部丢失了。
正因为这个原因,OpenAI、Anthropic、Google 以及国内的 DeepSeek、Qwen 等厂商,在文档里都会明确提醒:当预期输出较长时,请使用流式调用,用持续不断的数据流让连接保持活跃、不被超时断开,从根本上绕开这类超时。这就引出了下一个方案。
二、流式调用
既然内容是一个个 token 依次输出的,我们就不必等全部生成完再返回,而是生成一点就推一点,这就是 流式调用(Streaming) 的核心思想。
技术上,它通常基于 SSE(Server-Sent Events,服务器发送事件) 实现:客户端发起请求后,服务端不关闭连接,而是把生成的内容切成一个个小片段(称为 chunk,数据块),通过同一个长连接持续往回推,直到大模型生成完成,最后发一个结束标记。
你在 ChatGPT 里看到的"打字机"效果,本质就是前端把这些 chunk 一到就立刻渲染出来。
这里要澄清一个新手常犯的误区:流式并不是"前端直连大模型"。真实产品里链路是分两段的:前端(浏览器)通过 SSE 或 WebSocket 跟你自己的应用服务器通信,应用服务器再通过 SSE 跟大模型服务通信。
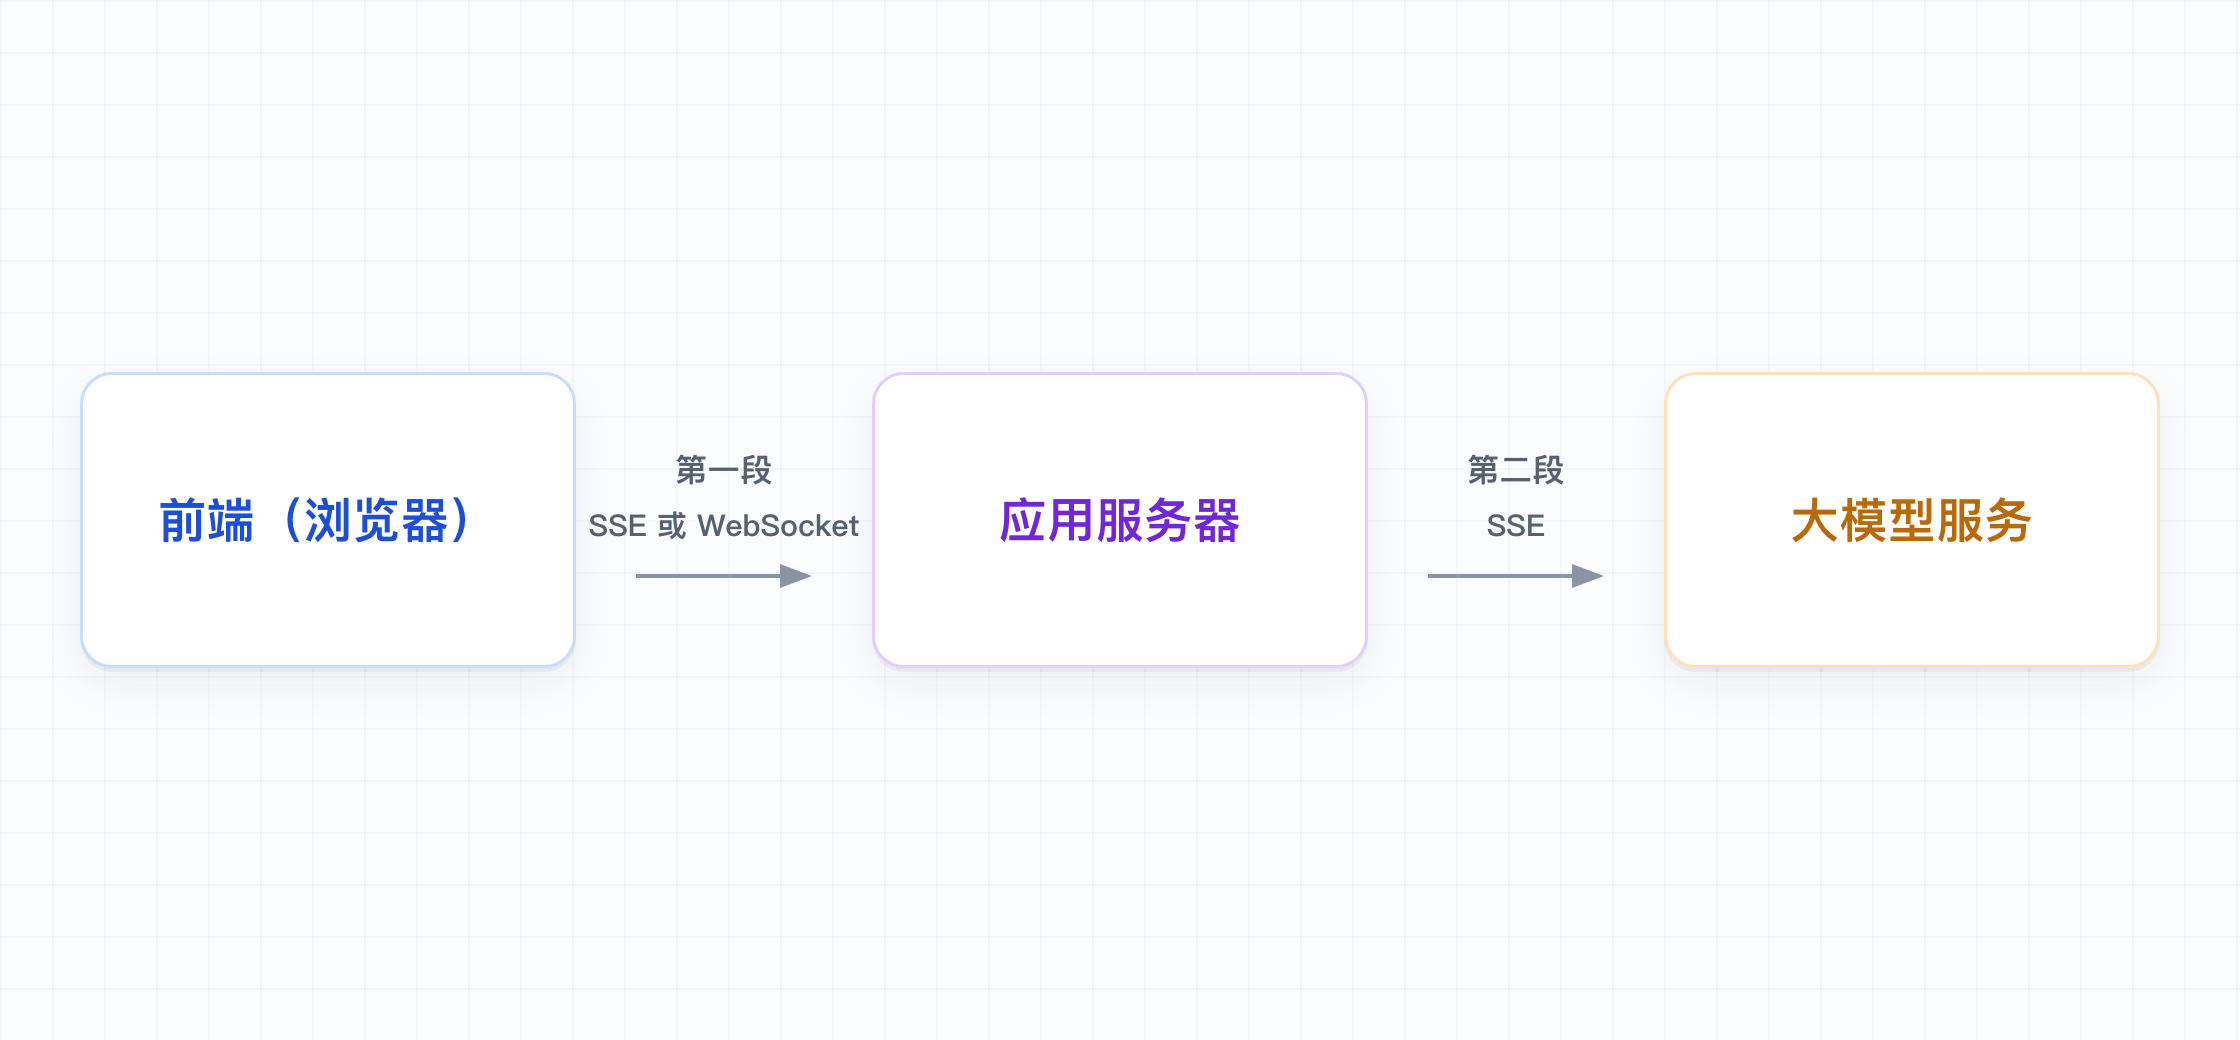
为什么这么分?
一是安全,大模型的 API Key 绝不能下发到前端,必须由应用服务器持有并转发;
二是应用服务器在中间还要做鉴权、限流、计费、敏感词过滤、多轮对话拼接等多项业务逻辑。
至于两段为什么用不同协议:应用服务器调大模型是单向接收下行 chunk,SSE 这种"服务端单向推流"的轻量协议正好够用;而前端和应用服务器之间往往需要双向实时交互(比如用户中途点"停止生成"、发语音、协同编辑),WebSocket 的全双工能力更合适。当然,如果你的场景很简单、只有纯文本单向下发,前端和应用服务器之间直接用 SSE 也完全可以。
在代码里,开启流式后,返回的不再是一个完整对象,而是一个流,你用 for 循环一个个取增量内容:
# 示意代码,接口以官方文档为准
stream = client.chat.completions.create(
    model="gpt-5.6",
    messages=[{"role": "user", "content": "用三百字介绍一下杭州"}],
    stream=True,               # 打开流式开关
    stream_options={"include_usage": True},  # 关键:让最后一个chunk带上usage
)

full_text = ""
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        piece = chunk.choices[0].delta.content   # delta是"增量",只含新增的那一小段
        full_text += piece
        print(piece, end="", flush=True)         # 到一段就立刻打印
注意这里的字段叫 delta(增量)而不是 message,每个 chunk 只带新增的那一小段,需要你自己拼接成完整文本。
流式带来的最大价值是首 Token 延迟(TTFT,Time To First Token)大幅下降。用户在几百毫秒内就看到第一个字出现在屏幕上,感知上"它在思考、在回答",等待感会明显减轻。此外还有两个附带好处:内容可提前展示(用户读前半段时后半段还在生成),以及可中断(用户觉得跑偏了随时点停止,省下后续 token 费用)。
但流式并非没有代价,它把复杂度转移到了错误处理和结果校验上,这也是面试和实战里最容易出问题的地方:
- 流发送到一半失败:同步调用要么成功要么失败,但是,流式可能已经推了 200 个字,第 201 个字时连接断了。这时你手里是一段不完整的内容,到底算成功还是失败?要不要展示已有部分?重试的话是整个重来还是续传(大多数 API 不支持续传,只能重来)?这些都得业务层自己处理。
- 结构化输出边接收边解析比较困难:上一篇讲的 JSON 结构化输出,在流式下会变成片段,任何时刻拿到的都是非法 JSON,没法边接受边解析。常见做法是等接受完所有内容后,再进行解析。
- usage 统计:默认情况下流式响应的中间 chunk 是不带 token 用量的,你没法像同步那样直接读
resp.usage,通常影响不大,最后一个chunk会带上之前所有的token用量累加和。
还有一个环境层面的经典事故必须提醒:流式在本地运行正常,一部署到线上就"失效"了。用户还是要等全部生成完才一次性看到。很可能是**网关/反向代理(如 Nginx)的缓冲(buffering)**导致了这个问题:代理默认会把后端返回的数据攒够一批再转发给客户端,正好把你的流式效果缓冲掉了。解决办法是关掉对应路径的缓冲(Nginx 里设置 proxy_buffering off;,或让后端返回 X-Accel-Buffering: no 响应头)。这个坑不知道的话,排查成本会很高。
三、异步调用
流式解决了"让用户少等"的体验问题,但有些场景根本不需要用户实时盯着看,比如:批量给一万条评论打标签、生成一份长报告、夜里跑一批数据。这类任务的诉求变了,不是"快点让我看到",而是**"别把我的服务器线程占着"**。
这里有一点必须重点强调,否则很容易搞混:这里说的"异步",是前端和应用服务器之间的异步,而不是应用服务器跟大模型服务之间的。也就是说,应用服务器该怎么调大模型还怎么调(同步或流式都行),异步改变的只是"前端不再挂着一条请求死等结果"这件事。前端提交任务后拿到一个任务 ID 就先走了,之后再来查结果。别把它误解成"应用服务器用异步的方式去请求大模型"。
这背后还有一层更关键的服务端考量:在高并发下,绝不能让长任务长期占用请求处理线程(Web 线程)。
要知道,Web 服务器(如 Tomcat、Jetty)用来接请求的线程池是很宝贵且有限的,可能就几百个。如果每来一个长任务就占着一个 Web 线程死等几分钟,那么稍微来一点并发,这几百个线程立刻被占满,后续请求连"被接收"的机会都没有,整个服务直接瘫痪、无法响应。
当单个任务耗时极长(几分钟甚至更久),你不可能让一个 HTTP 请求挂在那里等,用户的浏览器早超时了。正确的做法是:Web 线程只负责"接收请求、把任务塞进队列、立刻返回任务 ID"这种毫秒级的工作,随即被释放去处理下一个请求;真正耗时的大模型调用则丢进任务队列,交给独立的后台线程池慢慢处理,两者互不抢占。客户端再通过 轮询(Polling) 查任务状态,获取处理结果。
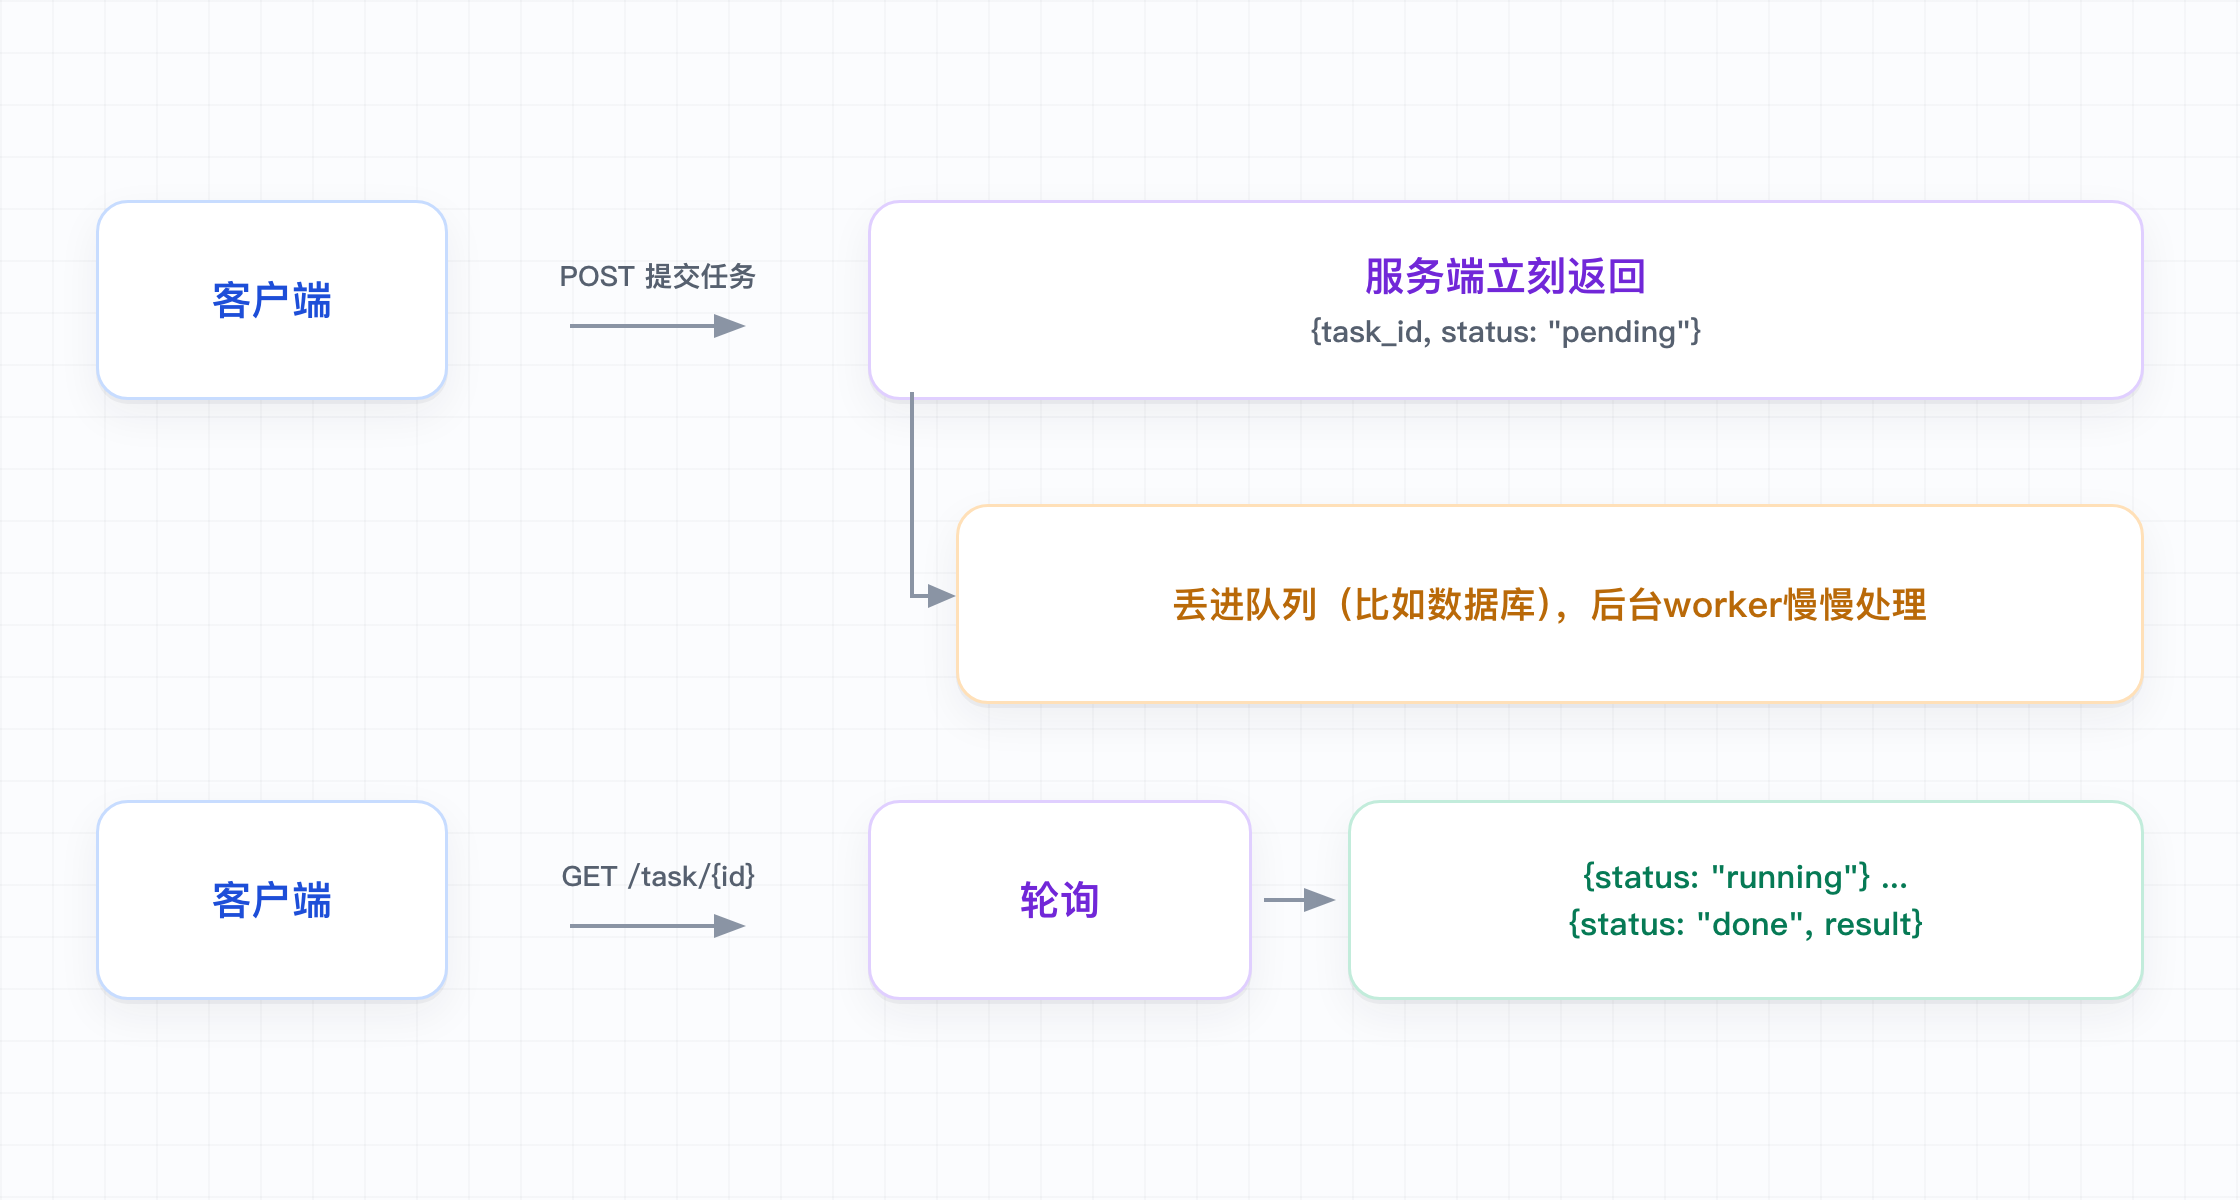
有些大模型厂商甚至直接提供了 Batch(批处理)接口,你把一大批任务打包提交,它异步处理完再给你结果,价格还更便宜。
以 OpenAI 为例。你不是在一个 HTTP 请求里直接塞多个任务,而是先在本地准备一个文本文件:每一行写一条完整的 JSON,对应一次普通的模型调用。这种「一行一条 JSON」的格式叫 JSONL(JSON Lines)。
文件准备好后,先把它上传到厂商的文件接口。上传成功会返回一个文件对象,里面最重要的是 id,类似 file-abc123。接着拿着这个 id,作为 input_file_id 去提交一个批次,等于告诉厂商:「去跑我刚传上去的那份文件」。提交接口立刻返回 batch_id,之后轮询这个 ID 的状态、下载结果即可,不用自己维持一条长时间的 HTTP 连接。Qwen 等国产厂商也有同类接口,路径和字段以各自文档为准。
下面这个 batch.jsonl 只有两行,分别给两条评论打情感标签:
{"custom_id": "cmt-1", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "gpt-5.6", "messages": [{"role": "user", "content": "判断情感:物流很快,包装也严实。"}]}}
{"custom_id": "cmt-2", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "gpt-5.6", "messages": [{"role": "user", "content": "判断情感:等了一周才发货,客服也不回。"}]}}
# 示意,接口以官方文档为准
# 1. 上传 JSONL,purpose 必须是 batch
# 返回里带 "id": "file-abc123",下一步原样填进去
curl https://api.openai.com/v1/files \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-F purpose="batch" \
-F file="@batch.jsonl"
# 2. 把上一步的文件 id 填进 input_file_id,提交批次
# 返回里带 "id": "batch_abc123"
curl https://api.openai.com/v1/batches \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input_file_id": "file-abc123",
"endpoint": "/v1/chat/completions",
"completion_window": "24h"
}'
# 3. 用上一步的 batch_id 轮询状态;completed 后再用 output_file_id 下载结果文件
curl https://api.openai.com/v1/batches/batch_abc123 \
-H "Authorization: Bearer $OPENAI_API_KEY"本篇小结
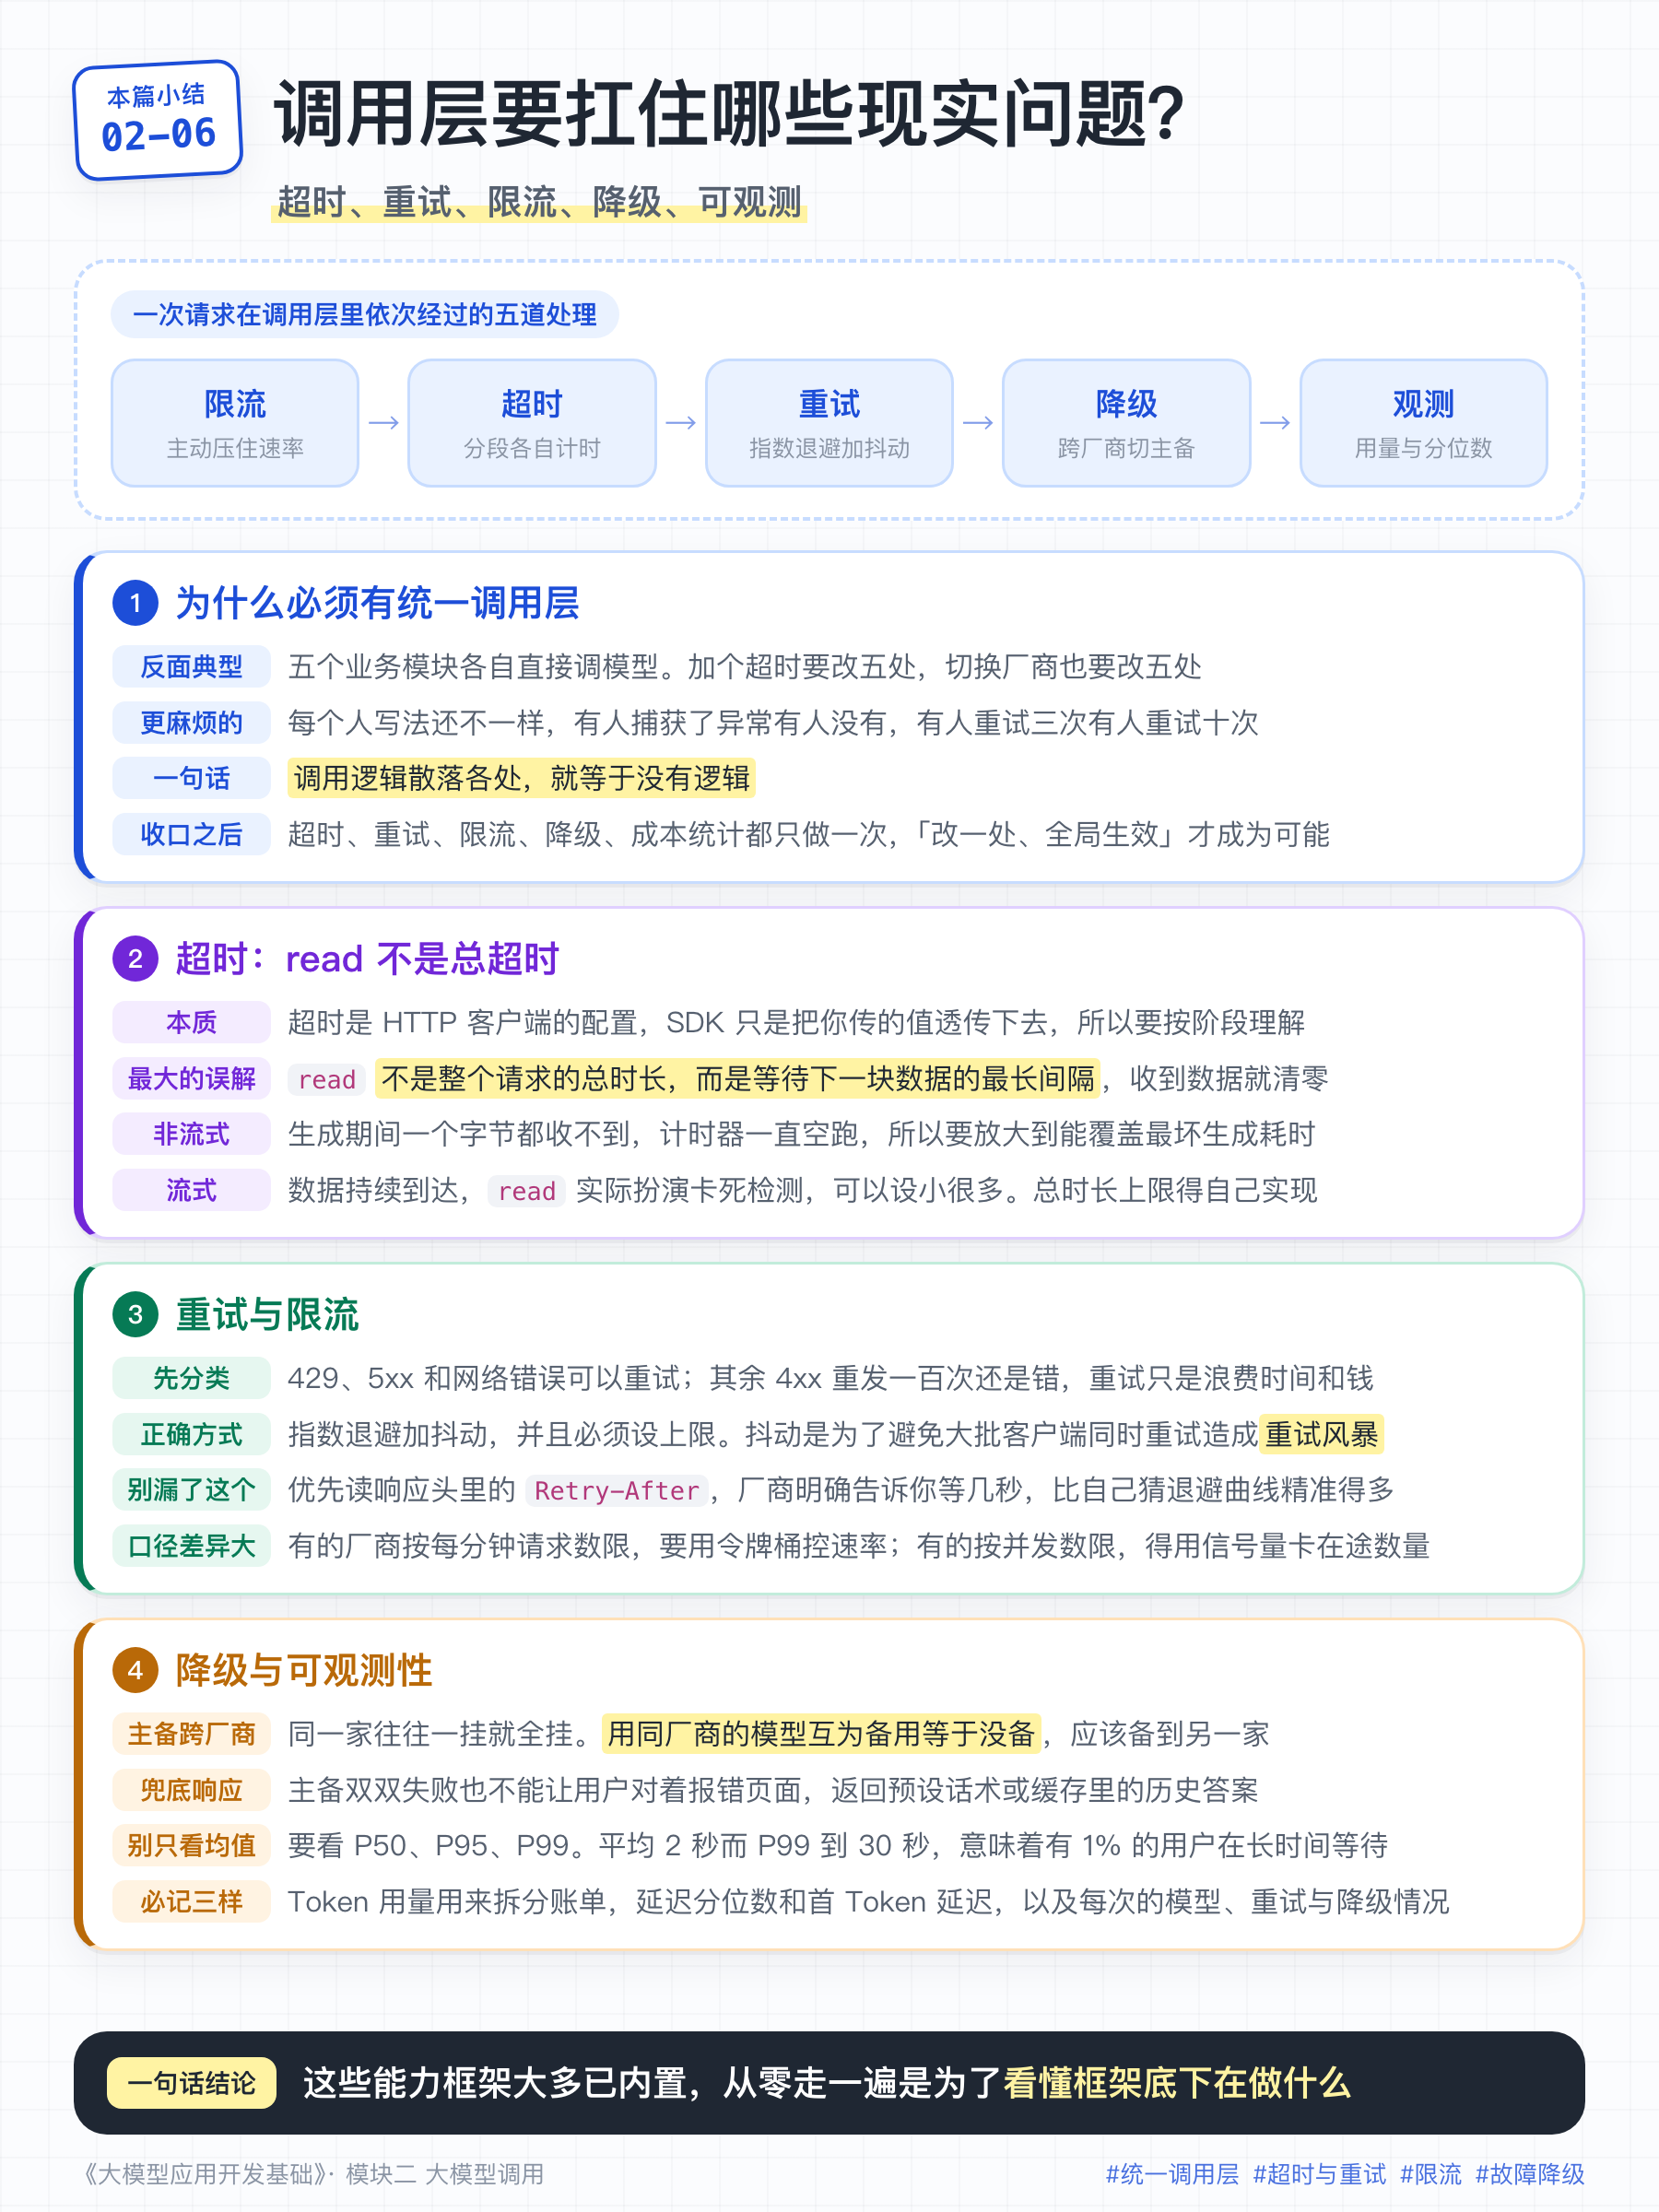
10-构建可靠的模型调用层
前面几篇已经把「怎么调模型」讲完了。发出请求、拿到回复,在本地写一段示例代码,这些都够用。
放到生产环境里,情况就不一样了。模型服务在远端,一次调用常常要跑好几秒。网络会抖动,厂商会限流,服务端会偶发 500,某个区域还会整体不可用。
这一篇我们要在业务代码和模型服务之间,加一层专门负责调用的代码,也就是调用层。业务代码只管「这次要问什么」,超时、重试、限流、降级,都交给这一层统一处理。
一、统一调用层
我们先来看一个典型的反例。项目里通常不止一处要调大模型。客服模块里写一行 client.chat.completions.create(...),摘要模块里再写一行,标签模块里再写一行。本地跑起来没问题,一时也看不出有什么隐患。
等到你要改调用方式,问题就来了。给请求加超时,每个调用的地方都得改一遍。厂商限流了,要加上重试,还是每个地方改一遍。想从通义千问切到 DeepSeek 做成本对比,同样要把所有调用点找出来改掉。
这些地方往往还不是同一个人写的:有的加了 try,有的没有;有的重试三次,有的重试十次。超时设多少、失败要不要重试,项目里其实没有一个统一的规定,只是各写各的。
所以调用层必须做成全项目共用的一处,把所有调用收口到这里。它放在业务代码和模型服务中间:超时、重试、限流、降级、日志、成本统计都在这一层处理,业务模块只需要调用一个函数,把「要问什么」传进去。
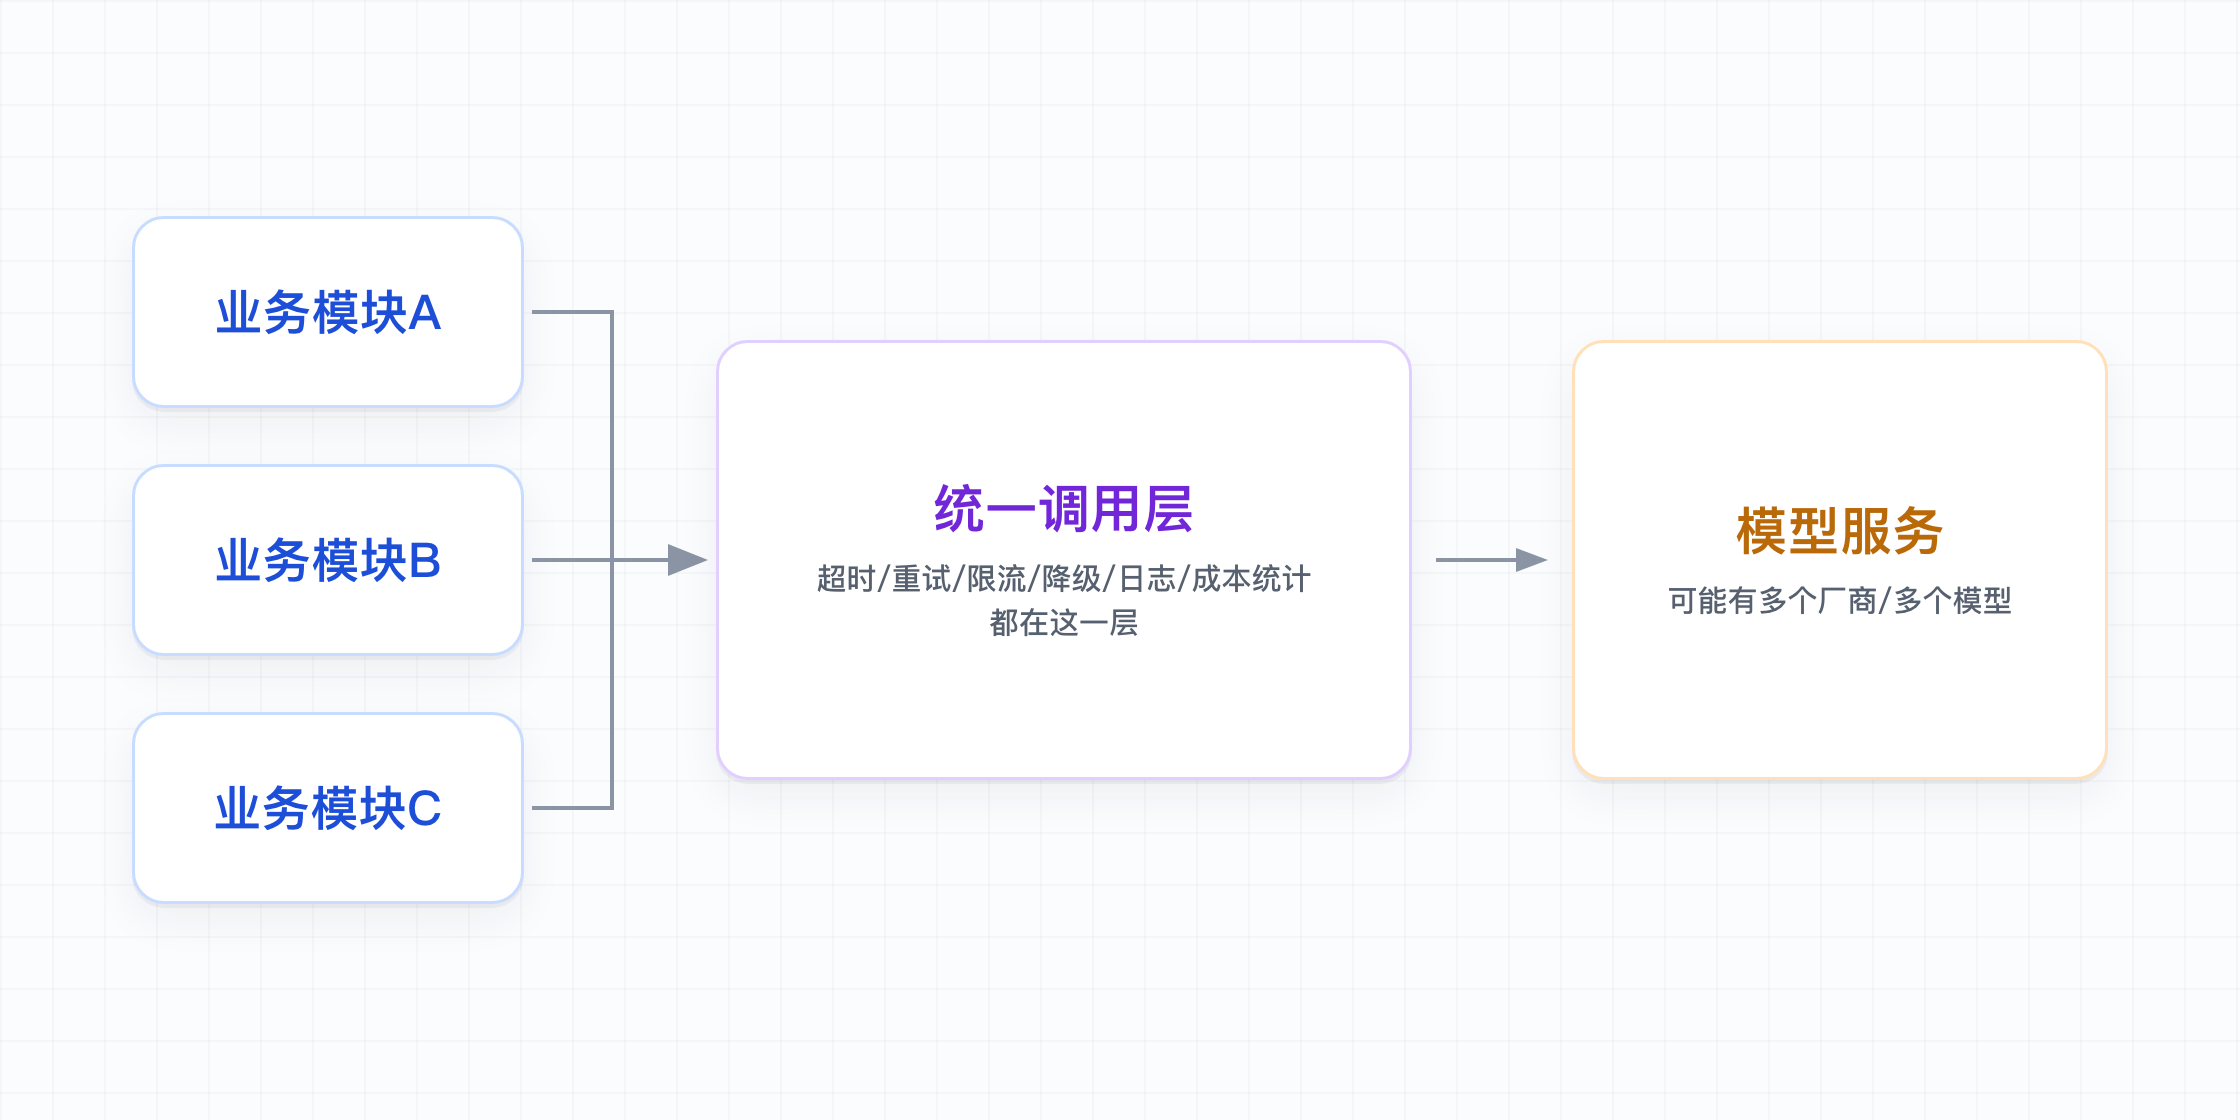
有了统一调用层之后,以后要改超时、加重试、换模型,只改这一层。下面几节就按超时、重试、限流、降级这个顺序,把这些能力一项项加进统一调用层。
二、超时设置
往调用层里加的第一项,是超时(Timeout)。
大模型生成本来就慢,一次请求花几秒到几十秒很正常。如果网络抖动,或者服务端卡住了,而你又没有设超时,这个请求就会一直挂着。
挂着的请求会占住一个线程。请求一多,线程池被占满,整个服务对外就像全部卡死。一个慢接口把整个应用拖垮,这是线上很常见的一类事故。
超时并不是模型的参数,而是 HTTP 客户端的配置。OpenAI、Anthropic 这些官方 SDK 底层都带着一个 HTTP 客户端,Python 里通常是 httpx。你在 SDK 里传的 timeout,最后就是交给这个HTTP客户端去执行。所以要弄清楚超时,得先看 HTTP 客户端把一次请求拆成了哪几段。
以 httpx 为例,它不是只设「一个总超时」,而是按阶段分别计时。跟调用大模型最相关的是这两段:
- 连接超时(Connect Timeout):建立 TCP 连接最多等多久。这个应该短,几秒就够。连不上,说明网络或服务不可用,应该尽快失败。
- 读取超时(Read Timeout):等待下一块数据到来的最长时间,也就是两次收到数据之间的最大间隔。每收到一点数据,这个计时器就清零重来。它不是「整个请求的总时长」,这一点最容易理解错。
正因为读取超时看的是「块与块之间的间隔」,流式和非流式要分开设。
非流式调用里,服务端会等整段内容全部生成完,才一次性把响应体发回来。模型在那几十秒里持续生成的时候,你这边一个字节都收不到,读取计时器会一直走。所以非流式的读取超时必须足够大,要能覆盖最坏情况下一次完整生成要多久,比如 60 秒甚至更长。设短了,一段正常的长回答也会被当成超时打断。
流式调用则相反。数据是一个 Token 一个 Token 往回推的,正常情况下每隔几十到上百毫秒就有新数据到,读取计时器会频繁清零,根本不会触发超时。这时候读取超时的作用,是检测流是不是卡住了:只有当很长时间没有任何新数据,比如服务端卡死、连接假死,才会触发。所以流式的读取超时可以设得比非流式小,比如 15 到 30 秒。这样能把真的卡住的请求断掉,又不会把一段正在正常输出、只是内容比较长的流误判成超时。
还有一个常见问题:流式有没有「总超时」?httpx 这类客户端本身不提供对整条流的总时长限制,它只管上面说的块间间隔。这样是合理的,因为一条健康的流本来就可能持续输出好几分钟。
如果你的业务确实需要给一整次流式调用加上总时长上限,比如最长不超过 5 分钟,那就得自己在代码里做,不能指望读取超时。常见做法是记下开始时间,在 for chunk in stream 的循环里检查有没有超过截止时间,或者用 asyncio.wait_for 给整个流式过程包一层 deadline。
import httpx

# 超时是 HTTP 客户端的配置,SDK 只是把它透传下去。
# 注意:read 不是"总超时",而是"两块数据之间的最长间隔"。
# - 非流式:生成期间一直收不到数据,read 要覆盖最坏的完整生成耗时
# - 流式:数据持续到达,read 只用来检测"流卡死",可以设小一些
timeout = httpx.Timeout(connect=5.0, read=60.0, write=10.0, pool=5.0)

# 若还想给"一整次流式调用"加总时长上限,HTTP 客户端不管这事,得自己实现:
import time
deadline = time.time() + 300          # 整条流最长 5 分钟
for chunk in stream:
    if time.time() > deadline:
        raise TimeoutError("流式总时长超限")   # 主动中断
    ...  # 正常处理 chunk
三、重试
超时能把挂死的请求断掉,但断掉之后,这次调用还是失败了。限流、偶发 500、网络抖动这类问题,再发一次往往就能恢复,所以调用层还要会重试。
这里说的重试,发生在「应用服务器 → 大模型服务」这一段。调用层发现发给模型的那次 HTTP 请求失败了,就自动再发一次。它和「前端 → 应用服务器」无关,前端不用知道底下重试了几次,只等最终结果就行。
重试之前,先要分清这个错误该不该重。不问原因、失败了立刻反复重发,只会把故障放大,多花一笔调用费用。服务端如果本来在恢复,过量重试还可能把它再次压垮。
一类是可重试的错误,共同特征是重发一次很可能就好了:
429 Too Many Requests:触发了限流,稍等再试大概率能成功。5xx服务端错误(500 / 502 / 503):服务端临时异常。- 网络层错误:连接超时、读取超时、连接被重置。
另一类是不可重试的错误,重发多少次都不会好:
4xx客户端错误(429 除外):比如400参数写错了、401鉴权没过、404模型名不存在。这些是请求本身的问题,重试只会浪费时间和费用。
该重试的错误,失败后也不要立刻重发。正确做法是指数退避加抖动,并且设一个重试上限。
指数退避是指每次重试的等待时间成倍增长,比如 1 秒、2 秒、4 秒,给服务端留出恢复时间。抖动是在这段等待时间上再加一个随机量,避免大批客户端在同一时刻一起重试,形成重试风暴,把刚恢复的服务端再次压垮。
重试次数也要有上限,一般 2 到 3 次就够。超过就停止,把失败返回给业务代码。
底层的 HTTP 客户端,默认几乎不会替你重试业务错误。httpx 的 retries 只在连接还没建立起来时才生效,对 429、500 这类已经连上、但服务端返回了错误的请求根本不会重试。requests 底下的 urllib3 可以配一个 Retry 对象按状态码重试,但也要你自己打开。
官方 SDK 就不一样了。OpenAI、Anthropic 这些 SDK 大多自带重试,默认就会对 429、5xx、网络错误自动重试 2 次,并且带了指数退避。次数用 max_retries 就能改:
# 示意代码,接口以官方文档为准
from openai import OpenAI

# SDK 层自带重试:这里配成最多重试 3 次
client = OpenAI(max_retries=3)
日常场景用 SDK 自带的这套就够。只有 SDK 做不到你要的事情时,才值得在调用层里再包一层。
四、限流
在生产里,你遇到的 429 有一大半根本不是服务端异常,而是你自己调用过于频繁,触达了厂商的限流(Rate Limiting)。
厂商为什么要限流?很简单:GPU 是稀缺资源,它得在所有客户之间公平分配,不能让某一个客户端独占全部算力。所以每家都会给你的账号设配额上限。不同厂商的限流方式差别很大,绝不能拿一套参数套所有平台。
笼统地,我们可以把限流方式分为三类。
第一种,按「每分钟」限,也是最主流的一种:RPM + TPM 双维度。「RPM」是每分钟请求数(Requests Per Minute),「TPM」是每分钟 Token 数(Tokens Per Minute,输入输出都算)。这俩是「或」的关系,任意一个超了就触发 429。
国内的通义千问(Qwen) 就是典型:在阿里云百炼平台上,qwen3.8-max 这类主力模型的额度约为 RPM 30000、TPM 500 万,而且限流是按主账号 + 模型统一算的,你名下所有 API Key、所有业务的调用量是合并计数、共享这一份额度的。
第二种,完全不按「每分钟」限,而是按「并发数」限。 这是 DeepSeek 官方 API 的做法。
DeepSeek 不看你一分钟发了多少个请求,只看你同一时刻有多少个并发请求(从请求发出到响应完成,算占用一个并发连接)。它给的额度大致是:deepseek-v4-pro 500 并发、deepseek-v4-flash 2500 并发,同样是账号级共享,超了返回 429。
这个差异直接决定了限流器怎么写:对 Qwen 你要控「每分钟的速率」,对 DeepSeek 你要控「在途请求的数量」,前者用令牌桶,后者用信号量(Semaphore)。
第三种,按「账号等级」阶梯放开:用量分层(Usage Tier)。 国外的 OpenAI、Anthropic(claude-sonnet-5) 走的是这条路:账号按累计消费划成 Tier 1 到 Tier 5,等级越高,每个模型的 RPM/TPM 上限越大。新号一开始额度很小,很容易一测试就触达上限,得靠持续消费或预充值提升等级,额度才会随之提高。
看懂了这三种限流方式,应对策略其实是共通的,核心就八个字:主动限速 + 被动退避。
主动限速:别等返回了 429 再说,而是在调用层里放一个限速器,把请求速率主动压在额度以内,从源头减少 429。用哪种限速器,取决于上面是哪种限流方式。按 RPM/TPM 限的(如 Qwen)用令牌桶(Token Bucket)控制速率,按并发限的(如 DeepSeek)用信号量卡在途数量。高并发场景下,还可以在前面加一个排队(Queue):请求先入队,由固定速率的消费者匀速发出,既不超限,又能削峰填谷。
被动退避:主动限速只能压低429的概率,真返回了 429 还得退避重试(就是第三节那套指数退避)。但这里有个很多人漏掉的关键细节:优先读响应头里的 Retry-After。厂商往往会明明白白告诉你「再等 N 秒再重试」,直接按它给的时间等,远比自行估算的退避时间精准。
最后补一个降本增效技巧:如果任务不赶时间(离线打标、批量总结),优先走批处理(Batch)接口。像 Qwen 用 Batch API 提交的任务完全不占 RPM/TPM 限流额度,价格通常还更便宜。用它跑批量任务,等于避开了限流限制。
五、模型路由与故障降级
厂商机房会宕机、某个区域会网络中断、某个模型版本会被临时下线,你把重试、退避写得再漂亮也没用。
这时候需要的是另一套思路:模型路由(Model Routing)与故障降级(Fallback / Graceful Degradation),核心是不要只依赖单一厂商或单一模型。
先说模型路由,它其实是把「选哪个模型」这件事从业务代码里收进调用层,按请求的实际需要动态分配。
最实用的一条原则是按任务难度选模型,别动辄就上最贵的:一个「判断评论是好评还是差评」的简单分类,用便宜快速的小模型(比如 gpt-5.6-luna、deepseek-v4-flash)几毫秒即可完成,非要调 gpt-5.6 这种旗舰版本属于过度配置、成本过高;只有真正需要复杂推理、长文写作的请求,才把它路由到强模型上。
再说故障降级,通常分两级:
- 主备模型:给关键链路配一个备用模型,而且强烈建议来自不同厂商。因为同一家厂商往往一挂就是全挂,你拿
gpt-5.6做备用gpt-5.6-luna,OpenAI 一旦区域故障,两者会一起不可用,等于没有备用。正确做法是主用gpt-5.6、备用切到国产的qwen3.8-max或deepseek-v4-flash,一家出事立刻换另一家,从根上避免单点故障。 - 兜底响应:万一主备都失败,也不能只给用户返回一个 500 页面。这时返回一个预设的兜底话术(「服务繁忙,请稍后再试」)、走规则引擎的简单应答,或者干脆返回缓存里的历史答案,核心是保证链路不断、用户体验仍可接受。
六、统一调用接口
上一节说,主模型和备用模型最好来自不同厂商。可各家的调用方式并不一样,业务代码如果直接调某一家的原生接口,切换备用时就得把调用代码重写一遍。
OpenAI 用 chat.completions,消息放在 messages 里;Anthropic 的 Claude 虽然也叫 messages 接口,但系统提示要单独作为字段传入,返回结构也不一样;国产平台又各有各的 SDK 和字段。
业务代码一旦按其中一家来写,就和这家绑在一起了。以后要加备用厂商,或者整体迁到另一家,调用代码就得重写。
所以调用层还要再做一件事:对上只暴露一套与厂商无关的接口,比如 chat(messages, model);对下由内部的适配器,把这套统一格式翻译成各家的原生请求,再把各家的原生响应翻译回统一的结果。这样,换厂商、加备用,就变成多写一个适配器,业务代码不用改。
实际做的时候,适配工作往往没有想象中那么多。OpenAI 的 API 格式已经是行业里最常见的写法,DeepSeek、Qwen、GLM、Kimi 等国产平台大多提供了「OpenAI 兼容模式」。很多时候你不用自己写适配器,直接用官方 OpenAI SDK,改一下 base_url、api_key 和模型名就行。
# 示意代码,接口以官方文档为准
from openai import OpenAI

# 还是那套 OpenAI SDK,仅靠改 base_url 就切到了国产厂商
client = OpenAI(base_url="https://api.deepseek.com", api_key="...")
resp = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[{"role": "user", "content": "你好"}],
)
这能省掉一大半适配工作,但这通常只覆盖最基础的对话补全。一旦用到工具调用(Function Calling)、结构化输出、思考过程(reasoning_content)、多模态这些能力,各家的字段和用法又不一样了。走兼容接口无法使用这些特性。所以「统一按 OpenAI 的写法来接」能少写很多适配代码,却不能让适配层完全消失。
七、可观测性
线上的模型调用本质是个黑盒,你发出去、它给你回来,中间快了慢了、贵了省了,如果不主动记录,出了问题你就只能靠猜。所以必须主动采集指标和日志。这就是可观测性(Observability)。
具体来说,有三样东西每次调用都必须记录:
Token 用量(usage):每次调用都记下 prompt_tokens(输入)和 completion_tokens(输出)。不记的话,月底账单一来,你根本搞不清这几千块钱到底是客服模块消耗的、还是那个批量总结任务消耗的,更没法按模型、按业务去优化。
延迟(Latency):这里有个新手最爱踩的坑:只看平均值。你真正要看的是分位数 P50 / P95 / P99(意思是 50% / 95% / 99% 的请求都比这个值快)。很可能平均值 2 秒,P99 却已经达到 30 秒。这意味着有 1% 的请求延迟达到了半分钟。
另外,流式场景下还要特别关注一个指标:首 Token 延迟(TTFT,Time To First Token),它直接决定了用户「点下发送后,等了多久才看到第一个字出现」,是流式体验优化的关键。
调用日志记录:每次调用还要记下这次用的哪个模型、重试了几次、有没有触发降级、最终是成功还是哪一类失败。有了这些,你才能回答「最近降级频率是不是变高了」「gpt-5.6 是不是最近特别容易超时」这类问题。
本篇小结