01 | 大模型概述
01 | 大模型概述
01-人工智能到大模型发展历史
假设现在是2019年,你跟别人说“未来会有一个AI,能跟你聊天、帮你写代码、甚至自己操作电脑”,对方大概率会觉得你在说科幻电影。但到了今天,这些事每天都在真实发生。
从只能回答固定问题的“人工智障”,到能跟你谈笑风生的ChatGPT,再到能自己打开浏览器查资料、自己写代码修Bug、甚至自己操作鼠标键盘完成一整套任务的OpenClaw,用了不超过十年的时间。
当然,这十年突飞猛进的发展,是站在之前几十年、上百年的人工智能的发展之上的。为了让你更好的理解大模型发展的历史,今天这篇文章,我们就回顾从人工智能开始,到机器学习、深度学习、再到生成式AI、大模型、ChatGPT、Agent(如Claude Code编程助手、OpenClaw)的整个发展历程。
一、人工智能
先回答一个最基础的问题:人工智能到底是什么?
说白了,就是让机器做出像人一样智能的行为。但「智能」这个词太虚了,不同时代的人对它的理解完全不一样。
1950 年,计算机科学之父图灵提出了一个思想实验——图灵测试:如果一台机器能在对话中让人分辨不出它是人还是机器,那这台机器就可以被认为是「智能」的。
那一代人想得很简单:智能嘛,不就是逻辑推理吗?我把规则一条条写给机器,机器不就聪明了?
典型成果是 1997 年 IBM 的「深蓝」击败国际象棋世界冠军卡斯帕罗夫。但它的本质是暴力穷举棋谱,加上人工设计的评估函数,并不真的「懂」下棋。
这种做法的问题是什么?太死板了。 你写了几百条规则,遇到规则外的情况就直接傻眼。而且很多东西,根本没法用几条规则描述清楚。
二、机器学习
于是大家换了个思路,提出了一个听起来朴素、但极其重要的观点:既然规则写不完,能不能让机器从大量例子里自己总结规则?
这就是机器学习。一句话总结它的本质:
不再把「规则」写给机器,而是把「题目 + 标准答案」一起喂给机器,让它自己找规律。
举个最经典的例子:垃圾邮件分类。
在「规则时代」,你想识别垃圾邮件,得手动写关键词,比如「免费」「中奖」「点击链接」。结果骗子把「免费」写成「免~费」,或者换个话术,你的规则就报废了。
用机器学习怎么做?你先准备一万封邮件,每封都提前人工标好标签:「这是垃圾」或「这不是垃圾」。然后把每封邮件拆解成计算机能算的特征:这封邮件里有多少个感叹号?是否含「汇款」这个词?发件人是不是在通讯录里?
这些特征密密麻麻排在一起,就形成了一个向量,也就是一个长长的数字列表,相当于这封邮件的「数学指纹」。
接下来,把这一万个「数学指纹」和它们对应的标准答案,一起丢给一个算法(比如朴素贝叶斯或逻辑回归,知道有这么回事就行)。
算法就像一个笨拙的学生,拿着这些数据反复计算,不断调整自己内部的权重参数。它的目标很简单:找到一条数学分界线,让「垃圾」和「正常」这两堆向量离得尽可能远。
训练完成后,再来一封新邮件,算法把它转成向量往坐标系里一扔,看它落在分界线的哪一边,就能瞬间判断。
注意这里的关键差别:程序员没有写任何「如果包含『中奖』就是垃圾邮件」这样的规则,规则是机器从那一万封样本里自己「悟」出来的。
三、深度学习
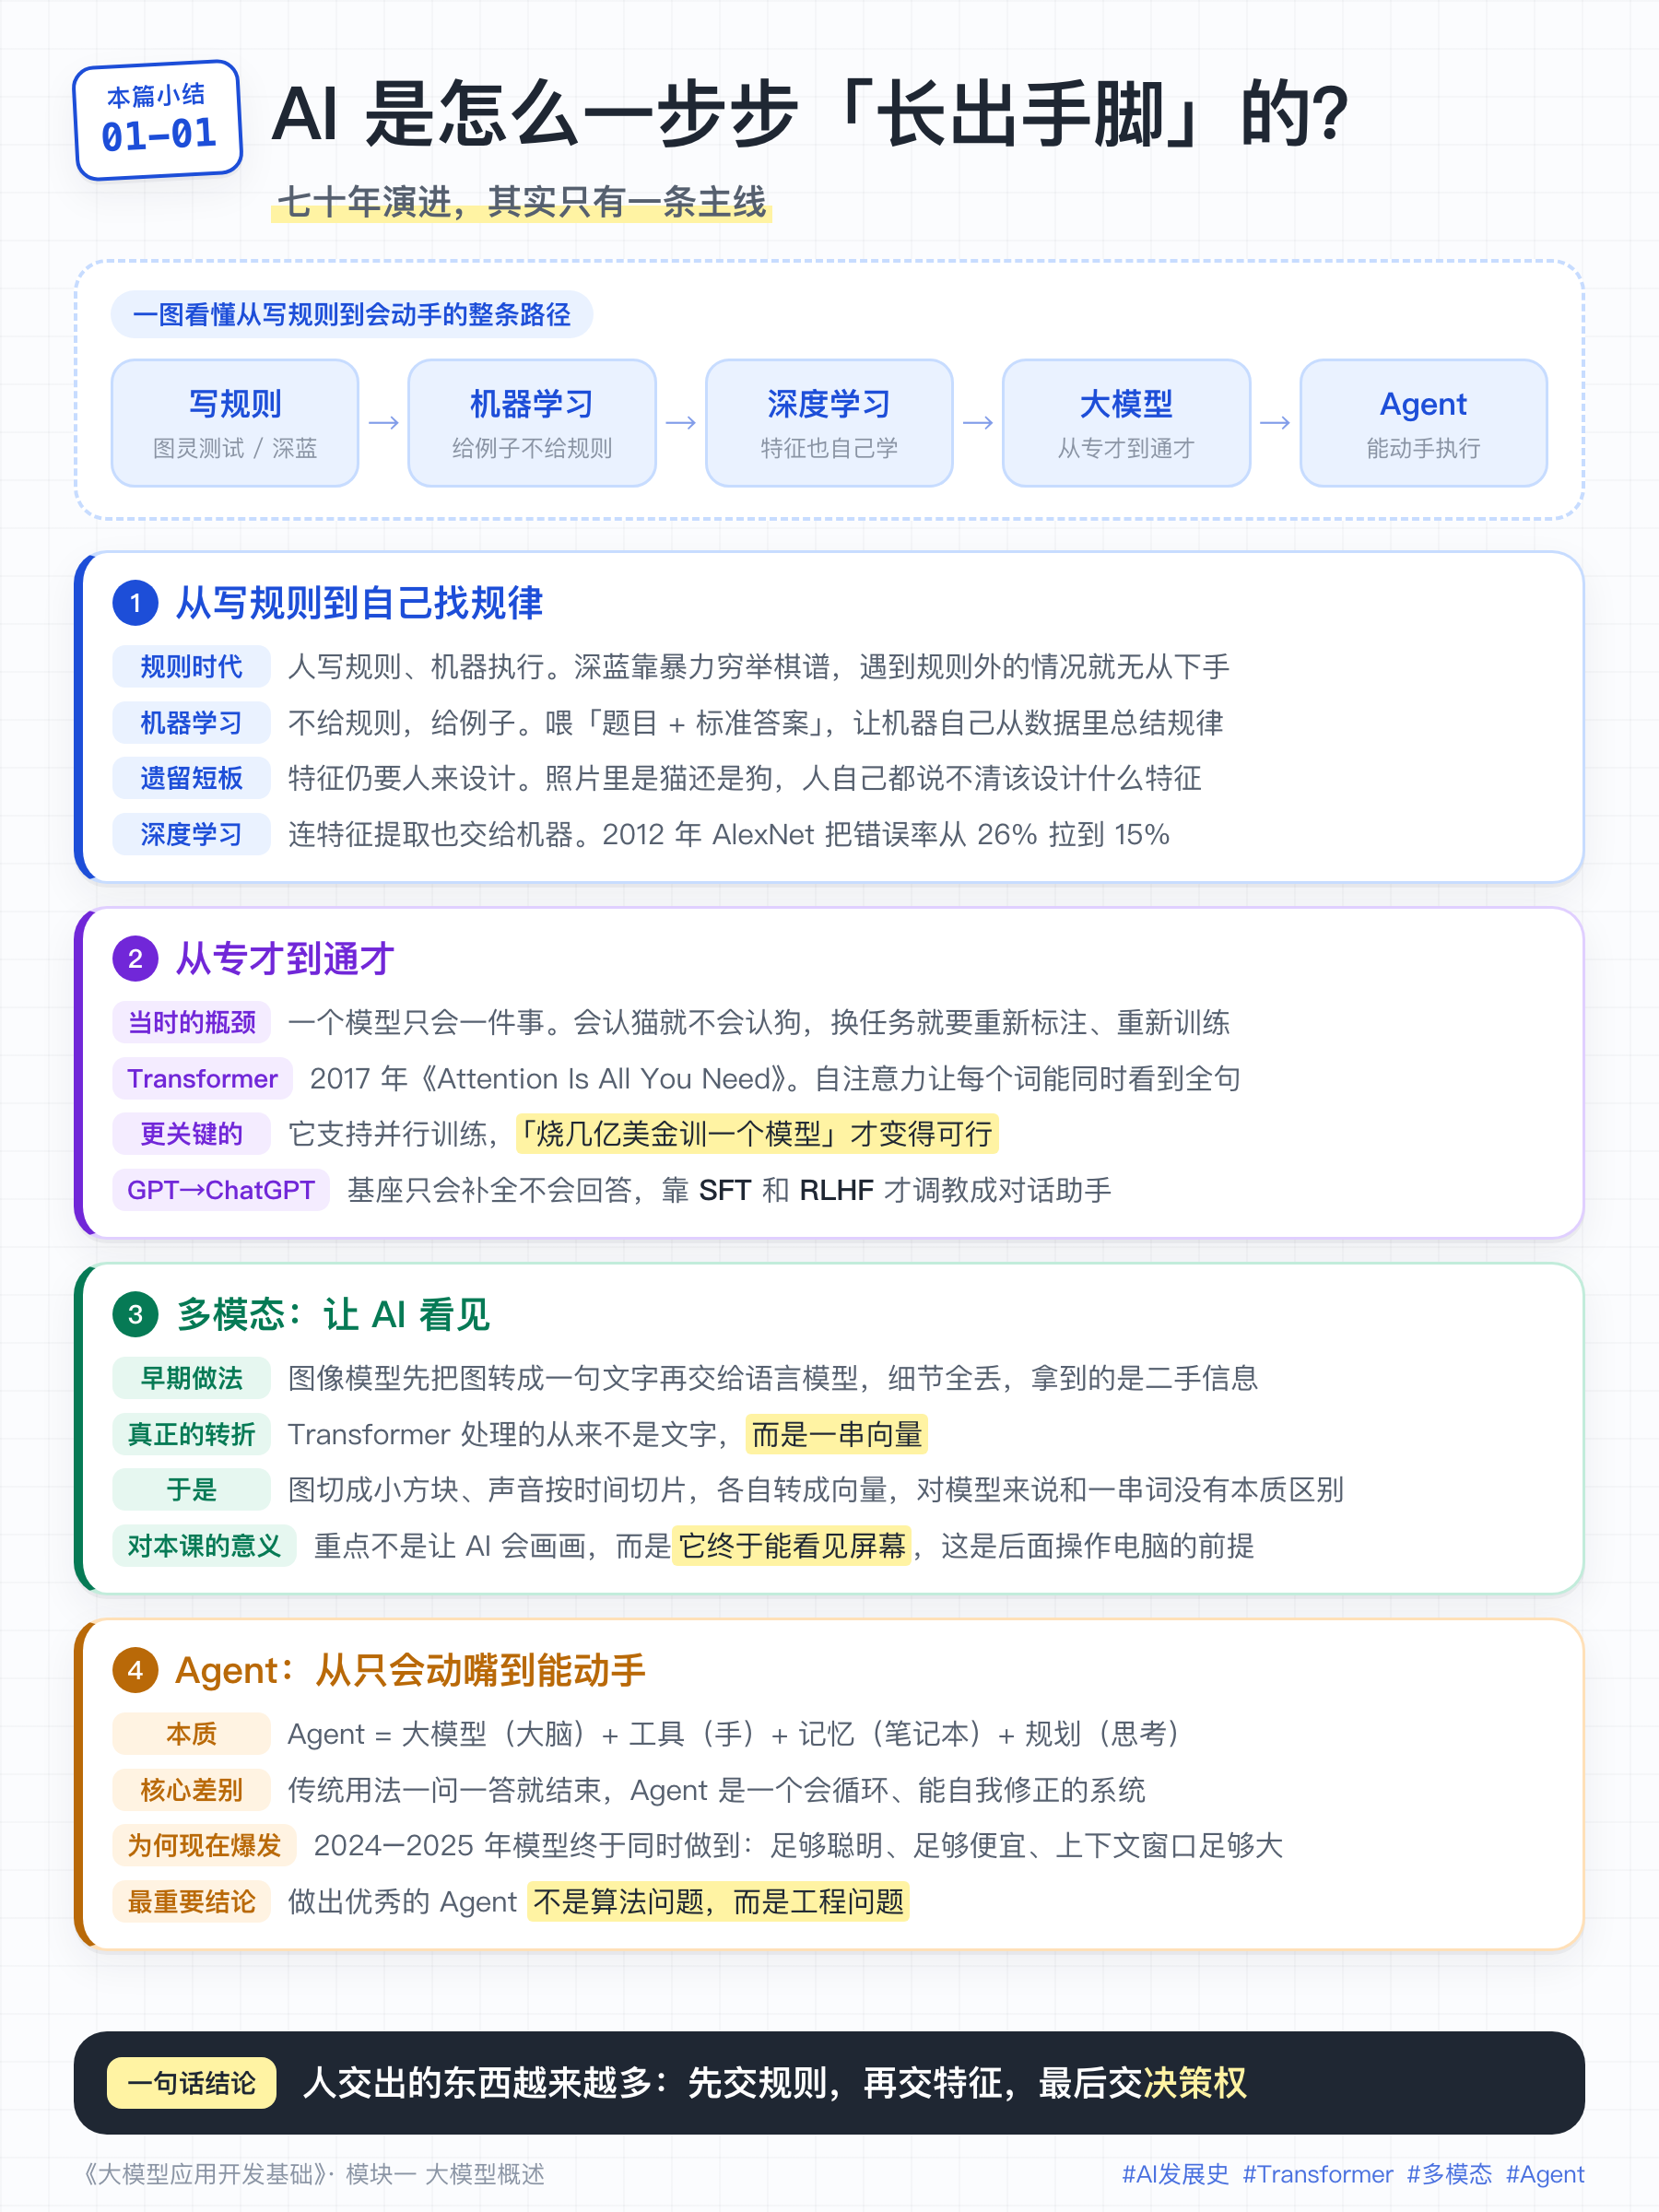
机器学习比写规则强得多,但它有一个致命短板:特征得靠人来设计。 提取哪些特征、怎么量化,全凭专家经验。这不仅费时费力,而且有些东西人类自己都描述不清,比如「照片里是猫还是狗」,你怎么设计特征?
深度学习的出现,彻底改变了这一切。它跟传统机器学习的本质区别是什么?
深度学习把「人工设计特征」这一步,也交给了机器自己学。
它的做法是搭建一个拥有多层「神经元」的巨大网络,也就是我们常说的神经网络。当你把一张猫的图片的原始像素(成百上千个数字)直接扔进这个网络时,第一层可能只识别出边缘和色块,第二层把边缘组合成耳朵或眼睛的形状,第三层再把形状组合成猫的脸……每一层都在自动抽象和提炼更高级的特征,完全不需要人类插手。
只要层数够多、数据够大,这个网络就能提取出人脑都无法言说的微妙特征。
2012 年,AlexNet 在 ImageNet 图像识别大赛上横空出世,把错误率从 26% 直接干到 15%,比第二名整整低了 10 个百分点。深度学习从此登上历史舞台,随后横扫人脸识别、语音识别、围棋(AlphaGo)等领域。
但深度学习有个致命问题:一个模型只会一件事。 识别猫的模型不会识别狗,翻译模型不会写诗,想做新任务就得重新标注数据、重新训练,成本极高。
能不能有一个「通才」模型,学一次啥都会?我们接着往下看。
四、生成式 AI
以往的 AI 大多是「判别式」的,只能回答「是或不是」「猫或狗」。而生成式 AI(Generative AI) 的目标,是让它自己「造」出全新的东西,写一段从未有过的文字,画一幅不存在的画。
ChatGPT 就是生成式 AI。你每次发问,它其实是在根据前文,预测「下一个字」最可能是什么。就这一个动作,重复成千上万次,就写出了一篇完整的回答。
听起来很笨对吧?就这么个「接话」的能力,怎么就能聊天写代码了?
关键突破发生在 2017 年。Google 那年发了一篇论文,标题嚣张得不行《Attention Is All You Need》,提出了 Transformer 架构。
Transformer 牛在哪?牛在它引入了自注意力机制(Self-Attention),让模型处理每个词的时候,能同时「看到」整句话里所有其他词,并自动算出「谁跟谁关系更紧密」。
举个例子:
我把苹果放在桌上,它很快就不见了。
「它」指的是苹果还是桌子?人类一眼就知道。但早期的模型要一个词一个词顺序读,读到「它」时早就忘了前面的苹果。Self-Attention 让「它」能直接跟「苹果」建立强连接,问题迎刃而解。
而且 Transformer 还有个工程上的巨大优势,即可以并行训练。 以前的模型得一个词一个词处理,现在能并行算,训练速度直接起飞。这才让后来「烧几亿美金训练一个模型」变得可行。
五、ChatGPT
基于这个架构,OpenAI 做了一个大胆的尝试:把几乎整个互联网的公开文本都喂给模型,比如维基百科、全网网页、开源代码、几十万本电子书。这个拥有几千亿参数、读遍全球知识的庞然大物,就是大语言模型(Large Language Model,LLM)。
其实 OpenAI 早在 2020 年就发布了 1750 亿参数的 GPT-3,但它只在圈内火,普通人无感。为什么?
因为它有个致命毛病:很会「补全」,但不太会「回答」。 你问它「帮我写封邮件」,它可能给你续写三封不同风格的邮件让你挑,而不是真的替你写一封。
怎么让它学会「回答」?OpenAI 用了**SFT(监督微调)**和 RLHF(基于人类反馈的强化学习),分三步:
- 先找一批人写几万条「高质量问答对」,让模型模仿(SFT监督微调);
- 再让人类对模型的多个回答排序打分,训练出一个「打分器」(奖励模型);
- 最后借助打分器,用强化学习,让模型朝着「人类更喜欢」的方向优化。
后面讲到大模型原理的时候,会详细的讲解。
于是,一个「会接话的文本补全器」(GPT),被调教成了「能回答问题的对话助手」(ChatGPT)。
2022 年 11 月 30 日,ChatGPT 上线。5 天破百万用户,2 个月破一亿,成为史上用户增长最快的消费级应用。对话助手是大模型最成功的应用,当然,后面有了了编程助手(Claude Code等),也是非常成功的应用。
紧接着就是「百模大战」。短短一年多,各种模型井喷:Claude(Anthropic)、Gemini(Google)、文心一言(百度)、通义千问 Qwen(阿里)、豆包(字节)、Kimi(月之暗面)、DeepSeek、GLM(智谱)等等。
六、多模态与 AIGC
聊到这里,大模型已经很能干了。但它有一个容易被忽略的局限:它只活在文字的世界里。
你大概遇到过这种场景:程序报错了,你截了张图想丢给它看,结果它根本看不见,你只能对着屏幕,把报错信息一个字一个字敲进去。
可人从来不是只靠文字理解世界的。一张图你扫一眼就懂,换成文字描述,写三百字可能还说不清。AI 想更像人,迟早得能看、能听。
这里先解释一个词:模态(Modality),说的就是信息的形式。文字是一种模态,图像、声音、视频各是一种。让一个模型能同时处理好几种,就叫多模态(Multimodal)。
那怎么让模型「看见」?
最早的思路很直接:各干各的。图像模型负责识图,把图转成一句文字描述,再交给语言模型。这样确实能跑通,但很割裂。图片里的细节,在被压缩成一句「这是一张猫的照片」之后就全丢了,语言模型拿到的始终是二手信息。
真正的转折,来自一个特别朴素的发现:Transformer 处理的从来就不是「文字」,而是一串向量。 文字也是先被切成小块、转成向量,才能进模型的。
那图片为什么不行呢?把一张图切成一个个小方块,每个方块也转成向量,排成一排喂进去。对模型来说,它跟一串词根本没有本质区别。声音同理,按时间切片就行。
想通这一点,路就打开了:
多模态不是让模型额外学会了看图,而是把图片和声音,翻译成了它本来就懂的那种表示。
能力一打通,两个方向同时爆发。
一边是「生成」,也就是这几年常说的 AIGC(AI Generated Content,人工智能生成内容)。DALL·E、Midjourney、Stable Diffusion 让你打一句话就出一张画,后来又有了文生视频、语音合成、AI 配音,做图做视频的门槛被直接抹平。
另一边是「理解」。现在你可以把开头那张报错截图直接扔给模型,它能读出错误信息,甚至告诉你哪一行写错了;拍张发票,它能把金额和日期给你抽出来。
而对我们这门课来说,多模态最重要的意义,可能还不是让 AI 会画画,而是这一句:AI 终于能看见屏幕了。
它不再只能读你打的字,还能看见屏幕上有哪些按钮、输入框在什么位置。这正是后面 OpenClaw能真正「上手操作电脑」的前提。
七、Agent 时代
到这一步,大模型已经能对话、能写代码、能写文章了。但你有没有发现一个问题:它只会动嘴,不会动手。
你让 ChatGPT「帮我订个机票」,它只会输出一段文字告诉你怎么订,没法真的打开浏览器、点进携程、填入身份证号、完成支付。
这就像你雇了一个博学的顾问:他懂所有事,但没有手也没有脚,只能坐在那儿给你出主意。
怎么让他长出手脚,真正去干事,而不是告诉你怎么干?这就是 Agent(智能体) 要解决的问题。
一句话定义 Agent 的本质:
Agent = 大模型(大脑) + 工具(手) + 记忆(笔记本) + 规划(思考)
之前大模型只能一问一答,而 Agent 让它具备了工具调用(Tool Use) 的能力:模型可以根据需要,自己决定去调哪个工具,比如搜索网页、访问数据库、读写文件,拿到结果再继续思考下一步。整个过程可能循环几十次,直到任务完成。
用一段极简伪代码感受一下这个循环(后面课程会详细展开讲解Agent,这里先建立直觉):
# Agent 的核心循环:思考 → 行动 → 观察 → 再思考 …… 直到任务完成
while not task_done:
    # 1. 思考:大模型根据当前上下文,决定下一步做什么,可用的工具列表及其用法
    thought = llm(f"目标: {goal}\n已做的事: {history}\n下一步该做什么?")

    # 2. 行动:决定调用什么工具(搜索/写文件/查数据库…)
    action = parse_tool_call(thought)
    result = tools[action.name](action.args)   # 工具调用,真正"动手"

    # 3. 观察:把结果塞回上下文,进入下一轮
    history.append((thought, action, result))
注意这里的关键差别:传统用法是「一问一答就结束」,Agent 则是一个会循环、能自我修正的系统。它的能力不只来自模型本身有多聪明,更来自「模型 + 工具 + 反馈循环」的组合。换句话说,开发一个优秀的Agent应用,不是一个算法问题,而是一个工程问题。这也是本课程后半程要反复强调的事。
其实 Agent 的雏形很早就有了。2023 年开源社区的 AutoGPT 一度刷屏:给它一个目标「帮我调研 XX 行业并写份报告」,它自己拆任务、自己搜、自己写。但当时模型太弱、Token 又贵,演示惊艳,生产拉胯。
真正的爆发发生在 2024—2025 年,因为大模型终于同时做到了三件事:
足够聪明、足够便宜、上下文窗口足够大(上下文窗口在下一篇会讲)。
于是 2025 年之后,Agent 产品井喷。其中最引人注目的是编程领域,代表作是 Claude Code。使用Claude Code,即便是对编程毫无概念的小白用户,给个目标,Claude Code 就能自己规划任务、自己写代码、自己跑测试、自己修 Bug,也能做出一个像样的 App 或网站。
除此之外,垂直领域的行业智能体也在同步爆发:客服 Agent、销售 Agent、财务 Agent……AI 的应用形态,正在从只会聊天的 Chat Bot,变成会动手做事的「数字员工」。
八、OpenClaw
说到数字员工,不得不提 2025 年横空出世的 OpenClaw。因为它的 Logo 是只龙虾,中文社区里大家都叫它「小龙虾」。
OpenClaw 到底是什么?简单说,它是一个能让大模型操作你电脑的Agent。 它装在你自己的机器里,可以接入微信、飞书等聊天软件。你在聊天框里发一句「帮我把这周的发票整理成 Excel」,它就在后台默默把活干完。
Claude Code 因为让不会编程的人也能开发产品,已经够出圈了,但它需要通过命令行交互,稍稍还有点点门槛,而 OpenClaw 直接用聊天工具,对小白用户友好得多,火得更是一塌糊涂,一度全民养龙虾。
OpenClaw 的基本工作原理并不复杂,大致是这样:
- 大语言模型是「大脑」:理解你的指令,把「帮我整理一份行业报告」拆解成一步步具体操作;
- 视觉模型是「眼睛」:不断截取屏幕画面,识别按钮、输入框在什么位置;
- 工具模块是「手脚」:控制鼠标点击、键盘输入,就像有个隐形人在操作电脑。
你会发现,这里正好把前面讲的东西全串起来了:大模型提供理解和规划,多模态提供「看见」的能力,工具调用提供「动手」的能力。三者合在一起,才有了今天的数字员工。
本篇小结
02-大模型中的一些常识概念
上一篇我们介绍了大模型的发展历史,知道了 GPT、DeepSeek 这些模型是怎么一步步走到今天的。但你真去开发大模型应用时,会发现文档里全是「术语」:Token、上下文窗口、Prompt、7B、671B、知识截止、思维链……这些词频繁出现,但很多开发者其实只知其名不知其意。
这一篇,我就把这些最基础、也最容易含糊过去的概念一次讲清楚。搞懂它们,你后面看任何大模型文档、API 文档都能顺畅读懂。
一、Token
先说最重要的概念:Token。
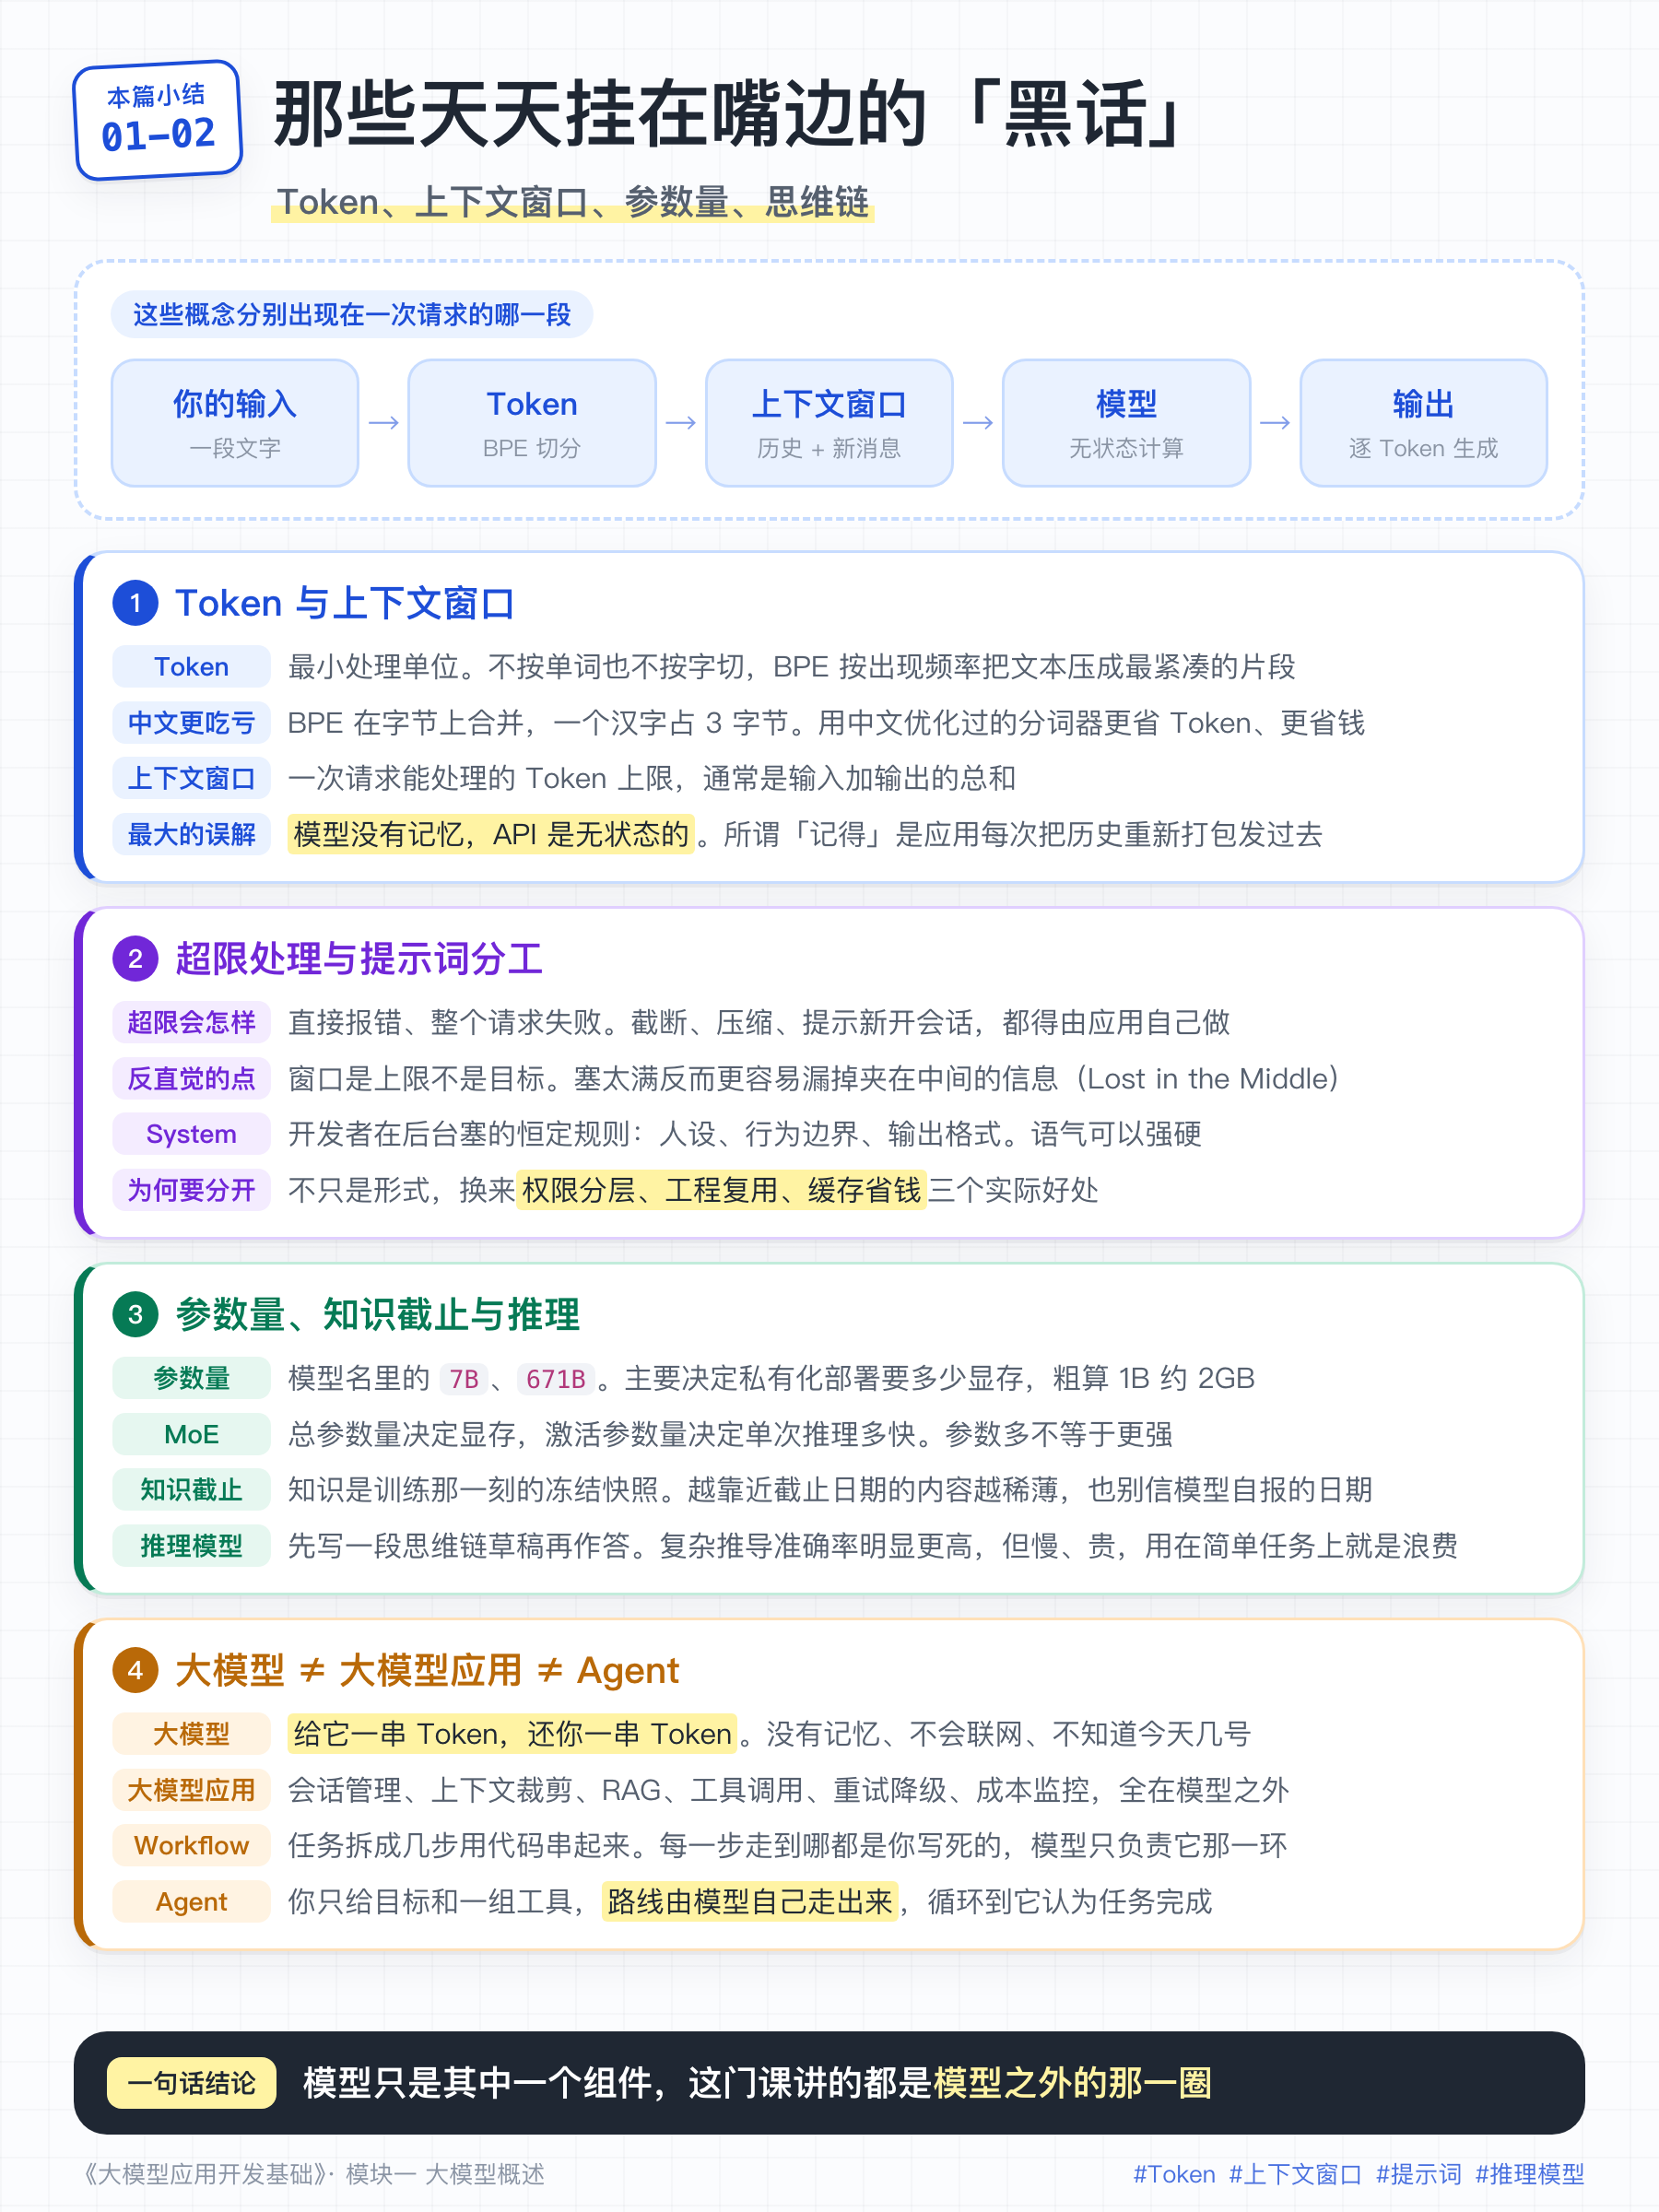
你跟大模型对话,它并不是一个字一个字地读你的话,而是先把文字切成一个个小块,这个小块就叫 Token。你可以把它理解为大模型世界的「字节」:就像计算机底层不认识「图片」和「文字」,只认识 0 和 1,大模型底层也不认识「汉字」和「单词」,只认识 Token。
那一个 Token 大概多大?
- 英文:1 个 Token ≈ 4 个字符,约 0.75 个单词
- 中文:波动很大,1 个汉字在 0.6 ~ 2 个 Token 之间,取决于分词器对中文优化到什么程度(下面会解释这个范围为什么这么宽)
看到这里,你多半会冒出两个疑问:英文不应该按单词切吗,怎么一个单词还会被拆成两个 Token?中文不应该按字切吗,怎么一个字还能被拆开?
实际上,大模型的「分词」根本不是语言学意义上的分词,而是一套纯统计的压缩算法。
主流模型用的是 BPE(Byte Pair Encoding,字节对编码)。它的思路很朴素:先把文本拆成最小的字符,然后不断统计哪两个相邻片段一起出现得最频繁,就把它们「粘」成一个新 Token,反复迭代,直到词汇表达到预设大小(比如 10 万个)。
结果就是:高频的整词独占一个 Token,低频的生僻词被拆开。
the、is、apple这类高频词,只需 1 个 Tokenunhappiness可能被拆成un+happi+nessChatGPT可能被拆成Chat+G+PT(训练时根本没见过这个新词)
为什么非得这么麻烦?因为英语单词有 50 多万个,还每天在造新词。如果词汇表要囊括每一个单词,模型根本装不下。拆成子词,既把词汇表控制在可接受的规模,又保证任何生词都能被表示出来。
中文走的是同一套逻辑,但结果差别大得多,原因在于:BPE 是在「字节」上做合并的,而一个汉字在 UTF-8 编码里占 3 个字节。 一个汉字如果没能在词汇表里占到一个位置,就得被拆成 2 ~ 3 个 Token;占到了,才算 1 个 Token。汉字总量又极其庞大(Unicode 收录超过 9 万个),词汇表根本装不下全部,于是就出现了明显的分化:
- 分词器以英文语料为主(比如 GPT-3.5/4 用的 cl100k_base):中文词条收得少,常用字勉强占 1 个 Token,稍生僻的字要 2 ~ 3 个。这就是「1 个汉字 ≈ 1 ~ 2 个 Token」这个说法的由来。
- 分词器专门为中文优化过(Qwen、DeepSeek、GLM 等国产模型):词汇表里塞进了大量中文常用词,「我们」「人工智能」这类高频词整体就是 1 个 Token。这时候情况反过来,1 个 Token 能覆盖一个半甚至更多汉字。
所以同一段中文,换个模型数出来的 Token 数可能差出一倍,这并不奇怪,只取决于词汇表里给中文留了多少位置。落到实处就是:做中文业务时,用中文优化过的模型,Token 更省,同样的上下文窗口也能塞进更多内容。
一句话总结:
大模型既不按单词读、也不按字读,而是用一张「高频片段表」,把你的输入压成最紧凑的 Token 序列。它不关心语法,只关心频率。
二、上下文窗口
第二个概念:上下文窗口(Context Window)。
上下文窗口指的是一次请求中,大模型能处理的最大 Token 数量,通常是输入 + 输出的总和。
早期模型的上下文窗口只有几千 Token,大概相当于几页纸。到了 2026 年,主流模型普遍做到 100 万 Token 以上,大约相当于 2500 页纸。
不过有个必须澄清的点:大模型本身是没有记忆的,接口调用也是无状态的。 模型处理你这次请求时,只看你这次传进去的 Token,它既不记得你上一轮问了什么,也不会替你保存聊天记录。
你可能会反驳:我跟 ChatGPT、DeepSeek 聊天,它明明记得我前面说过的话啊?
这里要区分两个东西:网页版的对话助手,和大模型不是一回事。 对话助手本身是一个独立的应用,它底层去调大模型。聊天记录是这个应用存在自己数据库里的,跟模型无关。
你每发一条新消息,应用其实是把「历史对话 + 这条新消息」打包成一整段,重新发给模型。于是你就觉得它「记得」之前的聊天内容。
你以为的:    你 ──新消息──▶ 大模型(记得前面所有对话)

实际发生的: 你 ──新消息──▶ 应用 ──[历史对话 + 新消息]──▶ 大模型(每次都从零看起)理解了这一点,一个很现实的问题就来了:对话越聊越长,每次都要累加在一起同时发给大模型,迟早会超出上下文窗口的上限。到时候会怎么样?
一旦超限,大模型会直接报错(提示超过最大上下文长度),请求整个失败。善后工作得由应用(比如聊天助手、编程助手等)自己做。
常见的处理办法有三种(应用端处理):
- 截断:只保留最近 N 轮对话,把最早的丢掉。实现最简单,代价是模型会突然「失忆」,你开头交代过的关键信息可能已经被丢弃了。
- 压缩:把早期对话交给模型总结成一段摘要,把摘要发给大模型,但细节一定有损失。Claude Code自动压缩都是这个思路。
- 提示新开会话:直接把选择权交给用户,这也是很多产品的兜底做法,比如Deepseek的对话助手。
在编程场景里,这件事的感受最明显。你用编程 Agent 改一个大项目,聊到后面往往会看到「上下文即将用尽」的提示,或者它自动做一次压缩。压缩之后你常会发现它「忘了」前面定好的某个约定,得重新交代一遍。所以经验做法是:长任务尽量拆成多个小任务、及时开新会话,而不是在一个会话里一直处理下去。
最后需要提醒的是:上下文窗口大,不等于把它塞满效果就好。 内容太长时,模型反而更容易漏掉夹在中间的信息(业界称为 Lost in the Middle)。
三、提示词 Prompt
第三个概念:提示词(Prompt)。
简单来说,提示词就是你喂给大模型的那段输入文本,也就是你的问题、指令,或者交给它处理的资料。
在普通用户眼里,提示词就是对话框里打的那句话;但在开发者眼里没这么简单,它被严格分成了两个角色:System Prompt(系统提示词) 和 User Prompt(用户提示词)。
User Prompt 很好理解,就是你平时输入的具体问题或任务,比如「帮我写一个排序算法的 Python 代码」「总结这篇文章的核心观点」。它告诉模型这一次具体要干什么。
System Prompt 则是由开发者在后台加入的。它不出现在聊天界面上,但每一轮对话都会附带在请求的最前面,用来设定模型的全局人设、行为边界和输出格式。比如:
- 你是一个资深 Python 工程师,回答要简洁,不要解释原理,直接给代码。
- 你是一个客服机器人,只能回答公司产品相关的问题,超出范围统一回复「我不清楚」。
- 所有输出必须使用 JSON 格式,包含 code 和 message 两个字段。
虽然从「拼 Token」的角度看,System 和 User 最终只是被拼成一段长文本喂给模型,但现代大模型在训练阶段就被专门调教过,会区别对待这两种角色。通俗讲就是,模型在处理时会始终区分两者的优先级:System 里写的是不可突破的底线,User 里写的是具体需求;底线不能破,需求可以灵活响应。 这也是为什么你写 System 时语气可以强硬(「必须……」「禁止……」),而 User 里用自然的提问口吻就行。
把 System 和 User 分开,有三个实际的好处:
- 权限分层,防住恶意注入。 规则写在 System 里,模型会当成最高优先级的铁律;而 User 内容来自用户输入,可能夹带恶意指令。两者冲突时模型优先服从 System,普通用户就很难绕过你预设的护栏。
- 分离规则与任务,便于工程化。 System 放恒定不变的长期规则(人设、格式、安全边界),User 放千变万化的短期任务。你的代码只需要动态拼接 User 部分,System 固定复用,维护起来轻松得多。
- 方便利用缓存,节省成本。 很多模型支持对 System Prompt 做缓存(Prompt Caching,讲提示词工程时会展开)。如果 System 很长但内容固定,重复请求时这部分 Token 会被缓存并打折计费,能省下不少钱。
四、参数量和激活参数量
你一定见过这样的模型名:Qwen3-32B、Llama-3.1-70B、DeepSeek-V3-671B。数字后面那个 B 是 billion(十亿),说的是参数量。
参数是什么?大模型本质是一个巨大的神经网络,里面有海量的数字(参数)决定信号怎么从输入流向输出,训练的过程就是拿数据反复调整这些数字。参数量就是这些数字的个数,可以粗略理解成模型的「脑容量」。
对开发者来说,参数量最直接的意义是决定你要准备多少显存,才能在你的电脑上运行这个大模型。有个粗算公式:1B 参数约占 2GB显存。
| 模型规模 | 显存 | 大致意味着 |
|---|---|---|
| 7B | ~14 GB | 单张消费级显卡勉强能跑 |
| 32B | ~64 GB | 得上专业卡或多卡 |
| 671B | ~1.3 TB | 集群级部署 |
但参数多不等于更强。 数据质量、训练方法影响同样巨大,小模型在特定任务上超过大模型是常事。
还有个容易困惑的地方:DeepSeek-V3 标称 671B,官方却说每次推理只激活 37B,这是怎么回事?因为它用的是 MoE(Mixture of Experts,混合专家) 架构。整个神经网络被拆成很多个「专家」子网络,每个 Token 只路由给其中少数几个。所以看 MoE 模型要关注两个数字:总参数量决定你要多少显存,激活参数量决定单次推理质量。
最后需要说明的是:如果你只调 API,参数量基本不用操心,你该关心的是价格、速度和效果。参数量主要在你考虑私有化部署时才会用到。
五、知识截止日期
先讲一个很小、但特别能说明问题的场景。
你打算在项目里引入 Spring AI,不想查官网,直接问模型:「Spring AI 最新的稳定版是多少?给我 Maven 依赖。」
它答得干脆利落,版本号精确到小数点,连坐标都替你写好了:
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-openai-spring-boot-starter</artifactId>
    <version>1.0.0-M6</version>
</dependency>
你复制进 pom.xml,构建居然过了,于是放心往下写。接着问题就出现了:官方文档里提到的类死活找不到,教程里的方法签名对不上,网上搜到的示例代码一个都跑不通。
翻到官网你才明白怎么回事:Spring AI 早就发布了 1.0.0 正式版,连 artifactId 都换了名字,spring-ai-openai-spring-boot-starter 变成了 spring-ai-starter-model-openai。
这里最大的问题不是它答错了,而是它答得毫不犹豫。它没有说「我的信息可能过时,建议你查一下官网」,而是非常笃定地把这个已经过时的答案交给了你。
模型给你的那个版本号,是一个老版本,是它训练时看到的「最新版」。它认识的世界,停在了训练数据采集完的那一刻。这个时间点就叫知识截止日期(Knowledge Cutoff)。在那之后发生的一切,比如新版本、新框架、新闻事件,模型统统不知道。
想明白这一点,还有两个容易出错的细节。
第一,截止日期不是一条整齐的分割线。 你可能以为「截止到 2025 年 6 月」就意味着 5 月的事它非常清楚。其实不然。一件事发生之后,要过挺长时间才会被反复讨论、写成文章、沉淀成网上的资料。所以越靠近截止日期的内容,在训练数据里就越稀薄,模型对最后那几个月的了解往往是模模糊糊的。
第二,不要轻信模型自己报的日期。 你问它「你的知识截止到什么时候」,它给的答案未必可靠,那多半是从语料里学来的一句话,复述出来而已。想知道准确日期,得去查官方文档。
那怎么办呢?答案很简单:模型不知道的,你喂给它。 把搜索结果、数据库查询结果、文档片段塞进 Prompt 里当上下文,模型就能基于这些新信息回答。回到开头那个例子,你有两条路可以走:要么把官网的依赖说明复制进去让它照着写,要么给它一个能实时查 Maven 仓库的工具让它自己去查。这两条路,正是后面 RAG 和 工具调用 两个模块要解决的核心问题。
一句话总结:模型的知识是训练那一刻的冻结快照,想让它知道新知识,只能靠你在请求里带进去。
六、推理模型与思维链
你打开 DeepSeek 的对话页面,会看到输入框下面有个「深度思考」按钮。按下去和不按,背后其实是两套不同的工作方式。
我们拿一个例子来讲解。
**9.11 和 9.9,哪个大?**你拿这个问题去问大模型。
这个问题在 2024 年是典型的大模型出错案例,当时几乎所有主流模型都答错,直接回答「9.11 更大」。原因是:训练语料里长得像 9.11 的东西,大多是版本号和日期,模型顺着惯性就答了。今天的模型大多已经能答对,因为你能清楚看到,答对到底靠的是什么。
打开深度思考再问一遍,画面完全不一样。正式答案出现之前,屏幕上会先滚出一大片灰色的文字,大意是这样(实际输出比这啰嗦得多):
用户问 9.11 和 9.9 哪个大。
看着简单,但要小心:这可能是版本号,也可能是小数。
按小数理解:9.11 = 9.110,9.9 = 9.900。
比较小数部分,110 < 900。
所以 9.9 更大。
再验算一次:9.9 - 9.11 = 0.79,大于 0,确认 9.9 更大。
等这段滚完,它才不紧不慢地给出结论:9.9 更大。
前面输出的这片灰色文字就是思维链(Chain of Thought,简称 CoT),而会主动生成它的模型,就叫推理模型(Reasoning Model)。代表选手是 OpenAI 的 o 系列、DeepSeek-R1,以及 Claude 和 Gemini 的 thinking 模式。
为什么打个草稿就能答对?因为模型是一个 Token 一个 Token 逐个生成的,一旦开了头,后面就只能顺着前面的内容继续。不让它想,它等于要在第一个 Token 上就赌对答案;让它先把过程写出来,就把一次困难的任务拆成了若干次容易的小步。数学、逻辑推导、复杂代码这类任务,准确率提升非常明显。
顺带提一下,DeepSeek-R1 当年引起轰动,一个重要原因就是它把完整的思维链摊开给你看。OpenAI 的 o 系列出于安全和竞争考虑,只给你一段摘要,真正的原始思考过程没有公开。
当然,开启思维链也是有代价的:
- 慢。 那片灰色文字也是逐 Token 生成出来的。开了深度思考之后,你能明显感觉到要多等好几秒甚至几十秒才见到正式答案。
- 贵。 思考 Token 通常按输出价格计费。哪怕接口根本不把它们返回给你,钱也照样回收。
分类、抽取、改写这类一步就能出结果的任务,推理模型不但没有优势,还白白烧时间和钱,让它反复推理「把这段话翻译成英文」,只会浪费时间和成本。
所以选型原则很简单:需要多步推导才上推理模型,一步能给出答案的用普通模型。
七、大模型 ≠ 大模型应用
最后一个不算术语,但它是这门课的地基。
回头看看前面几节,你会发现「应用」这个词反复出现:聊天记录是应用存的,上下文超了是应用去截断压缩,System Prompt 是应用拼进去的。
大模型本身功能极其单一:
给它一串 Token,它还你一串 Token,仅此而已。它没有记忆,不会联网,不会读你的文件,不会执行任何动作,甚至不知道今天几号。
你在网页版对话助手里体验到的那一切:登录、历史会话、上传文件解析、联网搜索、代码执行、打字机效果、内容审核,没有一样是模型干的,全部由外面那层应用完成。应用替你把这些工作都完成了,所以你看到的只是一个干净的输入框。等你自己做项目,它们就全落回你项目身上了:
大模型应用 = 模型调用
           + 会话与状态管理
           + 上下文组装
           + 知识检索(RAG)
           + 工具调用
           + 输出校验与格式约束
           + 重试、降级与限流
           + 成本、延迟与效果监控
           + 安全与合规
           + 任务编排
+ ...看懂这个式子你就明白了:模型只是其中一个组件,这门课后面所有的模块,讲的都是「模型之外的这一圈」怎么做。
八、Agent 智能体
理解了「应用」这一层,再往前迈一步,就能看懂 Agent 是什么了。
同样是大模型应用,复杂度差别很大,大致可以分成三档。
第一档,单次调用。 你发一段 Prompt,模型回一段结果,结束。其实,很多应用对大模型的使用都还停留在这个层面。
第二档,Workflow(工作流)。 一次调用搞不定,就把任务拆成几步,用代码串起来:先让模型判断用户意图,再去数据库查数据,最后让模型基于查到的数据生成回复。关键在于,每一步走到哪、下一步干什么,都是你在代码里写死的,模型只负责它那一环,不参与决策。
第三档,Agent(智能体)。 你不再规定路径,而是把目标和一组工具交给模型,让大模型自己判断:现在该调哪个工具、拿到结果后要不要再查一次、什么时候算干完了。程序进入一个循环:模型思考,调用工具,看结果,再思考,再调用,直到它认为任务完成。
一句话点总结:
Workflow 里路线是你规划的,模型是执行者;Agent 里路线是模型自己走出来的,你只给目标和工具。
最好懂的例子就是 Cursor、Claude Code 这类编程 Agent。你输入一句「帮这个接口加上分页」,它自己去找相关文件、读代码、动手改、跑测试,测试挂了再回头改,这一串动作,没有一步是事先编排好的。
自主带来灵活,也带来新麻烦:它可能绕远路,可能对着同一个工具反复调用,可能越跑越偏,甚至执行一些你根本没预期的危险操作。所以怎么给它划定边界、怎么控住成本、什么时候必须让人介入把关,才是 Agent 开发真正的难点。这些都是本课进阶篇的内容。
本篇小结
03-你需要了解的大模型原理
你一定好奇过:ChatGPT 背后到底发生了什么?我打了一行字进去,它怎么就噼里啪啦地吐出了一大段回复?它是在「思考」吗?它真的「理解」我在说什么吗?
坦白告诉你,大模型根本不「理解」任何东西。
它本质上就是一个超级强大的「词语接龙机器」。你给它一段话,它预测下一个最可能出现的词是什么。预测完,把这个词拼上去,再预测下一个。如此往复,直到它觉得「差不多了」才停下来。
就这么简单?那它凭什么这么聪明?
这篇文章,我们就把这台「接龙机器」拆开看一看。我们不会讲复杂公式,不会堆砌术语,所以,你不用担心听不懂。
当然,一篇文章只能讲个大概。真要融入细节、公式和算法,要复杂得多,那些我们放到另一门课《大模型原理剖析》里讲。
一、准备数据
大模型的本事,来自互联网上海量的网页、代码和书籍。但它「读」这些资料的方式,跟传统的搜索引擎不同。它不是把内容存进某个库里备查,而是从里面总结规律:什么样的上文后面,通常跟着什么样的词。
规律总结完,原始语料的任务就结束了。模型里并没有存着那些网页和书,只留下了大量数字(也就是参数和向量),规律全被压缩在这些数字里。
所以模型生成内容的时候,它不是去哪个数据集里「找」答案,而是拿这些数字算一遍:眼下这个上下文,接哪个词的概率最大。后面讲 RAG 的时候你会看到,模型为什么会一本正经地编造事实,根源就在这里。
接下来,我们用 5 个句子的微型语料,把大模型的构建过程讲清楚。
我爱吃苹果
我爱吃米饭
你爱吃苹果
我恨吃苦瓜
你恨吃苦瓜
词表去重后共 9 项:["我","你","爱","恨","吃","苹果","米饭","苦瓜","<END>"]。其中 <END> 是一个特殊标记,表示「这句话说完了」。
词表里的每一项,就是一个 Token。 所谓词表(Vocabulary),指的就是模型认识的全部 Token 的清单。
上一篇讲过,真实模型的词表是 BPE 靠统计高频片段自动生成的,「苹果」到底算 1 个 Token 还是被拆成 2 个,完全看词表里有没有它。这里为了讲清楚原理,我们手工指定了一张最简单的词表,让每个词正好对应 1 个 Token。所以下文说的「词」,你都可以直接理解成「Token」。
模型只认数字,不认文字。所以第一步,必须把汉字翻译成一串数字。这串数字叫向量(Vector)。
真实模型的向量维度很高,以 GPT-3 为例是 12288 维,也就是用 12288 个数字来表示一个词。为什么要这么高?因为维度越高,能表达的语义差异就越精细。
为了演示,我们这里用 4 维向量,每个词先随机初始化一个向量值:
我     [ 0.3,  0.1, -0.8,  0.5]
你     [ 0.2,  0.4, -0.7,  0.6]
爱     [ 0.9, -0.2,  0.1,  0.7]
恨     [-0.8,  0.3,  0.2, -0.9]
吃     [-0.5,  0.6,  0.4, -0.1]
苹果   [ 0.1,  0.8, -0.3,  0.2]
米饭   [ 0.15, 0.75,-0.2,  0.25]
苦瓜   [-0.9,  0.1,  0.8, -0.2]
<END>  [ 0.0,  0.0,  0.0,  0.0]
注意,真实训练也是这么随机给的。模型会一边训练一边调整这些数字,让语义相近的词,向量距离也相近(计算向量距离的算法有很多,比如欧氏距离、余弦相似度)。你可以看到上面「苹果」和「米饭」的向量已经挺接近了。这正是训练想要的结果,只不过真实情况下它是练出来的,不是我们编出来的。
二、预训练
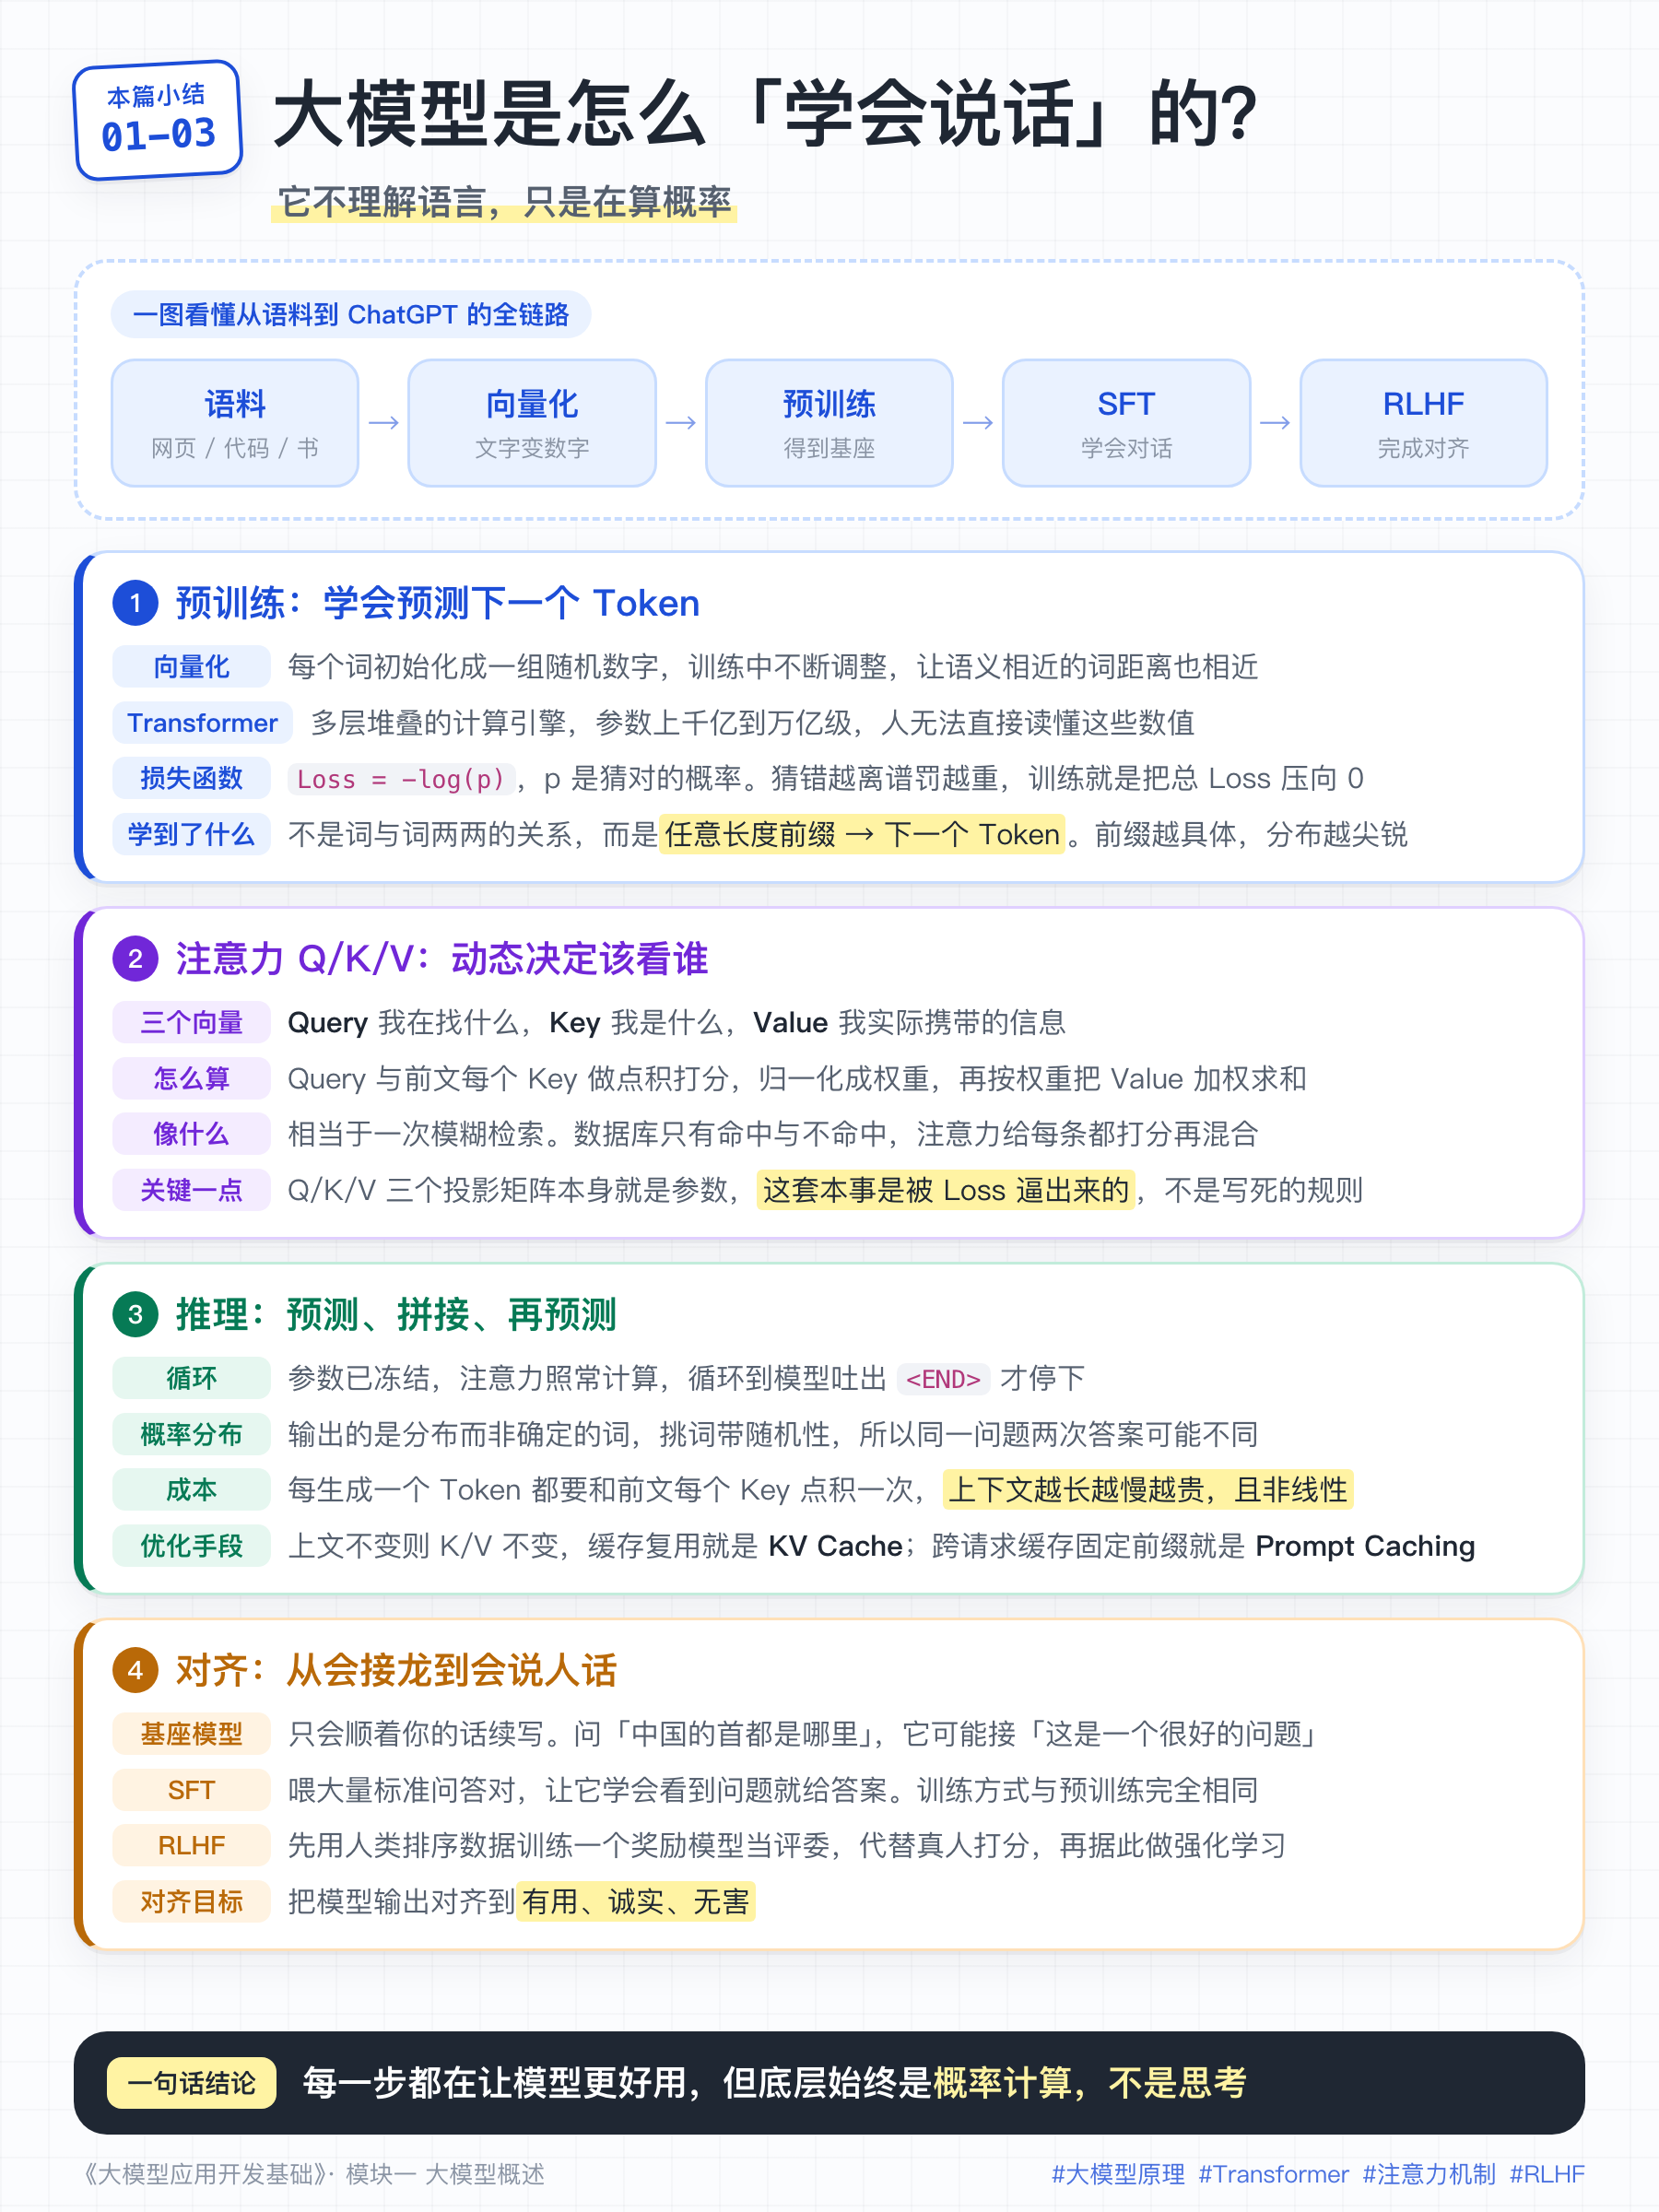
预训练的目标只有一个:让模型学会根据前文预测下一个词。
前面讲了词的向量表示。在开始训练之前,还有两个概念得先说清楚:Transformer 和参数。
Transformer 你可以理解为模型的「计算引擎」。它是一个神经网络,由多层堆叠而成。真实的 Transformer 有几十上百层,每层又有大量参数。
Transformer 真正的杀手锏,是里面的注意力机制(Attention):处理每个位置时,它会给前文所有词各算一个「关注度」权重,再按权重把它们的信息汇总起来。比如预测「吃」后面接什么,「爱」和「恨」拿到的权重就该很高,「我」「你」就该很低。这种动态决定该看谁的能力,正是 Transformer 比上一代模型强的关键。它具体是怎么做到的,待会再具体讲。
参数则是这个引擎里那些可以被调节的数字。向量维度上万,参数动辄成百上千亿,头部模型已经到了万亿级。数量堆到这个程度,它才能表示极其复杂的词与词之间的关联关系。
这里要提醒一下:整个大模型就像一个黑盒子,那些向量值和参数值,人是看不懂的,维度太高了。我们只能从结果上反向验证:给一段话,它能不能「正确」预测下一个词。能,就说明这些值调得合理。
所以,所谓训练,就是拿「正确」的语料,让模型不断调整参数和向量值,直到它每次都能猜对下一个词。
前面说了初始向量是随机的,其实初始参数也是随机的。
现在把 5 句话喂进去。模型对每句话做同样的事,即把它拆成一连串「填空题」,我们拿一句话举例:
输入「我」                → 记录输出「爱」的概率,假设 12%
输入「我 爱」             → 记录输出「吃」的概率,假设 15%
输入「我 爱 吃」          → 记录输出「苹果」的概率,假设 10%
输入「我 爱 吃 苹果」      → 记录输出「<END>」的概率,假设 10%
因为参数是随机的,所以,猜对的概率都很低。
接下来,我们给Transformer定义一个损失函数(Loss):猜错得越离谱,惩罚越重。模型为了少挨罚,就会自己去调整参数。
损失函数的公式特别简单:Loss = -log(猜对的概率)。
猜对概率 10%(0.10) → Loss = -log(0.10) ≈ 2.3
猜对概率 90%(0.90) → Loss = -log(0.90) ≈ 0.1
Loss 越大,说明错得越离谱。把所有填空题的 Loss 加起来,于是就得到总 Loss,训练的目标就是让它无限趋近于 0。拿上面4个训练结果算一下:概率分别是 12%、15%、10%、9%,总 Loss ≈ 2.1 + 1.9 + 2.3 + 2.3= 8.6。错得很离谱,需要调整参数。
于是模型开始不停调整向量值和参数值,朝着让 Loss 变小的方向走。把这 5 句话反复喂 1 万次,每喂一次就微调一次。
1 万次之后再验证:
输入「我爱吃」  →  苹果 48%   米饭 48%   苦瓜 2%
输入「你恨吃」  →  苦瓜 92%   苹果 4%    米饭 4%
发现完全符合语料:「我爱吃」后面苹果和米饭各出现过一次,「你恨吃」后面只有苦瓜。
最后要强调一点:模型记录的并不是词与词两两之间的关系,而是 「任意长度的前缀 → 下一个 Token」 这样的统计规律。
别小看这个区别,提示词为什么有用,答案就在于此。还是拿我们的语料来举例:
只给「吃」     →  苹果、米饭、苦瓜都有可能,概率摊得很平
给「爱吃」     →  苦瓜被排除了,苹果和米饭五五开
给「你恨吃」 → 苦瓜 92%,几乎完全确定看出规律了吗?前缀越长、越具体,符合条件的续写就越少,模型的输出也就越确定。 反过来,你的话越含糊,能接上的说法就越多,模型只好挑一个最大众化的答案给你,但多半不是你想要的。
真实模型的语料大到难以想象,这个效应会被放大。所以提示词工程的本质,就是用更具体的前缀,帮它把概率分布收窄。
三、注意力 Q/K/V
上一小节提到,注意力机制能动态决定该关注前文的哪些词。这一节我们就来看看这件事到底是怎么做到的。
先看它要解决什么问题。还是我们那份语料:「吃」后面接什么,完全取决于前面是「爱」还是「恨」。模型凭什么知道此刻该重点看「爱/恨」,而不是平均地看前面每一个字?
换个更典型的例子:「小明把书给了小红,因为她想看」。这里的「她」指谁?人一眼就看出是小红。模型想接着往下写,也必须先把这件事搞清楚。
做法是这样的。每个词的向量进入注意力层之后,会先被三个矩阵各乘一次,变成三个不同的向量:
- Query(查询):我在找什么样的信息
- Key(键):我是什么,我能被谁找到
- Value(值):我实际携带的信息内容
我们拿「她」这个位置走一遍。它的 Query 大致携带着「我是个女性第三人称代词,我在找前文里一个能被我指代的人」这样的诉求。而前面每个词都有自己的 Key:「小红」的 Key 带着「人名、女性、可作指代对象」,「小明」的 Key 带着「人名、男性」,「书」的 Key 带着「物品」。
拿「她」的 Query,去和前面每个词的 Key 做点积。两个向量方向越接近,点积越大,就说明越匹配。 算出来的分数归一化成一组加起来等于 1 的权重:
她 → 小红    0.70
她 → 小明    0.20
她 → 给了    0.05
她 → 书      0.05
最后按这组权重,把每个词的 Value 向量加权求和,放进「她」的Value里,其中,「小红」的信息占了七成。
所谓「把注意力放到小红上」,就是这么一次加权求和。
但是,你可能会说,Transformer怎么知道「她」应该去找女性名词啊。
Q、K、V 这三个投影矩阵,本身就是参数,就是上一小节说的那些参数。一开始它们是随机的,注意力自然也放得乱七八糟。但只要放错了位置,下一个词就会预测错,Loss 就变大,Transformer就会去调这三个矩阵,让Loss变小。几万亿语料喂下来,它们自己统计出了「代词该去找什么样的先行词」「动词该去找什么样的主语」这类本事。
所以,注意力不是被编程出来的规则,而是被 Loss 逼出来的结果。 该看谁不是写死的,是每次根据当前内容算出来的。这也正是 Transformer 强于上一代模型的地方。
四、推理
训练完成,向量值和参数就固定下来,不再变了。现在,用户输入「你爱吃」,我们来看模型是如何接龙的。
第一轮,模型算出下一个词的概率分布:
苹果 48% 米饭 48% 苦瓜 2%这里有个容易被忽略的细节:模型输出的是一个概率分布,而不是一个确定的词。 到底挑哪一个,取决于采样策略:可以取概率最高的,也可以按概率随机抽(像转一个按概率划分扇区的转盘)。这套策略是怎么控制的,我们在《大模型调用》模块里专门讲。你现在只要记住一点:它不总是选概率最高的那个。
这也顺带解释了一个常见的困惑:为什么同一个问题问两次,答案会不一样?
假设这一轮抽中了「苹果」。于是就得到了「你爱吃苹果」,把「你爱吃苹果」整个重新输入模型,再接一次龙:
<END> 99% 其他词 1%模型输出 <END>,停止生成。最终结果:「你爱吃苹果」。
推理的本质,就是循环执行「预测一个词 → 拼到后面 → 再预测一个词」,直到吐出 <END>。 整个过程里模型没有「理解」你的问题,只是在高维空间里算概率:「你爱吃」后面接「苹果」的概率比较大,于是它就选了「苹果」。
顺便澄清一个容易搞混的问题:上一节讲的注意力,是训练的时候才用,还是推理的时候也用?答案是,两个阶段都在用。 只要模型处理输入,它就得跑一遍。区别只在于参数动不动:训练时算完还要回头调整 Q/K/V 这些矩阵,推理时参数已经冻结,只算不调。
这一点直接决定了推理的成本。 在推理阶段,每生成一个新 Token,它的 Query 都要和前面每一个 Token 的 Key 做一次点积。 复杂度是O(n^2)量级的。 上下文里有 1000 个 Token 就得算将近 1000^2 次,有 10 万个就得算 10 万^2次。所以上下文越长,生成越慢也越贵。
训练虽然也贵也慢,但是一次性投入;推理却是每次用户调用都要跑一次,所以,推理延迟成了工程上最核心的痛点。
好在这里有很大的优化空间。大模型常用文本的Key和Value记录在缓存中( KV Cache),如果推理的过程中,用户的问题命中了缓存,就不需要重新计算用户问题的Value了,省去了很多计算的成本和时间。
Prompt Caching 底层就是依赖 KV Cache,把跨请求都不会变的前缀(比如固定的 System Prompt)的 K、V 存下来,下次命中就不用重新计算了,于是,这部分 Token 的计费就能打折。我们在提示词工程模块会展开讲。
五、SFT
上面训练出来的模型叫基座模型(Base Model)。它只会接龙,不会对话。
什么意思呢?你问它:
用户:中国的首都是哪里?基座模型很可能顺着你的话继续编下去:
中国的首都是哪里?这是一个很好的问题,很多人都在问……它没有「回答」这个概念,只是根据互联网上「中国的首都是哪里」这句话后面经常出现什么,接着往下写。这显然不是我们想要的 ChatGPT。
要让模型学会对话,就得做监督微调(Supervised Fine-Tuning,简称 SFT)。
SFT 的核心很简单:给模型看大量标准问答对,让它模仿。
我们准备一批人工标注或高质量生成的数据,格式是这样的:
<用户>:中国的首都是哪里?
<助手>:中国的首都是北京。

<用户>:帮我写一首关于月亮的诗。
<助手>:明月几时有,把酒问青天……
然后把这些数据继续喂给模型。训练方式和之前一模一样:输入前面的部分(用户的问题),让它预测后面的部分(助手的回答),猜错了就调整参数。
经过大量对话样本的训练,模型逐渐学到一个模式:看到「用户:xxx?」的时候,后面该接「助手:xxx。」,而不是继续自由发挥。
它仍然在做词语接龙,只不过学会了在对话场景下,接龙的方向是「给出一个合适的回答」,而不是「接着往下编故事」。
经过 SFT,模型就从基座模型变成了对话模型。你再问「中国的首都是哪里?」,它就会回答「中国的首都是北京。」
六、RLHF
SFT 让模型学会了回答问题,但它只是在模仿人类写好的标准答案。真用起来你会发现毛病不少:
- 问它「如何做炸弹」,它可能真的开始一步步教你;
- 同一个问题,回答可能啰嗦、跑题,或者态度生硬;
它不知道什么答案更让人舒服,只会按训练数据里的概率输出。换句话说,SFT 模型学会了「说话」,但还没学会「说人话」。
于是人们想了个办法:让人类当老师,告诉模型哪些回答更好,再让模型朝这个方向优化。这套流程就是 RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)。
当然,不能真让人类一直盯着模型改,那太慢了。所以要先训练一个奖励模型(Reward Model,简称 RM),让它代替人类打分。
这里有个恰当的类比:大模型是老师,奖励模型是评委。 评委不需要会讲课,他只需要能判断哪个回答更好。所以训练评委,比训练老师简单得多。它只要学会打分,不需要学会讲课。
奖励模型怎么训练?分四步:
- 拿同一个问题,让 SFT 模型生成好几个不同的回答。
- 请人类标注员给这些回答排序。比如:
问题:怎样缓解焦虑?
回答 A:多运动,保持规律作息,必要时寻求专业帮助。
回答 B:焦虑就是闲的,找点事做。
回答 C:别焦虑了,焦虑不好。- 人类判断:A > B > C。
- 把这些「问题 + 回答」的排序数据喂给奖励模型。它也是一个神经网络,最终输出一个分数,分数越高代表人类越喜欢。
训练完成后,奖励模型就成了一个「虚拟评委」。你给它任意问题和回答,它都能给出一个大致符合人类偏好的分数,不用每次都麻烦真人。
有了打分器,类似前面训练的逻辑就可以开始了:模型每生成一个回答,评委就打个分,分高奖励、分低惩罚。模型的目标,是不断调整参数,让自己拿到更高的分数。这一步通常也叫对齐(Alignment),即把模型的输出,对齐到人类期望的「有用、诚实、无害」上。
本篇小结
04-市面常见模型的介绍和对比
现在可以说是百模大战,但真正有竞争力的也就那么几家。国外三巨头:GPT 系列(OpenAI)、Claude 系列(Anthropic)、Gemini 系列(Google)。国内四小龙:DeepSeek(深度求索)、Qwen(阿里)、GLM(智谱)、Kimi(月之暗面)。
每家的能力都不太一样。这一篇我们把它们放在一起比一比,看看各自擅长什么、做不了什么,以及做技术选型时到底该关注哪几个指标。
先说明一件事:模型迭代极快,下面所有具体型号、参数和价格都核验于 2026 年 8 月 ,来自各家官方文档。等你读到这篇时,型号很可能又换了一轮。所以真正要记住的不是这些数字,而是该看哪些指标,这套方法不会过期。
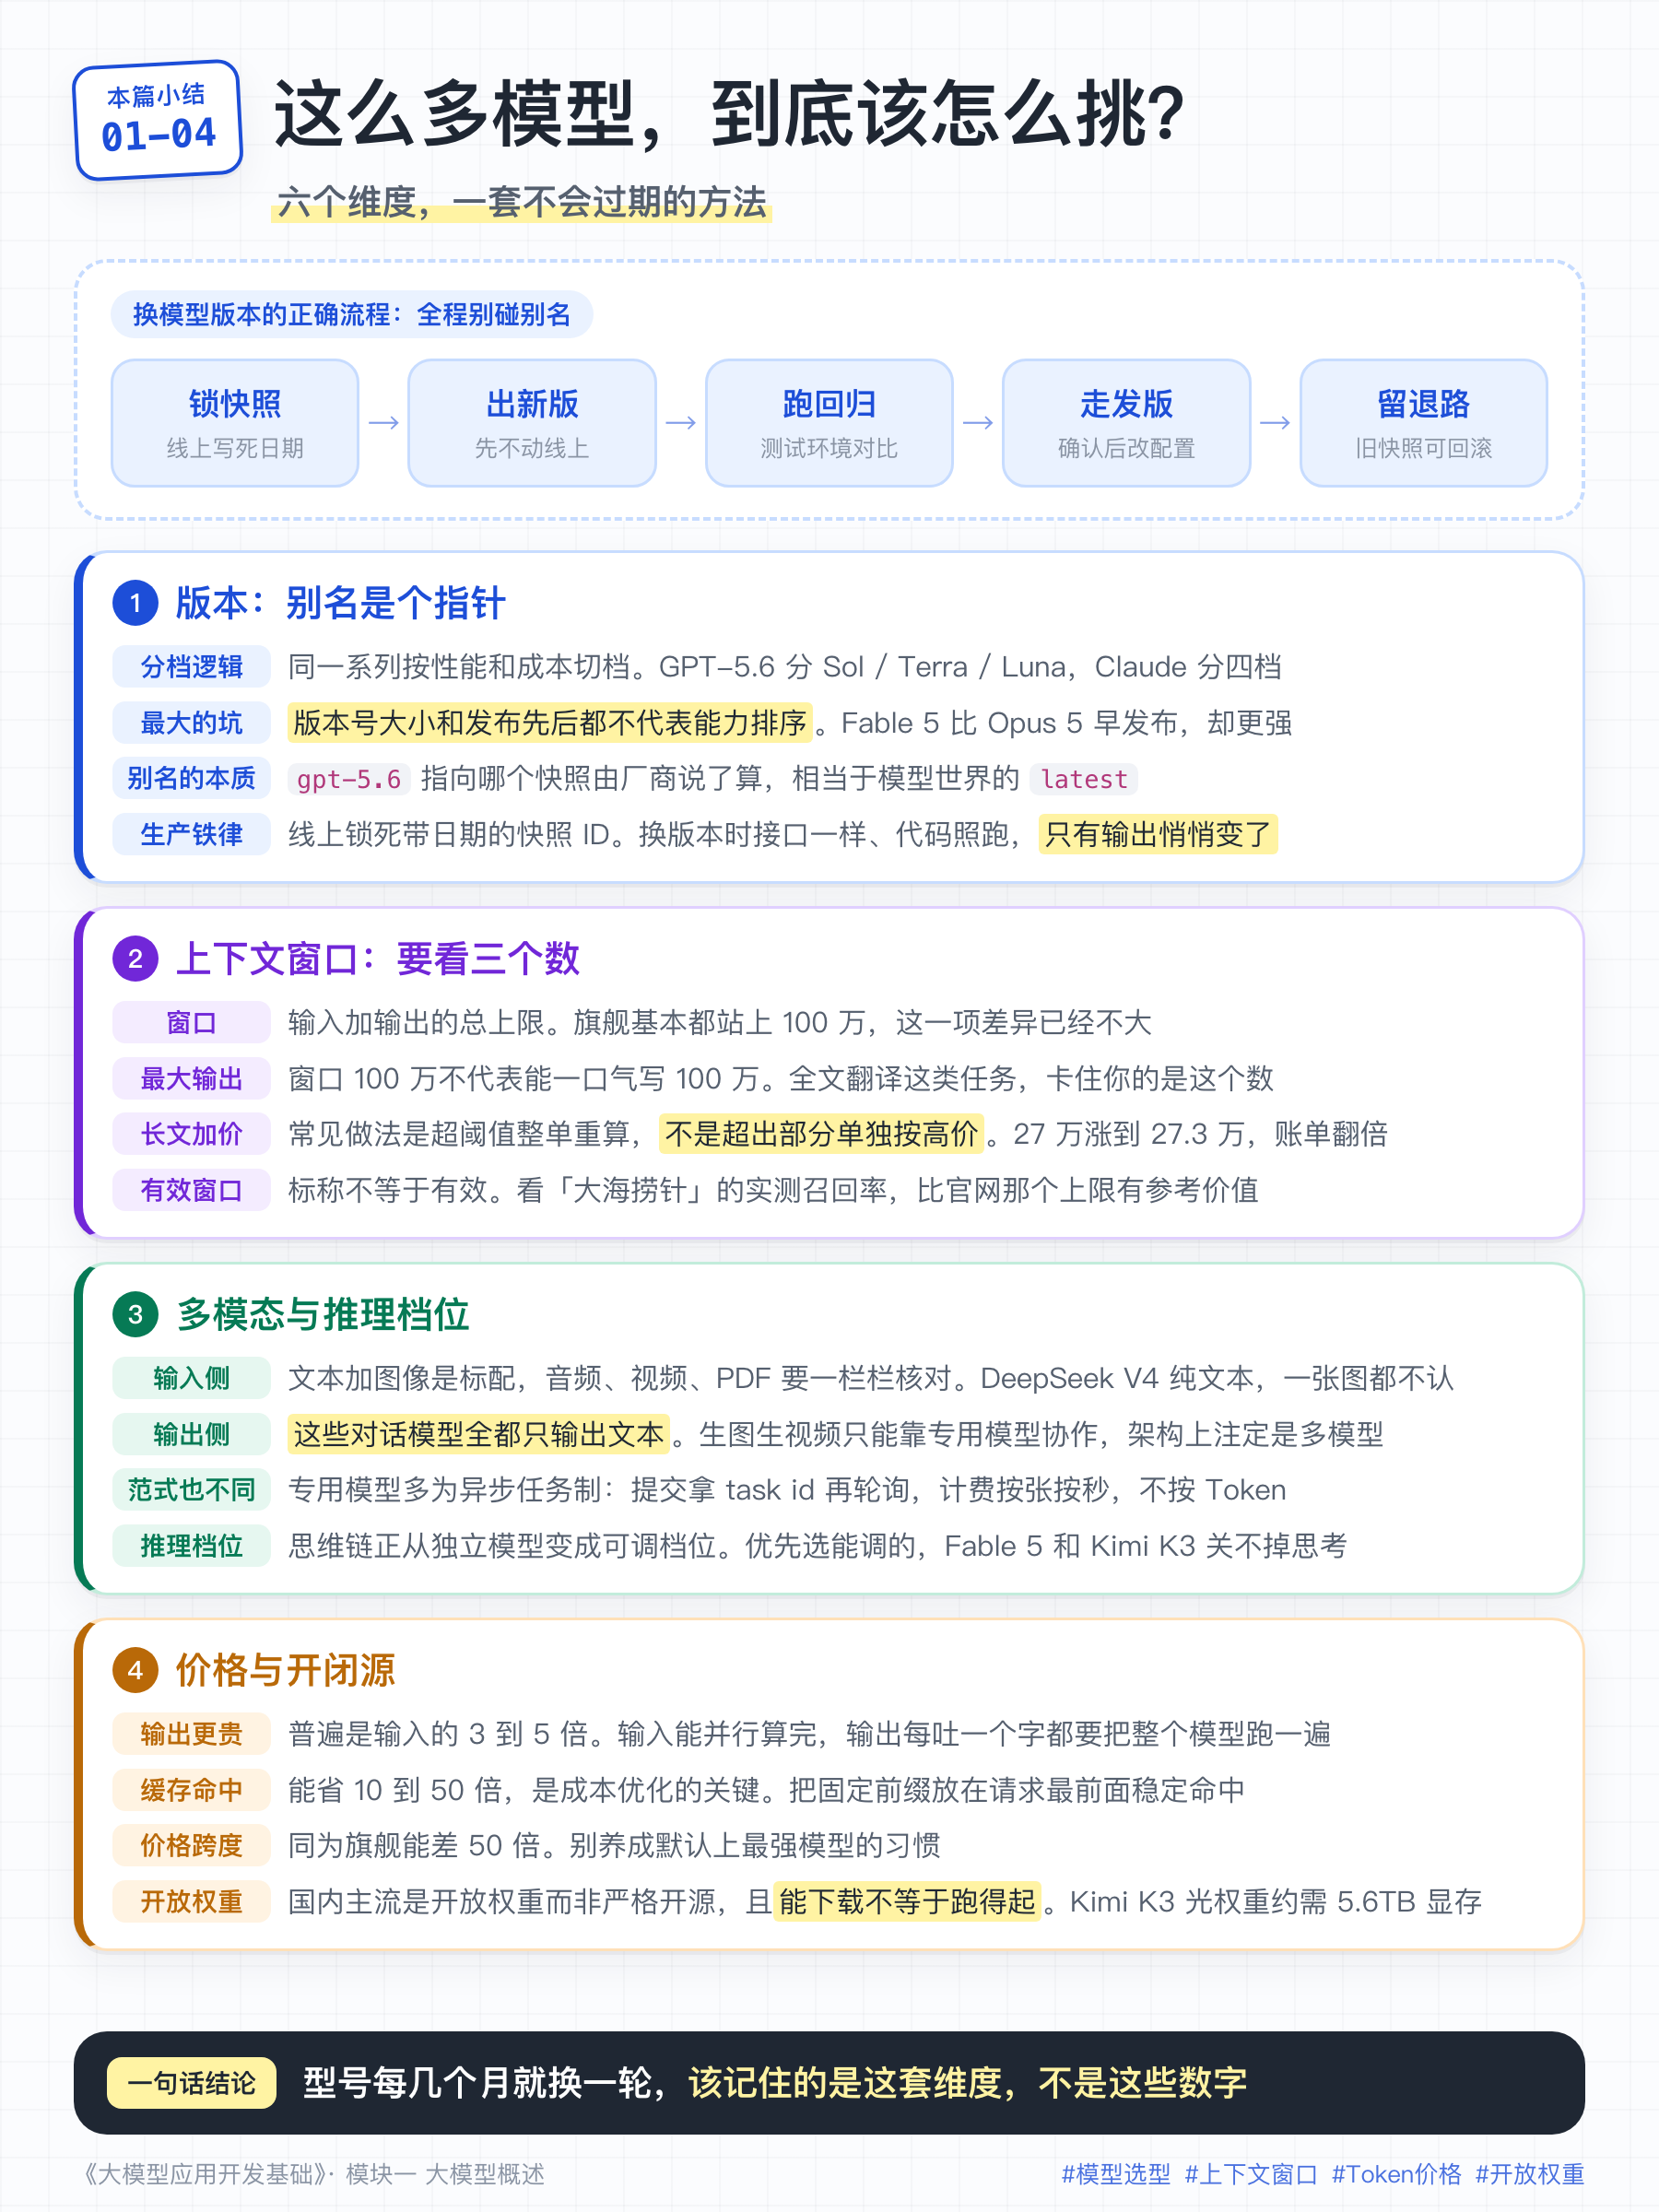
一、大模型版本
同一个系列里,往往同时存在好几个版本。为什么不做一个最强的就好了?
因为用户的需求本来就不一样:有人要极限性能不在乎贵,有人要海量调用必须便宜,有人要低延迟。所以,厂商按不同档位划分出多个版本,分别提供。
以 GPT 系列为例。它的命名经历了几代演变:早期按数字迭代(GPT-1、GPT-2、GPT-3、GPT-3.5),从 GPT-4 开始逐渐复杂化。目前最新的 GPT-5.6 分三档:
- GPT-5.6 Sol(旗舰版):性能最强,主打复杂推理、编程和知识工作这类高难度任务。
- GPT-5.6 Terra(均衡版):兼顾能力与成本,日常任务的标准选择。
- GPT-5.6 Luna(高效版):追求最快速度和最低成本,适合成本敏感或高并发的场景。
Claude 这边分得更细,目前是四档:Fable 5(最强)、Opus 5(Fable 5高性价比平替版)、Sonnet 5(速度与智能的最佳平衡)、Haiku 4.5(最快)。
这里有一个特别值得注意的问题。Fable 5 发布于 2026 年 6 月 9 日,Opus 5 到 7 月才发布,你可能以为「Opus 5 比 Fable 5 新,所以更强」。恰恰相反, Anthropic 官方至今仍把 Fable 5 描述为能力最强的通用模型,Opus 5 只是价格更低的次一档。Haiku 更是还停在 4.5。
所以请记住一条:版本号大小和发布时间先后,都不代表能力排序。 每家的命名逻辑都是自己定的,唯一可靠的办法是去官网的模型页查看:
- OpenAI:
developers.openai.com/api/docs/models - Anthropic:
platform.claude.com/docs/en/about-claude/models/overview
调用模型时,你要在 model 参数里传一个字符串指定用哪个模型。
claude-haiku-4-5-20251001   ← 快照 ID:带日期,永远指向同一个模型版本
claude-opus-5               ← 别名:不带日期,指向哪个快照由厂商决定
gpt-5.6                     ← 别名:当前指向 gpt-5.6-sol
别名(Alias)本质上是个指针。 它自己不是任何一个具体的模型,只是记着「当前该用哪个快照」,而指向哪里由厂商说了算。厂商像软件公司发版一样,在已有的版本上做迭代,然后,不断发布新的版本。他们发布新版本时,会把这个指针指向新快照。
这和你平时管依赖版本是一回事:pom.xml 里写死 1.0.3,还是写 1.0-SNAPSHOT;Docker 里拉 nginx:1.25.3,还是拉 nginx:latest。别名就是模型世界的 latest。
不过,软件版本号承诺向后兼容,模型没有任何这类承诺:软件依赖升级出问题,通常会以编译错误、接口不兼容的形式当场报错;模型换版本却是接口完全一致、参数没有变化、代码照常运行,只有输出发生了改变。
所以生产环境别用别名。你精心调好的提示词、依赖的输出格式,全都建立在某一个具体模型的行为之上。厂商一旦把指针指向新快照,输出就可能改变,即便你的代码一行都没改。
所以,正确的做法是:
- 线上始终锁定某个快照 ID,比如
claude-haiku-4-5-20251001。 - 厂商发布新快照时,先不动线上。
- 在测试环境用新快照跑一遍你的回归用例集,对比输出质量、格式合规率、延迟和成本。
- 确认没问题,再改配置、走发版流程,把
model换成新快照 ID。 - 万一线上有问题,旧快照还在,随时能切回去。
不过写死版本也不是一劳永逸:版本会退役。 各家都会公布退役时间,比如 Anthropic 明确写了 Claude Haiku 4.5 的退役不早于 2026 年 10 月 15 日。所以你还得定期关注这些公告,赶在退役前升级新版本。
二、上下文窗口
上上一篇讲过上下文窗口是什么。这里先回答一个问题:为什么这两年各家都在不断把这个数值往上提升?
因为它是模型的工作记忆上限,能不能一次读完整份合同而不切块(一切块就会丢掉跨块的关联,比如第 5 页的定义和第 200 页的条款相互冲突,分开看永远发现不了)、多轮对话进行到多少轮后开始丢失早期信息、RAG 能放入几段检索结果,都得受上线文窗口大小的限制。
除此之外,Agent应用的发展,也势必要求上下文窗口的提升!Agent 的每一步思考、每一次工具调用、每一份返回的文件内容和命令输出,全都要累积进上下文,几十轮下来轻松几十万 Token。2023 年做的是聊天应用,8K 就够用了;今天做的是 Agent,8K 连一个文件都读不完。
回到选型。其实,光看上下文窗口这一个数不够,我们要关注三个相关的数字
| 模型 | 上下文窗口 | 最大输出 |
|---|---|---|
| GPT-5.6 Sol / Terra | ~105 万 | 12.8 万 |
| Claude Fable 5 / Opus 5 / Sonnet 5 | 100 万 | 12.8 万 |
| Gemini 3.7 Flash | ~105 万 | 6.5 万 |
| DeepSeek V4 | 100 万 | 38.4 万 |
| Qwen3.8-Max / Kimi K3 / GLM-5.3 | 100 万 | 因型号而异 |
第一个数是上下文窗口,也就是输入加输出的总上限。可以看到每个模型的旗舰版本基本都达到 100 万,差异已经不大了。
第二个数是最大输出,这是很多人容易忽略的。上下文窗口 100 万,不代表它能一口气给你输出 100 万 Token 的内容。Claude 和 GPT 的上限是 12.8 万,Gemini 3.7 Flash 和 Haiku 只有 6.4 万左右。比如你要把一份几十万字的产品手册整篇翻译成英文:输入塞进 100 万的窗口绰绰有余,可输出到 12.8 万就被截断了。这类「输出量和输入量差不多」的任务,比如全文翻译、批量改写,卡住你的都是最大输出这个数,只能自己切块、分多次调用再把结果拼起来。
第三个数最容易出错:长上下文要不要加价。 各家做法不一样,大致分三类。
第一类是设一个阈值,超过就整单涨价。 OpenAI 是输入超过 27.2 万 Token,整个请求按 2 倍输入价、1.5 倍输出价计费;
第二类是按输入长度分档。 阿里百炼的 Qwen 系列是典型,以 Qwen3-Max 为例:32K 以内输入 ¥2.5/百万,32K–128K 跳到 ¥4,128K–256K 再跳到 ¥7,输出价同步上浮。
这两类有一个共同的问题:不是「超出的那部分」按高价,而是整个请求都按落入的那一档重算。 你的请求从 27 万 Token 涨到 27.3 万,账单不是多 1%,而是直接翻倍。做长文档处理的应用,一定要留意这一点。
第三类干脆不分档。 DeepSeek V4 和 Kimi K3 都是全长度统一单价,多长都一个价。
还有一件事必须提醒:标称窗口不等于有效窗口。 厂商写 100 万,不代表这 100 万里每个位置的信息它都用得一样好。这就是上上一篇提过的 Lost in the Middle问题,夹在中间的内容最容易被忽略,表现就是明明在提示词写清楚了要求,模型却不按照要求来输出。
业界验证有效长度的办法叫「大海捞针」(needle in a haystack):在超长文本的随机位置藏一句特定的话,再问模型这句话是什么,统计不同长度、不同位置下的召回率。比如 Gemini 3.7 Flash 官方给出的 128K 长度检索准确率是 97.0%,这个数比标称的 105 万更有参考价值。
所以还是那句话:窗口是上限,不是目标。 塞太满不但容易漏信息,钱还多花。
三、多模态支持
假设产品经理提了个需求:做一个售后助手,用户可以拍张照片问「这个零件怎么装」,也可以直接发一段语音描述,最后助手要生成一张标好步骤的安装示意图发回去。
你打开模型官网,看到「原生多模态」四个字,心想这下没问题了。真正动手做时才发现,这个需求里有一半这个模型做不了。
选型时你必须把输入侧和输出侧拆开看,这两边的成熟度根本不在一个层级。
输入侧已经相当好了。文本加图像基本是标配,GPT-5.6 全系、Claude 全系都支持。再往上就开始分化,音频、视频、PDF 得一个个查:Gemini 3.7 Flash 覆盖得最全,文本、图像、音频、视频、PDF 全都能直接处理;国内 Kimi K3 和 Qwen3.8-Max 支持图文视频;而 DeepSeek V4 系列是纯文本,不支持任何图像输入。所以上面那个需求里,「看照片」和「收语音」是能做的,只要模型挑对。
输出侧几乎零支持:前面提到的所有模型,输出全都只有文本。 包括 Gemini 3.7 Flash,它输入能收一整段视频,输出照样只有文字。
也就是说,「生成一张安装示意图」这件事,对话模型根本做不到。生图、生视频、合成语音,靠的从来不是这些模型,而是各领域的专用模型。所以但凡你的应用要产出文本以外的东西,架构上就注定是多个模型协作:对话模型负责理解意图和编排,专用模型负责生成。
专用模型都有哪些?按你要产出的东西分,大致有这几类:
| 要产出什么 | 常见选择 |
|---|---|
| 图像(文生图、图像编辑) | GPT Image 2(OpenAI)、Nano Banana 2 / Pro(Google)、Seedream 5.0(字节即梦)、通义万相(阿里) |
| 视频(文生视频、图生视频) | Veo 3.1(Google)、Sora 2(OpenAI)、可灵 Kling(快手)、Seedance(字节)、Wan(阿里) |
| 语音合成 TTS | ElevenLabs、豆包语音(字节)、CosyVoice(阿里) |
| 语音识别 ASR | Whisper(OpenAI)、Scribe v2(ElevenLabs)、Paraformer(阿里) |
接入这些专用模型,需要注意:它们的调用范式和对话模型不一样。 生成一张图要几秒,生成一段视频动辄几十秒到几分钟,所以这类接口大多是异步任务制:你提交任务拿到一个 task id,再轮询状态或者等回调,而不是像调 chat 接口那样同步等一个响应。计费单位也换了,不再按 Token,而是按张、按秒、按字符算。这意味着你的应用里会同时跑着两套调用范式和两套成本模型,日志、重试、超时、账单统计都得分开做。
四、推理模型
上上一篇讲过思维链是什么。这一节要说的是它在工程上发生的一个变化。
倒回 2024 年,假如你要做一个应用,里面既有「把这段话翻成英文」这种简单任务,也有「分析这份财报找出异常」这种复杂任务。那时候你只能维护两套:简单的走普通模型,复杂的走推理模型(o 系列、DeepSeek-R1)。
厂商显然也觉得这样不方便。于是这两年的主流做法变成了:推理不再是一类单独的模型,而是同一个模型上一个可调的档位。
- GPT-5.6 全系支持
reasoning.effort参数,六个档位:none、low、medium(默认)、high、xhigh、max。 - Claude Sonnet 5 / Opus 5 是自适应思考,同时开放 effort 参数供你调节。
- Gemini 3.7 Flash 提供
LOW、MEDIUM、HIGH三档思考等级。 - DeepSeek V4 支持思考/非思考模式切换。
要注意,这个档位调的不只是效果,更是账单和延迟。因为思考过程本身就是模型吐出来的 Token,通常按输出价计费,而输出价往往是输入价的 5 倍。同一个问题从 low 调到 max,答案可能只好一点点,Token 却能翻好几倍。
也正因为如此,有两个模型得特别留意:Claude Fable 5 的思考是常开的,Kimi K3 同样始终开启,都关不掉。 你要是拿它们去跑「判断这条评论是不是差评」这种又简单又高频的分类任务,它同样会进行一大段思考,最后只给出一个「是」,但那段思考你得照价付钱。
所以这里有条很实在的建议:优先选能调档的模型。 一个模型覆盖简单和复杂两类任务,简单的把 effort 设置为 none 或 low,复杂的再开高档,比维护两套模型省心得多。而这恰恰就是厂商把推理做成档位想帮你解决的问题。
五、Token 价格
很多团队就是这样出问题的:demo 阶段随手挑了个最强的模型,效果不错就直接上线,一个月后收到账单,发现光模型调用就占用了大半预算。
下表单位是每百万 Token(核验于 2026-08,当你看到这篇文章时,价格可能已经有变动了):
| 模型 | 输入 | 缓存命中输入 | 输出 |
|---|---|---|---|
| Claude Fable 5 | $10 | — | $50 |
| Claude Opus 5 | $5 | — | $25 |
| GPT-5.6 Sol | $4 | $0.40 | $20 |
| Claude Sonnet 5 | $2 | — | $10 |
| GPT-5.6 Terra | $2 | $0.20 | $12 |
| Claude Haiku 4.5 | $1 | — | $5 |
| Gemini 3.7 Flash | $0.75 | — | $3.75 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| Kimi K3 | ¥20 | ¥2 | ¥100 |
| Qwen3.8-Max | ~¥14 | ~¥1.75 | ~¥43 |
| DeepSeek V4-Pro | ¥3 | ¥0.025 | ¥6 |
| DeepSeek V4-Flash | ¥1 | ¥0.02 | ¥2 |
从表中,我们发现输出比输入贵得多,多数在 5 倍上下,区间大致在 2 到 6 倍。这不是厂商乱定价,因为成本结构本来就是这样的:输入的那一大段可以一次性并行算完,输出却必须一个 Token 一个 Token 地生成,每吐一个字都要把整个模型完整跑一遍。
从表中,我们还发现一个缓存命中价。 GPT-5.6 Sol 命中 0.40、未命中4,差 10 倍;DeepSeek V4-Flash 差距更大,¥0.02 对 ¥1,差 50 倍。这意味着能不能复用固定前缀,是成本优化的关键:把 System Prompt、少样本示例这些每次都一样的内容固定放在请求最前面,让它们稳定命中缓存,能有效减少成本。
从表中,我们还发现价格跨度也很大。 拿最贵的 Kimi K3(输出 ¥100/百万)和最便宜的 DeepSeek V4-Flash(输出 ¥2/百万)一比,差 50 倍。所以千万别养成「默认上最强模型」的习惯,否则成本会高得离谱。
除此之外,对于有些模型,价格还可能和调用时间有关。DeepSeek 就采用了峰谷计价:北京时间周一到周五的 9:00–12:00 和 14:00–18:00 算高峰,其余时间算空闲,空闲价是高峰价的一半。那些能容忍延迟的离线任务,比如批量数据清洗、跑评测集,放到夜里或周末运行,成本可以直接减半。
六、开源还是闭源
这是个很常见的场景:领导拍板说「客户数据绝对不能出内网,用开源模型自己部署吧,DeepSeek、Kimi 不都开源了吗」。
听着天经地义,当我们真去做时,才发现,这句话里藏着两个误会。
第一个误会:这个「开源」不是你熟悉的那个开源。 国内常说的开源模型,准确讲绝大多数是开放权重(Open Weights)。厂商把训练好的权重文件公开给你下载和商用,所谓权重就是上一篇讲的那几千亿个参数值,但训练数据和完整训练代码通常不公开。换句话说,你拿到的是编译好的成品,而不是源码。
眼下的格局是:国外三巨头全部闭源,GPT、Claude、Gemini 只能调 API;国内主力大多开放权重,DeepSeek V4 系列以 MIT 协议开源,Kimi K3 在 2026 年 7 月开源,Qwen 和 GLM 也都有开放权重版本。
第二个误会更致命:能下载不等于跑得起。 用上上一篇的显存估算算笔账。Kimi K3 总参数 2.8T,光装权重就要约 5.6TB 显存;Qwen3.8-Max 的 2.4T参数 约需 4.8TB显存。这已经不是买两张卡的事,是要搭一个集群,而且还没算 KV Cache 的开销。真想自己部署,实际点的选择是那些参数量适中的小模型。
所以对业务开发者来说,真正要做的决策从来不是「开源还是闭源」,而是在下面三条路里做选型:
- 调厂商 API:最省事,按量付费,零运维,但数据有隐私问题,价格和可用性都受制于人。
- 调第三方托管的开放权重模型:云厂商替你托管 DeepSeek、Qwen 这些,你还是调 API,价格通常更低,但机器成本高!
- 自己部署:完全可控,但硬件、运维、调优的成本全得自己来搞定。
对于绝大多数业务场景,第一条路就已经足够了。除非数据合规上绝对不能出内网;调用量大到 API 账单显著超过机器成本;需要用自己的数据做微调,这个时候才考虑另外两条路线。
本篇小结